· 47 min read
论文解读:Neural Networks Are Already Clean,可解释性不需要先「解开结」
TL;DR 这是 Nick Cammarata 写的一篇 65 分钟交互式研究长文[1]。核心论点很激进:领域里用来论证「神经元多义性 / 叠加(superposition)」的经典证据——尤其是 InceptionV1 那个著名的「猫 + 车」神经元——被误读了;大部分多义性不是网络在任意打包无关特征,而是一个普通的泛化现象:递归泛化(recursive generalization)——神经元沿一个方向泛化,再沿分支长出子分支,看起来就像「一个神经元干很多不相关的事」。作者的证据链包括:InceptionV1 的
4e:55其实是共享 V 形的泛化;换用现代架构后最后一层 99–100% 的神经元容易解释;把 InceptionV1 的 3b 层从 480 个神经元压到 10 个,只看到概念变粗、没看到叠加;Qwen3-32B 上约 90% 的神经元极点只有一个主职、7% 有两个相关职责、只有 2–4% 没被理解;GPT-2 XL 的可解释比例从当年不到 2% 提到约 70%;甚至在万亿参数的 Kimi K3 上也能给出可读的 attribution graph。结论是:网络本身就是「可读的」,可解释性应该像普通科学一样直接研究它,而不是先训练一个 SAE 把网络「解开」再研究。原文有 25+ 个交互图表;我在下面重做了其中 3 个最核心的机制(V 形、递归泛化、弱激活),全部用博客原生组件实现,不引入外部依赖。
- 原文:Neural Networks Are Already Clean,Nick Cammarata(Goodfire),2026;贡献者:Curt Tigges(语言模型神经元研究)、Tarun Gogineni(编辑)。文字版:essay.md;PDF。
- 引用格式:Cammarata, N., 2026. Neural Networks Are Already Clean. Goodfire.
- 站内相关:这篇讨论的「注意力把信息存在标点上」「用 attribution graph 读电路」可以和 Transformer 交互解读 对照看;如果你更关心「世界模型怎么用」,可以看 OpenWAM 解读 和 世界模型综述解读。
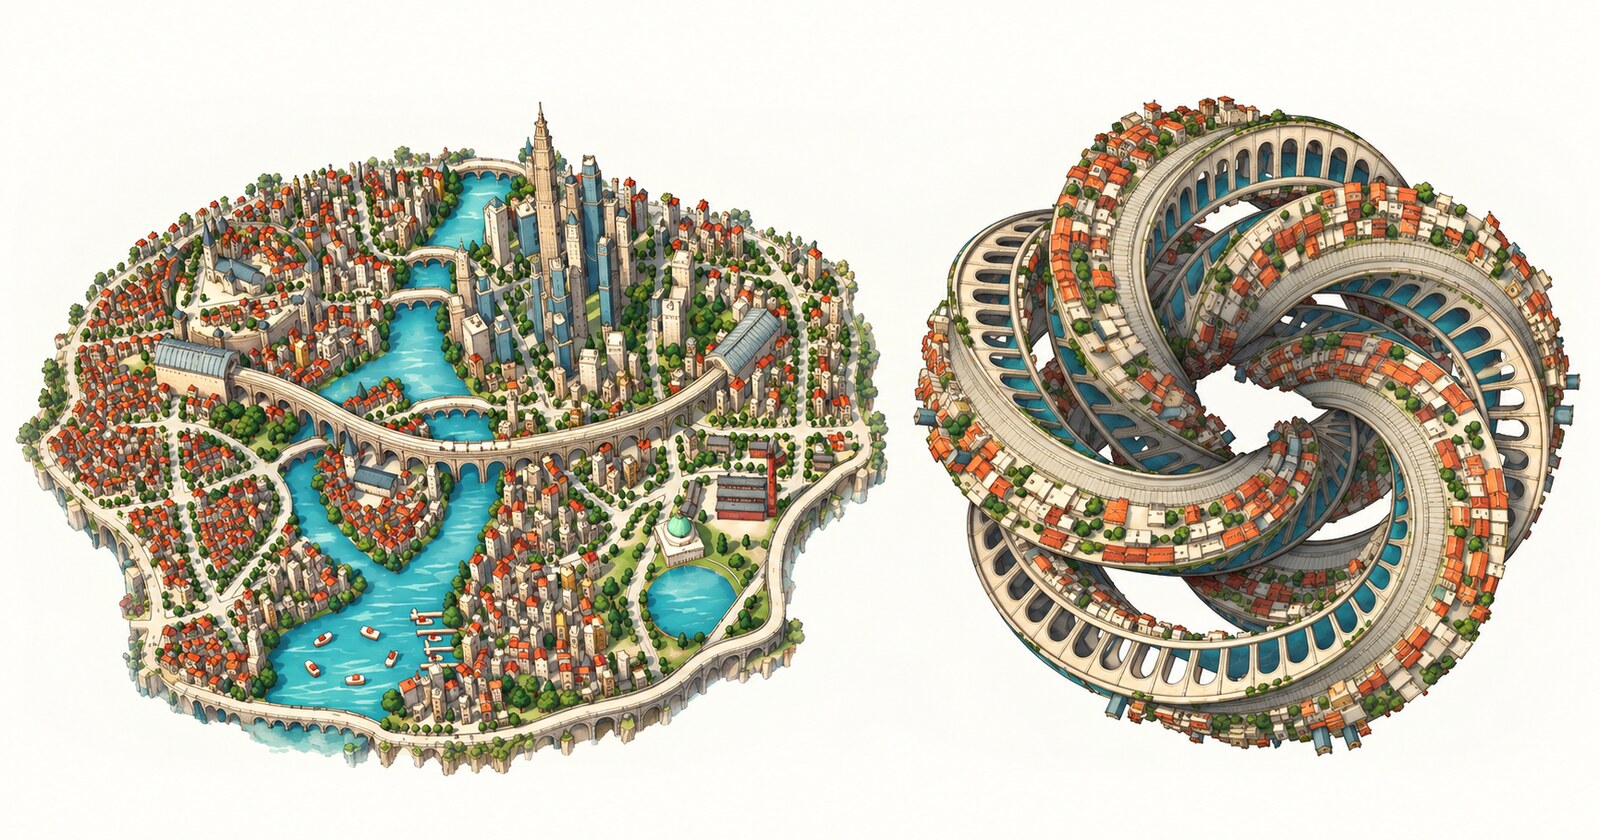 题图(Goodfire 原文配图,作者 Nick Cammarata):城市 vs 结。原文用这个比喻说「网络看起来像一团结,可能只是我们没找到读它的方式」——不是网络被缠住了,而是我们还没学会怎么读一座城市。
一、先给结论:这是一篇「反叠加」的可解释性檄文
作者 Nick Cammarata 不是路人:他是 Distill 上 Feature Visualization、Zoom In、Multimodal Neurons、Curve Detectors[2] 等一系列机制可解释性工作的作者之一,2019 年发现后来被叫作「叠加」的那个经典电路的人也是他。这篇文章最有趣的地方在于——他公开推翻了自己参与建立的解释。
文章的主张可以拆成四步:
- 网络只有一个学习原则(泛化),不是两个(泛化 + 叠加);所谓叠加,是把「普通泛化造成的局部多义」误读成了「任意打包无关特征」。
- 在现代模型和现代工具下,对网络做普通科学(观察、假设、干预、检验)是可行的,而且效果比领域预期的好。
- 理解会复利:理解一个神经元会约束周围神经元和电路的解释,像填字游戏一样越填越快。
- 高度推测:这可能就是可解释性所需要的大部分东西;可解释性也许比领域以为的更接近可解决——「可解释性的 bitter lesson:在规模上做普通研究,胜过设计聪明的分解方法」。
这不是一篇同行评审论文,而是一篇工作假设(working hypothesis)+ 研究纲领。页面本身就是论证的一部分:它用 25 个以上的交互图表让你自己动手看 V 字、看神经元随训练生长、看弱激活被砍掉之后还剩什么。作者也把配套的技术论文留作后续(语言模型神经元的详细实验)。
读这篇要区分两件事:证据(大量可复现的案例和测量)和主张(「already clean」这个强标题)。前者很有价值,后者是作者自己承认的、尚未完全审计的假设。下面按文章的论证顺序拆。
二、两种解释,方向相反
先看被挑战的解释。叠加(superposition) 的经典版本是:网络需要的特征比神经元多,于是它把「不相关」的特征塞进同一个神经元——因为它们很少同时激活,所以不会互相干扰。按这个逻辑,一个神经元可能同时是「软耳狗」和「拉丁诗歌」,两者毫无关系,只是碰巧不冲突。
作者把它和泛化(generalization) 对照:
| 泛化 | 叠加 | |
|---|---|---|
| 分组依据 | 共享的模式(相似的东西放一起) | 不相关(只因为不干扰) |
| 分组位置 | 局部:相似的东西在附近 | 非局部:越不相关越适合放一起 |
| 一个被压小的网络会怎样 | 概念变粗(车 → 交通工具) | 出现不相关的混合(狗 + 拉丁诗) |
| 对可解释性的含义 | 分组本身是线索,能学到网络怎么想 | 分组没有信息,必须先解开 |
| 怎么验证 | 看神经元随训练怎么长、做干预 | 只能靠「解释不了」这个症状 |
这个对比的关键在于两者预测几乎相反,而且可以观察:如果网络是叠加的,那么把一个层压小(比如把 480 个神经元压到 10 个)应该会看到「不相关的东西挤在一起」;如果网络是泛化的,只会看到概念变粗。作者后面正是用这个实验来判决。
三、猫/车神经元:一个 V 字
这是全文最漂亮的案例,也是整个领域最著名的「多义神经元」:InceptionV1[3] 的 4e:55,看起来同时响应猫脸和汽车前部。从 2017 年的 Feature Visualization[4] 到 2020 年的 Zoom In[5],它一直被当作「神经元不是好单位」的证据——Zoom In 甚至明确写过它「不是在响应猫和车的某种共同点」。
作者重新打开那张看了几百遍的猫/车图片网格,问了自己一个以前没问过的问题:如果只能用「一个东西」来描述它,那是什么? 答案几乎是瞬间出现的:V 形(或双侧尖形)。猫和狐狸的尖脸、汽车前部的 V 形引擎盖、V 形的火焰、消防船喷出的 V 形水柱、台球桌的三角框、新干线的车头……都共享这个形状。它的负极点是一个 O 形——圆的东西把它压下去,尖的东西把它推上去。
进一步看电路:它连接的上游是猫、狐狸、汽车的检测器,但它把这些检测器聚在一起的原因是共享的 V 形;这不是「把车藏进狗神经元的高维空间里」,而是「泛化 + 构图」:它把共享形状的东西放在一起,好让下游的读者继续用。作者推测,视觉模型里可能有上百个这种广义姿态(generalized pose)神经元,只是以前没人注意到;在比 InceptionV1 大十倍、晚了近十年的 DINOv2 里,这类神经元依然存在。
还有一个方法论上的坑:深层 feature visualization 会被reward hacking。优化器想找「让神经元最大激活的图」,但它会走最省力的路径——InceptionV1 训练数据里狗很多、狗神经元也很多,于是优化很容易掉进狗的画法里。把可视化稍微偏向自然图像的路径,最能激活 4e:55 的就变成了车,以及同时有狗和车的图(因为共享姿态)。也就是说,我们看到的「混乱」有一部分是显微镜的错。
作者由此提出一个很实用的判断法:如果一个神经元看起来多义,先别用名词列表描述它;问自己「如果不能用名词,我会怎么描述它?」 多数时候一个共享模式会跳出来(V、姿态、方向、句法角色……)。他说,神经元更像动词或门(gate),而不是名词:它的工作不是给输入命名,而是在正负极之间做一个区分,把激活流向不同的下游。
下面这个部件把「语义读法」和「形状读法」放在一起。点按钮切换,看同一组东西是怎么被一个 V 串起来的:
这个案例的意义不只是「一个神经元被解释清楚了」。它说明:多义性的描述本身可能是错的。用名词列表描述一个共享模式,当然会得到一个多义神经元;换一个描述层次(形状、姿态、句法角色),它可能就是一个干净的单义检测器。作者认为这是中层神经元里「被误判的多义性」最大的来源。
四、显微镜的错误:网络和工具都需要调
作者把可解释性的历史概括成一句话:我们一次次发现,显微镜下的东西比我们以为的好;只是显微镜没调对,而且调的地方往往很微妙。
最早的 feature visualization[4](把神经元最响应的图像用梯度上升画出来的「迷幻图」)一开始也很糊。后来研究者补上变换鲁棒性(对平移、旋转、尺度等做正则),同样的神经元立刻变清晰。到了更深的层,可视化又坏了两个原因:一是上一节说的 reward hacking,二是正则化设置不够对。修好之后,同样的神经元能看清到深得多的层。
但问题不只在工具。InceptionV1[3] 的最后一层当年确实几乎不可解释,有人估计接近 0%,作者自己估计 5%。后来他们用同样的参数量、同样的数据集,但加上 residual、LayerNorm 等现代改进重训,最后一层就变得非常干净。数字很能说明问题:
- 2014 年的原模型 + 当年的工具:约 5% 可解释;
- 同一模型 + 更好的工具(修好的 feature visualization、attribution 可视化等):约 50%;
- 同样的架构 + 更合理的现代正则重训:约 70%;
- 同尺寸的 ConvNeXt:约 99%。
所以「网络本身不可解释」这个结论,至少有一部分是模型没训好 + 显微镜没调好造成的。作者还训练了三个相差约 300× 的 ConvNeXt(92K、7.06M、28.6M 参数)来观察规模效应:在小模型里神经元更「粗」(一个神经元覆盖更宽的概念),大模型里更窄;但无论大小,神经元都保持可解释。这直接挑战了「模型越大、叠加越严重」的直觉——至少在他们的视觉模型里,规模帮助了可解释性,而不是相反。
这一节的方法论含义是:当你看到一个「多义神经元」,先别急着宣布网络在叠加;先问是不是工具、架构、训练数据或观察层的问题。 作者说,他后来遇到的多义案例里,大多数都能被这四个原因之一消解。
五、递归泛化:泛化是分形的
如果说第四节回答「为什么以前看起来乱」,第五节回答「那些多义性到底在干什么」。
作者重新训练 InceptionV1,并在训练过程中观察一个神经元的形成。它一开始只对黄色的花(油菜花田)有反应;然后沿着照片里的其他侧面长:其他自然景物、绿色的球状物、后来是狗;再后来继续长,直到「花田」几乎消失。ConvNeXt 上也能看到同样的生长,只是走得没那么远。
这被命名为递归泛化(recursive generalization):一个神经元先沿一个轴泛化,然后从这些点上再长出分支,分支再长分支。它不是「第二种学习原则」,就是普通泛化在多个方向上的叠加——只不过泛化是分形的,所以长到最后看起来像「一个神经元干很多不相关的事」。
最清楚的例子来自语言模型:一个对 "iy" 敏感的神经元,先响应 Miyazaki 里的 iy,然后长出 "diy",再长出 "do it yourself"——后者已经完全不含 iy 了。类似的还有「地质学神经元」长到 Cesium(一个地质学 JavaScript 库),「敌人神经元」长到一首关于敌人的俄语诗。这些分支大多又轻又小,而且和主职相关;作者认为,把它们叫「多义」会掩盖一个事实:它们讲述的是网络如何一步步建立概念的故事。
Multimodal Neurons[6] 里其实早就描述过类似现象(当时叫 conjoined features),只是没人提出它可能是 InceptionV1 最后一层混乱的一般解释——因为那时候没有 checkpoint,看不到神经元怎么长。
下面这个部件把「iy 神经元」的生长过程做成时间轴。拖动滑块看分支怎么长出来,注意最后那个分支已经和 iy 没关系了:
这个机制解释了为什么「跟着噪声走」是有回报的:如果多义性来自递归泛化,那些看起来奇怪的分支其实带着关于网络如何组织概念的信息;如果来自叠加,分支之间就没有可学的结构。作者反复强调,这个区别决定了可解释性应该「继续读网络」还是「先把网络拆开」。
六、叠加为什么被高估:从「空白处的解释」说起
第六节是全文火药味最重的部分。作者复盘了「叠加」是怎么成为默认解释的:
- 2019 年他发现的电路:一个「车」特征似乎流进了一堆「狗」神经元。当时他和 Chris Olah 把它理解为「把车藏进高维空间里,下游需要时再读出来」,于是有了叠加式解释。后来发现真相是共享姿态:车和狗因为朝向相同被组合在一起,视觉模型里有上百个这种 generalized pose 神经元。
- Zoom In[5] 把「特征」引入电路研究,也把叠加从「向量相加」扩展成「网络的学习原则」;此后 SAE/字典学习路线兴起(Towards Monosemanticity[7] 是最有影响力的代表),目标变成「先把网络分解成可解释特征,再研究」。
- 2022 年 SoLU 论文其实写过一句很诚实的话(本轮综述里也提到,叠加在玩具模型里确实会出现[8],但真实网络是另一回事):「在机制可解释性社区,叠加经常被当作默认假设,只是因为它直觉上更吸引人,但证据很少。」作者说,据他所知,自他那个(后来被证明是误读的)电路之后,没有人在真实网络里找到过第二个正确的叠加电路。
他把「看起来多义」的原因列成五类,并给了一个很好用的诊断顺序:
| 可能原因 | 怎么检验 |
|---|---|
| 工具不好(可视化被 reward hacking、分辨率/正则不对) | 换更好的工具,看神经元是否变干净 |
| 解释不好(用错了描述层次,比如只用名词) | 换描述(形状/姿态/句法角色)再试 |
| 学习不好(架构/数据/正则有问题) | 用现代架构重训同一任务,看是否变干净 |
| 递归泛化(泛化长出了分支) | 有 checkpoint 就观察它怎么长 |
| 叠加(任意打包无关特征) | 最后才考虑;它唯一的症状是「解释不了」 |
作者讲了一个自己经历的例子:在语言模型里看到一个神经元,主要响应 pr,还响应一堆 Base64 URL 字符串和孟加拉语。他以为终于抓到一个「任意混合」了;结果把 URL 解码,都是 pr 开头的词;把孟加拉语转写出来,也是 pr。还有一个被自动解释工具标成「多义逗号神经元」的 Qwen 神经元,仔细看是一个科罗拉多(Colorado)神经元:电话号码、本地俚语、相关神经元都指向科罗拉多,逗号只是注意力存放「当前上下文摘要」的位置。再比如长上下文神经元,早期只看两段文本时看起来乱七八糟,把上下文拉长就清楚了。
所以他的核心批评是统计功效和假设顺序的问题:叠加被当成了零假设(null hypothesis),而它其实应该是最后一个假设——因为它最激进、最难证伪,而且它的唯一证据是「我解释不了」。而「解释不了」也可能是工具、学习、递归泛化或数据覆盖的问题,这些都可以主动检验。作者甚至说,自己当年是「叠加的坚定信徒」,把太多反例解释掉了。
这一节还回应了两个常见反驳:
- 「特征比维度多」不等于叠加。 一个完全单义的网络也满足「特征数 > 维度数」,因为它会组合。真正的问题是「神经元把无关的东西放在一起」这个学习原则,而不是线性代数意义上的「超完备」。
- 「弱激活里藏着特征」 是叠加最后的避难所。作者用后面的弱激活实验和归因图来反驳(见第八节)。
到这里,文章的论证结构已经很清楚了:先把「多义」拆成五类原因,再把叠加从默认假设降级为最后假设,然后用视觉和语言模型的系统实验逐一排除前四类。
七、图像模型上的系统证据
前面大多是案例,第七节开始上系统实验。作者选择视觉模型,理由很直接:它们小、能看清、有 feature visualization 这种好用的工具;而原始担忧正是从视觉模型来的。
他训练了三个 ConvNeXt,参数量相差约 300×(92K / 7.06M / 28.6M),再加上 InceptionV1 作为历史对照。核心实验是压小再重训:
- 把 InceptionV1 的 3b 层(就是 Curve Neurons、High-Low Frequency 那个层)从 480 个神经元压到 10 个,而且这个模型没有 residual stream,神经元没法「绕过去」,相当于把容量压掉 48 倍;
- 如果网络切换到叠加,应该能看到「曲线 + 橙色螺旋 + 蜘蛛网」这种不相关混合;实际看到的是概念变粗:一个「曲线与环」神经元代替了十种曲线检测器,两个圆检测器代替了多种圆;
- 再在这个压扁的层上训练 SAE,希望把「藏起来的曲线」找回来——没有找到(这也回应了 Missing Curve Detectors[9] 那类「SAE 发现了神经元缺失的曲线」的观察:作者检查后发现,SAE 的曲线大多由已有曲线神经元组合而成)。SAE 的特征是宽而挤的,不像原始曲线神经元;
- 在 7M 的 ConvNeXt 上做同样的事(最后一层 1024→13,并阻止 residual 旁路),结果一样:变粗,不变叠加。
这组实验是全文对叠加最直接的反驳:如果容量不足会让网络切换到叠加,那么在极端压小的层上应该最容易看到;但看到的是泛化变粗。
第七节还检查了「字典(SAE)会不会找到神经元没有的基本构件」:
- 在最后一层,约 88% 的 SAE 活动是单个神经元的近似复制;把「匹配不到任何神经元」的字典方向删掉,准确率基本不变;少数会翻转的答案本来也就是近似平局;
- 如果在一层里搜索「让少数几个单元承载最多活动」的旋转,从随机旋转出发,最后会回到神经元本身——每个 block 都如此;
- SAE 额外找到的东西,多是已有神经元按上下文的松散组合(比如「水面上的动物」「苍白块状食物」),没有看到「神经元完全缺失的基本构件」。作者的态度是:SAE 对「图里有什么」有帮助(尤其在小模型),但在「理解网络」这件事上,他没看到 SAE 抓住神经元没抓住的根本结构。
还有一个很关键的「稀有/记忆」实验:稀有类往往更集中(ImageNet 需要很多狗的模式,但一个三角龙神经元就够了);删掉弱激活后没有哪个类特别受损;对抗样本走的是普通语义电路;把随机噪声映射到随机标签的模型,也部分依赖纹理。最漂亮的是「把雨伞照片教成蜜蜂」:模型没有长出一个与世隔绝的隐藏特征,而是在 9 步内把雨伞路由切换到已有的蜜蜂电路上,几乎全部变化发生在最后三个 block;把这三个 block 换回原模型,它就改说「蜜蜂」了。也就是说,记忆也倾向于复用已有的、可读的电路,而不是造一个不可读的暗格。
这些结果合起来给出的图像是:视觉模型里,神经元是「控制流」——正极放行某类模式,负极挡住相邻但不需要的模式;层与层之间在细化区分(出租车和救护车、西兰花和花椰菜、琵鹭和火烈鸟);容量不足时概念变粗;没有看到「不相关特征被任意塞在一起」的系统证据。
八、语言模型上的系统证据
语言模型更难:没有 feature visualization,attention 混杂多种机制,规模巨大。但作者(与 Curt Tigges 合作)还是把同样的故事搬了过去。
神经元层面的统计。 在 Qwen3-32B 上做初步审计:约 90% 的神经元极点只有一个主职(常带小的相关分支),约 7% 有两个相关职责,只有 2–4% 尚未理解。这个数字对阈值、深度、弱激活的判定方式敏感(作者在脚注里专门讨论),但他认为「绝大多数神经元有可读的主职」是稳的。对 GPT-2 XL 的回看更有意思:当年自动可解释性项目里不到 2% 的神经元算「干净」;用现在的工具重做 500 个 neuron papers,约 70% 看起来像一个主职, pristine 的约 5%,剩下的多是两三个相关职责——而 GPT-2 XL 并不是一个「现代架构」的模型。
万亿参数也能读。 他们给出了 Kimi K3(万亿参数级)的 attribution graph:问模型「捡到一个钱包怎么办」,它把钱包、现金、失主 ID 连到「失物招领/诚实」,回答「归还」。作者说,据他们所知这是首个公开的万亿参数模型的归因图;当然,这只是一个图,全面的规模审计还没开始。
架构带来的假象:SwiGLU 的双负号。 现代 Transformer 的神经元有 gate 和 value 两个数,输出是二者相乘。当两个都是负数时,乘积为正——于是一个神经元可以因为「负 × 负」而放电,看起来像它的负极点。作者估计约 4% 的神经元,这种「回声」会占据最响应的顶部;在整个网络上把这些激活去掉,多数 benchmark 反而涨,但一些推理任务会掉。他猜这背后是一个用这种激活来「多想几步」的神经元,但没深挖,并向架构设计者喊话:值得修。
弱激活。 这是叠加最后的藏身之处,也是作者最想拆掉的地方。他们的观察是:
- 让 1 亿个 token 通过一个 Qwen3-32B 神经元,绝大多数激活都贴近零,只有约 160 个能进入「强的一半」;
- 把整个网络的弱激活几乎全砍掉,成本很小;损失最大的地方反而是最容易理解的(语言模型最后一层常用「说 or 只想」来抑制单个 token;视觉模型早期层像旋钮);
- 被砍掉的通常是「网络本来就在犹豫的两个答案之间的细微差别」,而不是「隐藏的无关特征」;
- 真正强但不到极端的激活,会沿语义向外辐射:CLIP 的 Trump 神经元从特朗普本人,到艺术和与他相关的人,再到 Fox News 演播室——越往外越容易误判,但通常还能沿电路追回去。
下面这个部件把「保留多少弱激活」做成滑块。条形是模拟的激活分布,数字锚定论文里 InceptionV1 的真实实验:
注意力。 作者对 attention 的进展最保守(他也回应了 Anthropic 关于 attention superposition 的短记[10],认为这更像是术语问题:还没人把 attention head 理解到能判断「它是不是另一种叠加」的程度):他说自己不确定有没有人真正理解 attention,因此也不认为「attention 的不可解释性 = 另一种叠加」。但可做的部分不少:注意力看哪里(where)几乎免费,已经能说明很多;它找什么、找到后做什么,可以用神经元来读。比如子痫前期(preeclampsia)的例子:三个第 30 层的 head 从 residual stream 里读到头痛、偏头痛、大脑三个神经元,把信息写到逗号位置的 preeclampsia 神经元上;把这些 head 敲掉,preeclampsia 掉四分之一,但阻止它们看「疼痛」相关的词则没有变化。更一般的「摘要模因(summary motif)」是:注意力喜欢把上下文摘要放在标点(逗号等)上,这解释了很多看似奇怪的逗号神经元。
他们重访了 Finding Neurons in a Haystack[11] 里那个著名的「Social Security」三神经元方向:那个方向其实不被网络使用;真正被使用的是普通的词、名字、短语续写神经元,通过泛化和组合实现检测。
残差流。 原文专门讨论了 residual stream:担心它不是「特征比维度多」,而是连续的「流形互相编织」,即一种连续的打包。作者的态度是:完全排除不可能,但实践中它不是瓶颈——他们能读神经元往流里写了什么、从流里读了什么,attribution graph 也干净;在视觉模型里,多年的可视化问题其实是一个「不被读取的显著维度」造成的(网络把大部分激活质量放在一个未读取的维度上,用来通过 LayerNorm 缩放其他维度),把它拿掉地图就清楚了。把 7M ConvNeXt 的 residual stream 压窄 4 倍/8 倍(最后一层只剩 46 维)后,准确率从 72% 掉到 60%/39%,但地图只是更糊,没有出现「巧妙交织」。他们也提到 Block Sparse Featurizer[12] 这类连续子流形表示是更自然的方向。
归因图与解释的检验。 他们让 agent 审了 10 万张 attribution graph[13],作者自己也看了几千张;绝大多数异常最后都是他没认出的模因。医学诊断的 hub 只有 4 个神经元;圣诞老人的例子更精彩:标准 top-k 自动解释会把某些神经元标成「首都城市」,因为工具忽略了负极点对应的 Santa lore;把 8 个「负极点 = Santa」的神经元去掉,Santa 的概率从接近确定掉到 6%,而把 20 个「标签里就有圣诞/圣诞老人」的神经元去掉,只掉到 76%。他们还做了 near-miss 测试:200 个随机神经元,agent 只看解释,写出 5 个应该强烈激活的例子和 5 个不该激活的近似例子;在 183 个解释描述了正极的神经元里,新例子强烈激活神经元的比例约 76%——解释是「会输的」,不是万能的。
| 证据 | 关键数字 / 观察 |
|---|---|
InceptionV1 4e:55 | 猫/车共享 V 形;负极点 O;还连接 V 形火焰、V 形水柱、狐狸尖脸 |
| InceptionV1 最后一层可解释比例 | 旧工具约 5% → 更好工具约 50% → 现代正则重训约 70% → 同尺寸 ConvNeXt 约 99% |
| 3b 层 480 → 10 神经元 | 概念变粗(「曲线与环」),没有不相关混合;SAE 也没找回原始曲线神经元 |
| ConvNeXt 规模 | 92K / 7.06M / 28.6M,约 300×,各尺度神经元都保持可读 |
| SAE / 字典 | 最后一层约 88% 活动是单神经元近似副本;删掉非匹配方向准确率几乎不变 |
| Qwen3-32B | 约 90% 神经元一个主职、约 7% 两个相关职责、2–4% 未理解 |
| GPT-2 XL | 旧工具 <2% → 新工具约 70% 像一个主职(pristine 约 5%) |
| Kimi K3 | 万亿参数模型的第一个公开可读归因图(捡钱包 → 归还) |
| SwiGLU 双负号 | 约 4% 神经元的顶部响应受「负 × 负」回声影响;去掉后多数 benchmark 涨、部分推理任务掉 |
| 弱激活 | 只保留最强约 1/4 正激活,InceptionV1 top-1 从 70.08% 到 69.47% |
| near-miss 解释测试 | 183 个可解释神经元中,76% 的新例子能强烈激活对应神经元 |
九、Zooming Out:什么叫「干净」
第九节把整篇文章的哲学讲清楚了。作者说的「clean」不是「每个神经元单义」——虽然按那个标准他也认为比领域预期好得多。他说的是一种更深的东西:网络的部件是「为被读而建」的,也是为下游读者而建的。 用他的比喻:网络几乎是一个分形的解释结构,宏观上有机制,微观上有递归泛化;可解释性的目标是成为网络的另一个读者。
这带来两个重要转向:
- 从枚举式可解释性到探索式可解释性。 前者想要一张完整特征清单来做审计,担心维度爆炸;后者从问题出发,像 Google Maps 一样在 attribution graph、神经元、attention head 之间缩放,边走边发现新问题。作者认为探索式路线更可行,也更抗多义性——你不需要先证明网络是单义的,才能开始理解它。
- 从「单义性」到「模因(motifs)」。 如果按一个按钮能让所有神经元变单义,或者让你理解几个真正关心的问题背后的电路模因,作者会选后者。可解释性的产出不是词典,而是「城市的地图」:你可以不知道每条街,但知道怎么从问题走到答案。
为什么会这样组织?作者给了一个很简洁的猜测:电路生态 / 电路竞速(circuit ecology / circuit racing)。一个区域一旦有了有用的部件和读者,它学下一个相关概念就比从零开始快,于是它先拿到误差信号,长成新的分支;这解释了为什么概念会像树一样长在一起,而不是随机分布。他还做了一个「整网竞速」实验:让一个预训练好的模型和一个空白模型共享目标,预训练模型几乎拿走全部「功劳」,空白模型学不到东西。换句话说,网络的「干净」可能不是巧合,而是训练动力学的一种自然结果:用已有的路更快。
这也能解释「为什么泛化会赢」:网络一次只看一个样本、一个小 batch,从没见过「一组狗」;它本来完全可以记住每一个样本,但共享模式能同时降低很多样本的损失,所以在误差信号里先被找到。作者在「Why Networks Generalize」一节里把这些线索拼在一起:泛化、组合、误差信号,加上电路生态的正反馈,足以解释为什么网络会形成局部、有序、可被下游读取的结构。
他用城市 vs 结的比喻收束全文:在纽约找金融区一分钟就能找到;在小镇里「金融区」这个概念根本不存在。模型越大,地图反而越好用(他们在大 ConvNeXt 里让 agent 找 dog-ear 神经元,比小模型更快;原文的 ConvNeXt atlas 受 Activation Atlas[14] 启发)。所以「网络很大」不等于「网络很难读」。真正的风险不是「隐藏的激活」,而是「就在明处、但我们不会读」——就像一座组织良好的城市,外来者不知道怎么理解它。
最后是「可解释性的 bitter lesson」[15]:深度学习的历史反复证明,简单的办法 + 规模会赢过精巧的设计;可解释性可能也一样——与其设计更聪明的分解目标,不如在规模上做普通科学,用大量 agent 去观察、假设、干预、检验。作者甚至给出了一个乐观的图景:网络已经为「被读」做好了大部分准备,我们只需要成为它的读者。
十、局限与争议
作者在附录里相当坦诚,列了不少反例和未解问题;我在这里分开写「作者承认的」和「我自己补的」。
作者承认的:
- 没有全面审计。 他明确说没有审计每一个网络,甚至不知道理论上是否可能;「already clean」是一个 change of kind 的强主张,但他给的证据主要是案例和抽样。
- 递归泛化难以系统性变化。 他们没有彻底证明「所有严重的多义性都是递归泛化」;在完成的模型里看不到生长过程,在大语言模型里也缺少 checkpoint 去观察。
- 注意力还没被理解。 他不认为 attention 的不可解释性可以归因于叠加,但也没有给出 attention 的完整解释。
- 规模与叠加的关系仍开放。 他们比较确信自己研究的视觉模型没有叠加,但万亿参数模型是否可能有,仍是一个开放问题;Kimi K3 只给了一个归因图。
- 特征的定义有歧义。 文章专门讨论了「feature」可以指人关心的东西、网络学到的构件、或二者的混合;这也是他觉得「特征清单」路线别扭的原因。
- 反面证据。 附录里有 unresolved responses(比如一个收集「捏紧中心形状」的神经元,同时带有语义残留),以及 meta-models、probes、attention superposition 等替代路线的讨论。
我自己补的:
- 证据来源集中。 大量结果来自作者团队自己的工具、自家训练的模型和自家挑选的案例;独立复现(尤其是「90% 神经元只有一个主职」这类统计)需要第三方用不同工具和阈值重做。
- 指标是半定性的。 「可解释」的判断依赖人工/agent 的评分,「90%」对阈值敏感(作者脚注也承认);这和 SAE 社区的自动化指标不是同一套尺子,跨研究比较要小心。
- 强标题 vs 工作假设。 「already clean」是个很好的传播标题,但作者的证据更支持「比想象中干净得多,而且有很多可操作的下一步」;把后者当成定论会过度外推。
- 与 SAE 路线的张力。 作者说 SAE 会把 V 拆成「猫特征 + 车特征」,离神经元真正做的事更远;但 SAE 支持者可以说「单义性本来就不是目标,分解是为了可控编辑」。这是路线之争,不是简单的对错。
- 交互叙事的影响。 这篇文章的交互设计非常有说服力(你亲手拖出 V、看神经元生长);但阅读体验本身也是论证的一部分,容易让人高估证据强度。读 text version 会有不同感受,建议两种都看。
- 安全含义需要更谨慎。 作者乐观地认为「欺骗会藏在明处、成为读者就能看见」;但如果读网络需要大量专业判断和 agent 工具,误读的代价可能很高。他的「不对称错误」论证(假设干净 vs 假设脏)很有道理,但并不能保证读者一定读对。
十一、结论:可以带走的三件事
- 先别把「解释不了」当成「叠加」。 工具、架构、描述层次、数据覆盖、递归泛化,任何一个都能制造多义性;叠加应该是最后一个假设,而不是默认假设。
- 跟着噪声走。 如果多义性来自递归泛化,那些奇怪的分支就是网络如何组织概念的线索;如果来自叠加,分支之间没有可学的结构。这个区别决定了可解释性的方法论。
- 可解释性可能是「成为读者」,而不是「造一把更好的刀」。 网络已经为下游读者准备了可读的结构;探索式、多尺度、agent 驱动的普通科学,可能比精巧的分解目标更接近答案。
怎么读原文。 原文是交互式的,最好的路径是:
- 先读 The Short Version(全文论点浓缩);
- 再读 Cars and Animals(V 形案例,全文的钩子);
- 然后 Recursive Generalization 和 Superposition of the Gaps(核心机制与对叠加的反驳);
- 最后 Zooming Out(哲学与方法论);附录按兴趣挑:SwiGLU、弱激活、残差流、attention、counterevidence、meta-models。
- 交互部分至少亲手玩三个:V 形图片网格、神经元生长动画、neuron gallery / microscope。原文顶部的「65-minute read」不是玩笑,建议分两次读。
本文的三个部件是对原文机制的概念性重实现(不是原始数据,也不复制原文代码/CSS),目的是让中文读者在博客里也能动手理解;完整的交互体验、真实图片网格和 25+ 个图表请回原文体验。
参考
- Cammarata. Neural Networks Are Already Clean. Goodfire, 2026. 原文
- Cammarata, Goh, Carter, et al. Curve Detectors. Distill, 2020. Distill
- Szegedy, Liu, Jia, et al. Going Deeper with Convolutions. CVPR 2015. arXiv
- Olah, Mordvintsev, Schubert. Feature Visualization. Distill, 2017. Distill
- Olah, Cammarata, Schubert, et al. Zoom In: An Introduction to Circuits. Distill, 2020. Distill
- Goh, Cammarata, Voss, et al. Multimodal Neurons in Artificial Neural Networks. Distill, 2021. Distill
- Bricken, Templeton, Batson, et al. Towards Monosemanticity: Decomposing Language Models With Dictionary Learning. Transformer Circuits Thread, 2023. Transformer Circuits
- Elhage, Hume, Olsson, et al. Toy Models of Superposition. Transformer Circuits Thread, 2022. Transformer Circuits
- Gorton. The Missing Curve Detectors of InceptionV1: Applying Sparse Autoencoders to InceptionV1 Early Vision. arXiv 2406.03662, 2024. arXiv
- Jermyn, Lindsey, Luger, et al. Progress on Attention. Transformer Circuits Thread, 2025. Transformer Circuits
- Gurnee, Nanda, Pauly, et al. Finding Neurons in a Haystack: Case Studies with Sparse Probing. arXiv 2305.01610, 2023. arXiv
- Fel, Kowal, Jacobs, et al. Uncovering Neural Geometry in Vision Models With Block-Sparse Featurizers. Goodfire, 2026. Goodfire
- Lindsey, Batson, et al. On the Biology of a Large Language Model. Transformer Circuits Thread, 2025. Transformer Circuits
- Carter, Armstrong, Schubert, et al. Activation Atlas. Distill, 2019. Distill
- Sutton. The Bitter Lesson. Incomplete Ideas, 2019. 原文