· 67 min read
论文解读:BEVFusion,在鸟瞰图空间里做多任务多传感器融合
TL;DR BEVFusion 是 MIT 韩松组提出的相机 + LiDAR 融合框架[1]。此前的主流做法是「点级融合」:把相机特征贴到 LiDAR 点上,再跑一个 LiDAR 检测器;这样做在 32 线 LiDAR 下只有不到 5% 的相机特征能找到对应的点,其余全部丢弃,对语义类任务(如 BEV 地图分割)几乎没有帮助。BEVFusion 改为把两种模态各自变换到同一个鸟瞰图(bird’s-eye view,BEV)空间,相机侧保留语义密度,LiDAR 侧保留几何结构,拼接后用一个全卷积 BEV 编码器融合,再接任务头。这条路的瓶颈是相机到 BEV 的视图变换:LSS 式的 BEV pooling 一帧要处理约 200 万个点、耗时超过 500 ms,占整个模型 80% 以上的时间;作者用预计算网格索引和专用的区间归约 GPU 核把它压到 12 ms,提速 40 倍。结果上,nuScenes 测试集 3D 检测 70.2 mAP / 72.9 NDS,比 TransFusion 高 1.3 分,计算量少 1.9 倍、实测延迟低 1.3 倍;BEV 地图分割 62.7 mIoU,比点级融合方法高 13.6 分;Waymo 测试集 85.7 mAP/L1 超过所有已提交方案。代码、权重开源,Apache-2.0 协议,后来被 MMDetection3D 收编,NVIDIA 做了 TensorRT 部署(Orin 上 25 FPS)。
- 论文:BEVFusion: Multi-Task Multi-Sensor Fusion with Unified Bird’s-Eye View Representation,Zhijian Liu、Haotian Tang(共同一作)、Alexander Amini、Xinyu Yang、Huizi Mao、Daniela L. Rus、Song Han,MIT,ICRA 2023(arXiv 首版 2022 年 5 月)。
- 代码:github.com/mit-han-lab/bevfusion;项目页:hanlab.mit.edu/projects/bevfusion。
- 预备知识:本文假定读者知道 LiDAR 点云的体素化 + 稀疏卷积检测器(VoxelNet / SECOND / CenterPoint)和 LSS 式的相机 BEV 变换;站内相关的 LiDAR 文章可以看 R3LIVE 笔记。
一、动机:融合应该在哪个空间里做
自动驾驶车上的传感器各有所长:相机给出稠密的语义(颜色、纹理、类别),LiDAR 给出精确的三维几何,毫米波雷达给出速度。多传感器融合是必须的,但不同传感器的数据活在不同的「视图」里:相机是透视视图,LiDAR 是三维空间。要融合,就得先找到一个统一表示(unified representation),把所有模态都无损地变换过去,而且这个表示还要适合不同的下游任务。
论文把已有做法按「往哪个空间投影」分成两类,各有一种信息损失(图 1):
投到相机(LiDAR-to-camera)。受 RGB-D 的启发,把 LiDAR 点投到图像平面得到 2.5D 稀疏深度图,然后用 2D 网络处理。这是几何有损的:三维空间里相距很远的两个点,投影后在图像上可能是邻居(图 1a 的红点和蓝点),局部卷积会把它们当成一个东西,对几何类任务(3D 检测)很不利。
投到 LiDAR(camera-to-LiDAR),也就是过去三年的主流「点级融合」:PointPainting 给 LiDAR 点贴上图像语义分割标签[2],PointAugmenting 贴 CNN 特征[3],MVP 从图像实例分割生成虚拟点来加密点云[4],然后统统交给一个现成的 LiDAR 检测器。这是语义有损的:相机和 LiDAR 的密度差太多,32 线 LiDAR 下只有不到 5% 的相机特征能匹配到一个 LiDAR 点,其它 95% 直接丢掉。对 3D 检测这种以物体为中心的任务问题不大(物体上总有点),但对 BEV 地图分割这种需要「背景」语义的任务几乎无效:路口没有 LiDAR 点覆盖的地方(图 1b)就完全没有语义。LiDAR 越稀疏(或者换成毫米波雷达),这个问题越严重。近期在隐空间里做融合的方法(FUTR3D、TransFusion 的物体查询)[5, 6]也是以物体为中心,难以推广到分割。
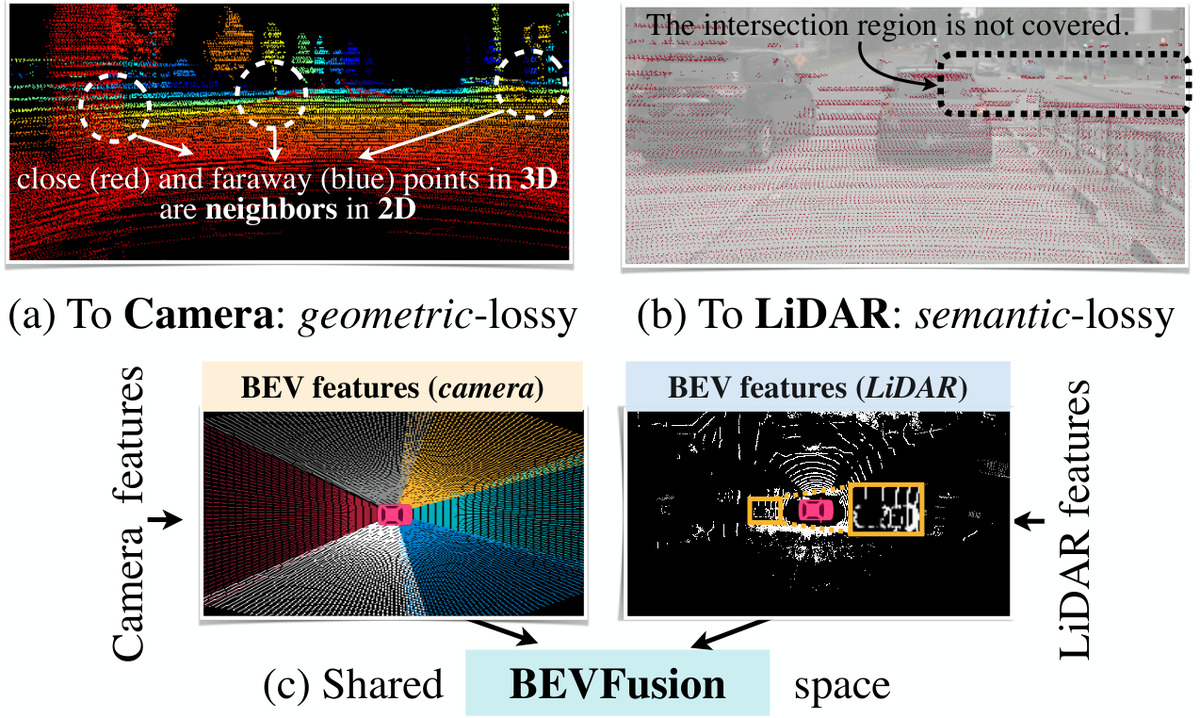 图 1:三种融合空间的对比。(a) 投到相机是几何有损的:三维上一近一远的两个点在图像上成了邻居。(b) 投到 LiDAR 是语义有损的:虚线框里的路口没有 LiDAR 点覆盖,相机的语义到不了那里。(c) BEVFusion 把相机特征(左,六个相机的视锥在 BEV 上展开)和 LiDAR 特征(右)变换到同一个 BEV 空间再融合,两边的信息都保留下来。
论文的回答是投到鸟瞰图(BEV)。几乎所有驾驶感知任务的输出本来就在 BEV 里;LiDAR 到 BEV 只是把稀疏特征沿高度压扁,不产生几何畸变;相机到 BEV 则把每个像素投成一条射线上的若干点,整张图的语义都能落到 BEV 网格上,得到的是稠密的语义特征图。所以 BEV 同时保留了几何结构和语义密度,也天然支持多任务。
贡献可以概括成三条:
- 一个以 BEV 为统一表示的、任务无关的多传感器融合框架,换任务头就能做检测或分割,几乎不改架构。
- 定位并消除了相机到 BEV 变换的效率瓶颈:BEV pooling 占模型 80% 以上的运行时间,用预计算和区间归约提速 40 倍以上。
- nuScenes 检测和分割、Waymo 检测的新 SOTA,计算量比点级融合方法低 1.5 到 2 倍。
作者在引言里把它说成一个「换个角度看问题」的工作:LiDAR 空间真的是做传感器融合的正确地方吗? 简单,是它的核心优点。
二、核心方法
2.1 总体架构
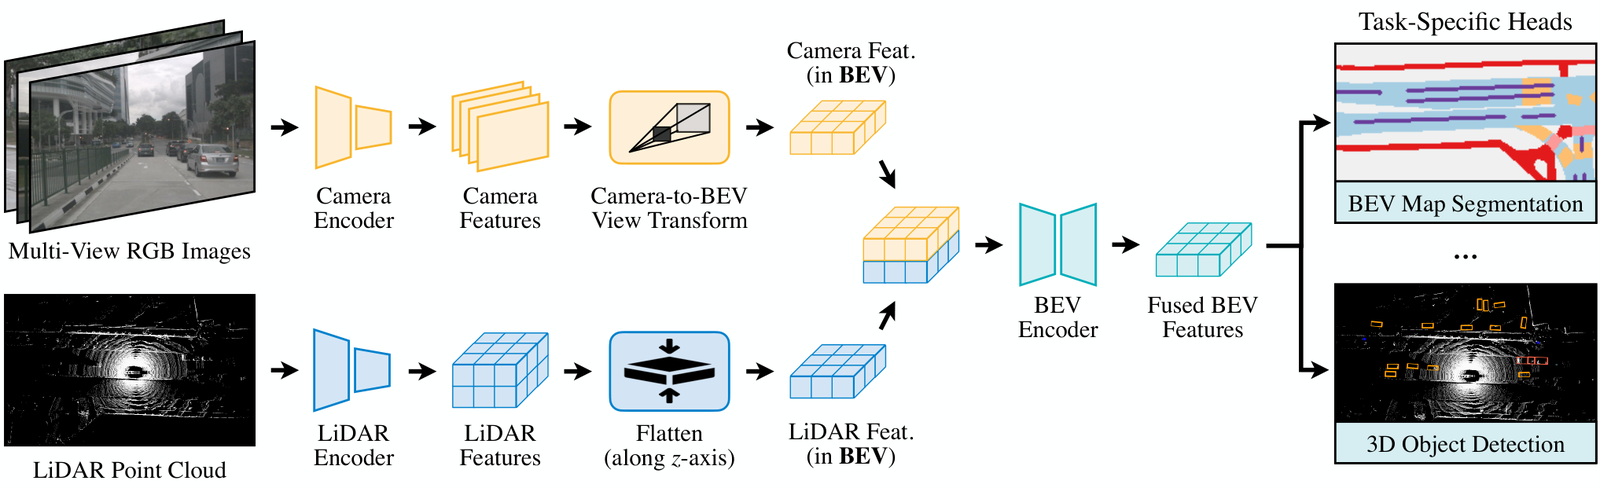 图 2:BEVFusion 的流水线。上支:多视角 RGB 图像经相机编码器得到图像特征,再经相机到 BEV 的视图变换得到相机 BEV 特征。下支:LiDAR 点云经稀疏卷积编码器得到三维体素特征,沿 z 轴展平得到 LiDAR BEV 特征。两路在同一个 BEV 网格上拼接,交给一个全卷积 BEV 编码器,最后接任务头:BEV 地图分割(上)、3D 目标检测(下),省略号表示可以继续加别的任务。
流程很直白:模态专属编码器 → 各自变到 BEV → 拼接 → 卷积 BEV 编码器 → 任务头。整篇论文的技术重点其实只在一个地方:相机到 BEV 这一步怎么做得又准又快。LiDAR 到 BEV 是现成的(体素化、稀疏卷积、沿高度展平),融合是最朴素的拼接加卷积,任务头是照搬 CenterPoint / TransFusion 和 CVT 的。下面按这个顺序展开。
2.2 相机到 BEV:LSS 式的显式深度分布
相机到 BEV 的难点在于深度是未知的:一个像素对应一条射线,不知道特征该落在射线上的哪一点。BEVFusion 沿用 LSS[7]的办法:为每个像素显式预测一个离散的深度分布,然后把该像素的特征沿射线散布到 个离散深度上,每一份按对应的深度概率缩放(图 3a)。
设相机数 ,相机特征图尺寸 ,深度格数 ,这一步会生成一个大小为 的相机特征点云。然后把这个三维点云按 坐标以步长 (如 0.4 m)量化到 BEV 网格,用 BEV pooling 把落入同一个 格子的所有特征聚合起来(对称函数,如求和、均值、最大),再沿 轴展平。
这个点云有多大?论文脚注给了典型配置:6 个相机,特征图 ( 的输入降采样 8 倍),深度在 m 内按 0.5 m 离散成 格,于是
比一帧 32 线 LiDAR 的三万多个点密了两个数量级。这也正是前面「不到 5% 相机特征能匹配到 LiDAR 点」的另一种说法:把这两百万个候选位置全留下,语义才不会丢。
下面的部件画了一个相机列(同一列的 个像素,在 BEV 里投到同一条射线上)的特征如何散布到 BEV 网格。拖动射线方向、像素行数、深度分布的峰值和宽度,看每个 BEV 格子里要聚合多少个点。
2.3 高效 BEV pooling:预计算 + 区间归约
虽然概念简单,BEV pooling 在原始实现里却慢得惊人:RTX 3090 上超过 500 ms,而模型其余部分加起来只要约 100 ms。原因就是上面算的两百万个点。作者把 pooling 拆成「网格关联」和「特征聚合」两步,分别优化(图 3b、3c)。
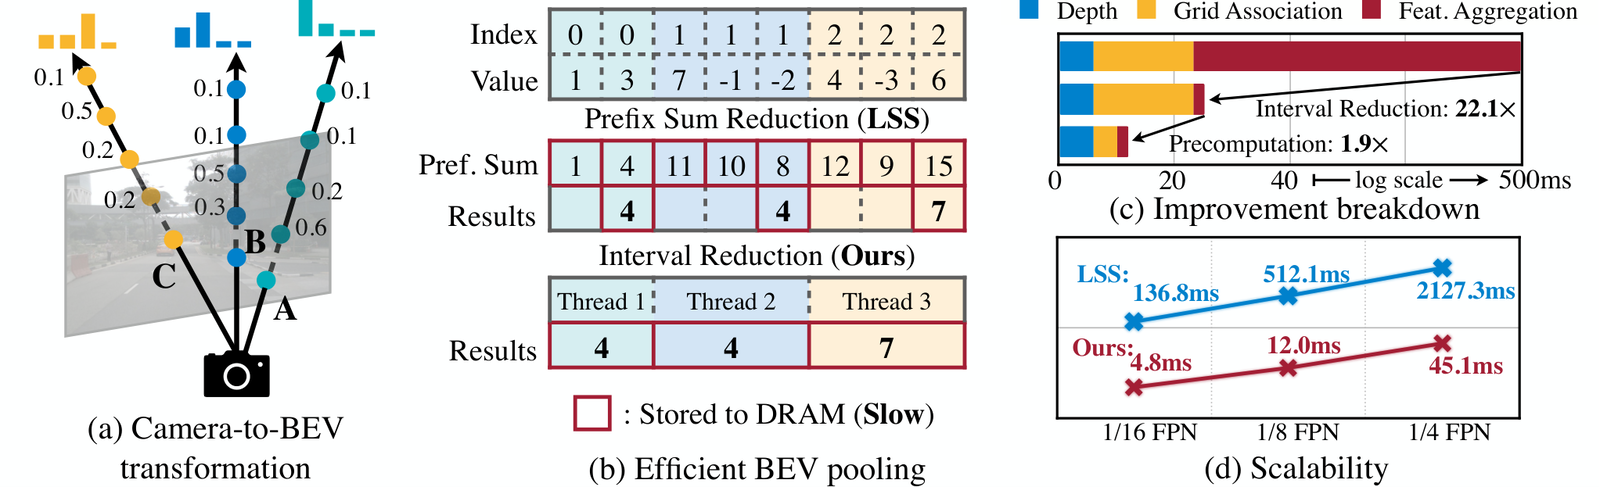 图 3:(a) 相机到 BEV 变换:像素 A、B、C 的特征沿各自的射线散布到 D 个深度上,每份按深度概率加权。(b) 高效 BEV pooling:上面是 LSS 的做法,先对排序后的全部点算前缀和(每个部分和都写回 DRAM,红框),再在网格边界处相减;下面是本文的区间归约,每个 BEV 格子分给一个 GPU 线程直接求区间和,只写结果。(c) 时间拆分(对数坐标):区间归约把特征聚合从 500 ms 压到 2 ms(22.1 倍),预计算把网格关联从 17 ms 压到 4 ms(1.9 倍)。(d) 不同特征分辨率下 LSS 与本文的延迟,本文在 1/4 FPN 分辨率下仍只需 45 ms。
预计算(precomputation)。第一步是把相机特征点云的每个点关联到一个 BEV 格子。与 LiDAR 点云不同,相机特征点云的三维坐标是固定的:只要内外参不变(标定好的车上通常如此),每个像素在每个深度格上的三维位置、它落入哪个 BEV 格子,都可以提前算好。作者预计算每个点的三维坐标和 BEV 格子索引,按格子索引排序并记录每个点的秩;推理时只需按预计算的秩把特征重新排列。网格关联的延迟从 17 ms 降到 4 ms。
区间归约(interval reduction)。排序之后,同一个 BEV 格子里的点在张量里是连续的,聚合就是对每个区间做归约。LSS 的实现是先对整个序列算前缀和(prefix sum),再在索引变化的边界处相减。前缀和在 GPU 上要做树状归约,会产生大量用不上的部分和(我们只要边界上的值),而且这些部分和全都要写回 DRAM,两头都低效。作者写了一个专用 GPU 核:每个 BEV 格子分一个线程,线程直接算自己区间的和并写回。没有输出之间的依赖(不需要多级树归约),也不写部分和。特征聚合从 500 ms 降到 2 ms。
下面的部件复现图 3b:随机生成一段按格子索引排好序的点,对比两种归约各自要往 DRAM 写多少个值。
两项优化叠加,相机到 BEV 变换的延迟从 500 ms 以上降到 12 ms,只占模型端到端时间的约 10%,而且随特征分辨率线性可扩展(图 3d)。下面的部件把图 3c 和 3d 合在一起:开关两项优化,切换 FPN 分辨率,看延迟拆分怎么变。
论文特别强调了一句:同期的两个相机 3D 检测工作也注意到了这个瓶颈,但它们是用近似绕过去的:M²BEV 假设射线上深度均匀分布[8],BEVDet 截断每个 BEV 格子里的点数[9];BEVFusion 的做法是精确的,而且更快。这是让「统一 BEV 表示」从一个好想法变成一个可用系统的关键。
2.4 全卷积融合
两路特征都在同一个 BEV 网格上以后,融合就是一个逐元素操作,论文用的是最朴素的拼接(concatenation)。但同一个空间不等于严格对齐:视图变换里的深度估计不准,相机 BEV 特征和 LiDAR BEV 特征在空间上会有一定错位。作者的处理是在拼接后接一个基于卷积的 BEV 编码器(几个残差块),用卷积的局部感受野去补偿这种局部错位。
论文坦承这一步可以做得更好,例如用真值深度监督视图变换器(CaDDN 的做法[10]),留作未来工作。后来的 BEVDepth 正是沿这条线走的[11]。
2.5 多任务头
融合后的 BEV 特征可以接任意任务头:
- 3D 检测:沿用 CenterPoint / TransFusion 的检测头[12, 6],一个类别相关的中心热图头预测物体中心位置,加几个回归头预测尺寸、朝向和速度。
- BEV 地图分割:不同地图类别可能重叠(人行横道是可行驶区域的子集),所以不能做多分类,而是对每个类别做一个二值语义分割,按 CVT 的协议[13]用标准的 focal loss 训练[14]。
两个任务的 BEV 特征图范围和分辨率不同(检测用 0.075 m 体素、分割用 0.1 m),所以在每个任务头之前用双线性插值的网格采样把特征显式变换到该任务的 BEV 网格上。
2.6 模型与训练细节
- 图像骨干 Swin-T[15],输入降采样到 ,用 FPN 融合多尺度特征得到 1/8 分辨率的特征图[16]。
- LiDAR 骨干 VoxelNet[17](代码里是 SECOND 式的稀疏卷积[18]),检测体素 0.075 m,分割体素 0.1 m。
- 数据集 nuScenes 和 Waymo[19, 20],都有超过四万个标注场景、同时有 LiDAR 和环视相机。
- 评测用单模型、不做测试时增强(Waymo 除外,见下)。
论文正文没有写训练流程,README 里的命令补上了一个重要细节:融合检测模型是两阶段训练的,先训一个 LiDAR-only 检测器(TransFusion-L),再以它为初始化(--load_from pretrained/lidar-only-det.pth)加上相机分支训练融合模型;图像骨干用 nuImages 预训练的 Swin-T 初始化。分割模型则不需要 LiDAR-only 初始化。
三、实验结果
3.1 设置
3D 检测指标是 nuScenes 的 10 类前景 mAP 和 NDS(nuScenes detection score,综合了 mAP 和平移、尺寸、朝向、速度、属性误差);分割指标是 6 个背景类的 IoU 和均值 mIoU,每类按二值分割单独评估并取各阈值下的最高 IoU,评测区域是自车周围 。所有开源方法的 MACs 和延迟都在一张 RTX 3090 上以单次推理测量。
下面的部件把论文表 I 到表 IV 和图 4 的数据做成可切换的横向条形图,BEVFusion 的条用主题色标出。
3.2 3D 目标检测
表 I 把仅相机(M²BEV、BEVFormer)、仅 LiDAR(PointPillars、SECOND、CenterPoint)[21]和各类融合方法(PointPainting、PointAugmenting、MVP、FusionPainting、AutoAlign、FUTR3D、TransFusion)[22, 23]放在一起比。nuScenes 上 BEVFusion 不用任何花招就拿到了 SOTA:测试集 70.2 mAP / 72.9 NDS,比 TransFusion 高 1.3 分,同时 MACs 从 485.8 G 降到 253.2 G(1.9 倍),实测延迟从 156.6 ms 降到 119.2 ms(1.3 倍),桌面 GPU 上接近实时(8.4 FPS)。对比点级融合的代表 PointPainting 和 MVP,提速 1.6 倍、MACs 少 1.5 倍、mAP 高 3.8 分。
作者对效率来源的解释值得记下来:因为 BEV 空间用上了全部相机特征而不只是 5% 的稀疏子集,相机分支可以用小得多的输入分辨率(256×704)达到同样的性能,这是 MACs 减少的主因;再加上 BEV pooling 的优化,MACs 的减少才转化成了实测的提速。
Waymo 上 BEVFusion 也排到第一,超过了之前最好的多模态方法 DeepFusion[24](后者用 5 帧输入和 25 个模型的集成,BEVFusion 用 3 帧、单模型加测试时增强)。
3.3 BEV 地图分割
这是论文最能说明问题的一张表。分割是语义导向的任务,结果和检测恰好相反:
- 仅相机的 BEVFusion(56.6 mIoU)比所有仅 LiDAR模型高 8 到 13 分,而在检测任务上,最好的仅相机模型比仅 LiDAR 模型低近 20 分 mAP。
- 仅相机的 BEVFusion 比现有的单目 BEV 分割方法(LSS、CVT 等)高至少 12 分,说明光是视图变换做得更好、输入分辨率和骨干的选择,就已经有很大空间。
- 多模态 BEVFusion(62.7 mIoU)再提高 6 分,比 PointPainting / MVP 这类点级融合方法高 13 分以上。后两者在分割上几乎没有比仅 LiDAR 的 CenterPoint 好:PointPainting 只修饰前景 LiDAR 点,MVP 只加密前景物体,对地图元素都没有帮助。更根本的是,它们都假设 LiDAR 是更有效的模态,表 III 说明这个假设并不总成立。
3.4 分析:天气、光照、尺寸、距离与稀疏 LiDAR
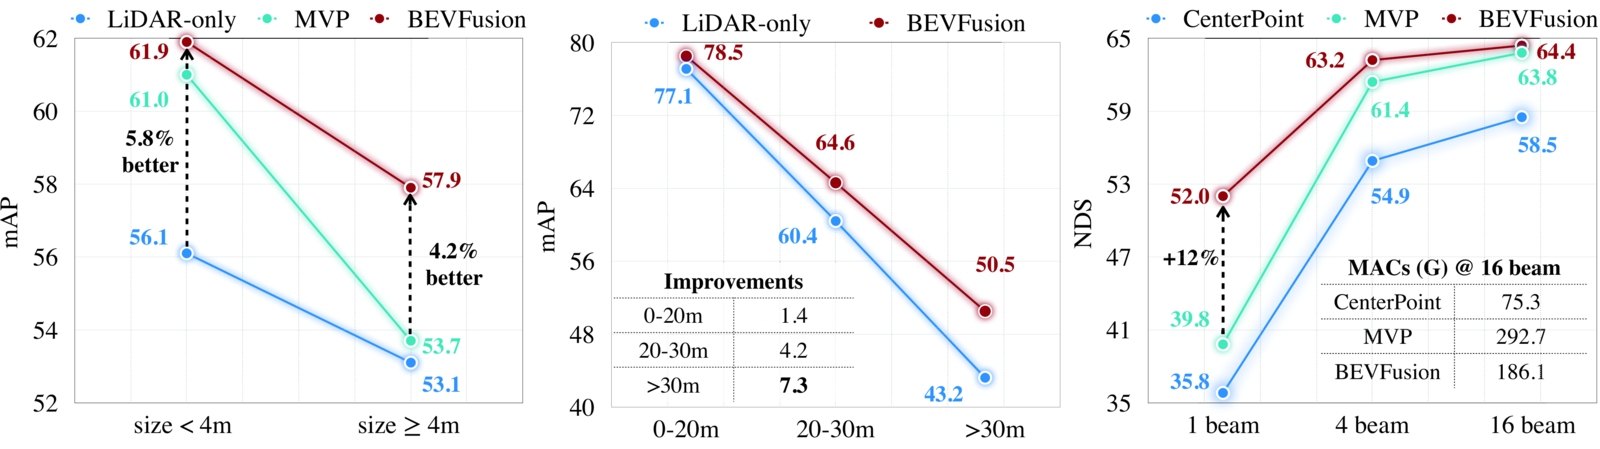 图 4:(a) 按物体尺寸:BEVFusion 对小物体和大物体都有一致提升(+5.8 / +4.2 mAP),MVP 对大于 4 m 的物体几乎没有提升。(b) 按距离:越远提升越大,30 m 以外 +7.3 mAP。(c) 按 LiDAR 线数:1 线时 BEVFusion 比 MVP 高 12 分 NDS,而 MACs 只有 MVP 的 64%。
- 天气与光照(表 IV)。雨天 LiDAR 有传感器噪声,仅 LiDAR 模型明显掉点;BEVFusion 借助相机把 mAP 提高 10.7 分,把晴雨差距缩小到 1.7 分。夜晚对两种模态都难,但 MVP 的提升很小,因为它依赖准确的 2D 实例分割来生成虚拟点,暗处和过曝的场景下分割本身就不准;BEVFusion 在夜晚分割上 +12.8 mIoU,比白天的提升还大,说明相机失效时几何线索的价值更高。
- 尺寸与距离(图 4a、4b)。大物体本来就有很多 LiDAR 点,MVP 加密虚拟点对它们没有帮助;小物体和远处物体 LiDAR 覆盖不足,稠密的相机信息补得最多。
- 稀疏 LiDAR(图 4c)。把 LiDAR 降到 1 线时,MVP 只有 39.8 NDS,因为它本质上还是在跑一个 LiDAR 检测器,LiDAR 一稀疏就塌了;BEVFusion 有 52.0,因为相机信息在 BEV 空间里是独立整合的,不依赖 LiDAR 检测器自身的鲁棒性。所有稀疏度下 BEVFusion 的 MACs 都比 MVP 少 1.6 倍。
四、局限性
论文自己承认的(正文里散落的几句):
- 视图变换的深度不准,导致相机 BEV 特征和 LiDAR BEV 特征有局部错位,目前靠卷积 BEV 编码器硬补。作者提到可以用真值深度监督视图变换器,留作未来工作。
- 融合算子很朴素:拼接 + 几个残差块。论文没有对融合模块做任何消融(没有试过加权、注意力等替代方案),也没有消融 BEV pooling 之外的设计。
- 框架「可以扩展到雷达、事件相机,以及跟踪、运动预测等任务」,但论文只验证了相机 + LiDAR 的检测和分割。
我自己再补几条:
- 「多任务」是框架层面的,不是联合训练的。 论文和 README 里检测、分割是两个单独训练的模型(
bevfusion-det.pth和bevfusion-seg.pth),体素大小都不一样(0.075 m 对 0.1 m)。论文没有报告一个模型同时跑两个头的结果;M²BEV 的实验显示两者联合训练时各自的精度会略有下降。 - 没有时序。BEVFusion 是单帧的(nuScenes 上按惯例叠了 LiDAR 多帧扫描,但相机只有当前帧)。同期的 BEVFormer 已经在用时序 BEV[25],之后 BEV 系的工作基本都加了时序。
- 延迟是 PyTorch 下测的,119 ms 里包含了 Swin-T 和稀疏卷积,这些在 TensorRT 下还有很大空间,NVIDIA 后来的 CUDA-BEVFusion 用 INT8 在 Orin 上做到 25 FPS[26]。
- 与 PKU / 阿里的同名工作撞车。两周之内 arXiv 上出现了两篇 BEVFusion,另一篇(Liang 等,NeurIPS 2022)[27]强调的是融合框架对传感器故障的鲁棒性,设计上也是双流到 BEV 再融合。引用和搜索时要分清楚。
- 仓库已归档(2025 年 1 月起只读),依赖钉在 PyTorch 1.9 到 1.10.2、mmcv 1.4.0、mmdet 2.20.0、Python 3.8 这一代。要在新环境里用,走 MMDetection3D 的
projects/BEVFusion实现更省事[28]。
五、结论与展望
BEVFusion 的故事线很清楚:点级融合之所以是过去三年的主流,是因为 LiDAR 检测器强、把相机信息贴上去最省事;但这条路把相机当成了 LiDAR 的附属品,95% 的相机特征被扔掉,LiDAR 一稀疏、天气一差,整个系统就跟着 LiDAR 检测器一起塌。把两种模态各自变到 BEV 再融合,相机的语义和 LiDAR 的几何就都保住了,同一张 BEV 特征图还能接检测、分割等任意任务头。方法上没有任何新的网络模块,真正的技术贡献是把「相机到 BEV 变换太慢」这个工程瓶颈用预计算和区间归约干净地解决掉,让这个范式变得可用。
从后续影响看,这篇论文的主张基本被验证了。它在 2022 年先后拿下 nuScenes、Waymo 和 Argoverse 三个检测榜的第一,被 MMDetection3D 收编为官方实现,NVIDIA 做了 TensorRT 部署并集成进 DeepStream[29]。之后的多模态检测工作,无论是在 BEV 里换更强的融合算子(UniTR 的统一 transformer 骨干[30]),还是转向稀疏查询(CMT、SparseFusion[31, 32]),都以 BEVFusion 作为基线来比较。相机 BEV 的深度不准这条线则由 BEVDepth 等工作接上。
对实践者的几条建议:
- 做语义类任务(地图、可行驶区域、占据栅格)时,不要用点级融合;相机 BEV 分支即使单独用,也比仅 LiDAR 强。
- 相机分支的输入分辨率可以压得很低(256×704),把算力留给 BEV 编码器,前提是视图变换要像本文这样做到精确又便宜。
- 如果目标是低线数 LiDAR 或者雷达,BEVFusion 这种「不依赖 LiDAR 检测器」的结构鲁棒性优势会更明显。
- 融合检测模型要按 README 的两阶段训练:先 LiDAR-only,再加相机分支微调。
六、上手
官方仓库(已归档,Apache-2.0)的环境要求:Python 3.8、PyTorch 1.9 到 1.10.2、mmcv 1.4.0、mmdetection 2.20.0、torchpack、OpenMPI 4.0.4 与 mpi4py 3.0.3。仓库提供了 Dockerfile,建议直接用:
cd docker && docker build . -t bevfusion
nvidia-docker run -it -v `pwd`/../data:/dataset --shm-size 16g bevfusion /bin/bash
# 容器内
git clone https://github.com/mit-han-lab/bevfusion && cd bevfusion
python setup.py develop
数据按 MMDetection3D 的 nuScenes 流程准备(分割需要 map 扩展包);README 提醒要用本仓库重新生成 info 文件,因为它早于 MMDetection3D 的坐标系重构。评测:
./tools/download_pretrained.sh
torchpack dist-run -np 8 python tools/test.py \
  configs/nuscenes/det/transfusion/secfpn/camera+lidar/swint_v0p075/convfuser.yaml \
  pretrained/bevfusion-det.pth --eval bbox
torchpack dist-run -np 8 python tools/test.py \
  configs/nuscenes/seg/fusion-bev256d2-lss.yaml pretrained/bevfusion-seg.pth --eval map
训练(8 卡):
# 先训 LiDAR-only 检测器
torchpack dist-run -np 8 python tools/train.py \
  configs/nuscenes/det/transfusion/secfpn/lidar/voxelnet_0p075.yaml
# 再以它为初始化训融合模型
torchpack dist-run -np 8 python tools/train.py \
  configs/nuscenes/det/transfusion/secfpn/camera+lidar/swint_v0p075/convfuser.yaml \
  --model.encoders.camera.backbone.init_cfg.checkpoint pretrained/swint-nuimages-pretrained.pth \
--load_from pretrained/lidar-only-det.pth配置文件名和论文概念的对应:swint 是 Swin-T 图像骨干,v0p075 是 0.075 m 体素,convfuser 就是 2.4 节的拼接 + 卷积融合,lss 是 2.2 节的视图变换,bev256d2 是分割用的 BEV 网格。README 给出的权重与论文略有出入(nuScenes val 检测 68.52 mAP / 71.38 NDS,分割 62.95 mIoU;仅相机检测基线 35.56 mAP,仅 LiDAR 基线 TransFusion-L 64.68 mAP),还列出了后来提交到 nuScenes 测试集的更大模型 BEVFusion-e(74.99 mAP / 76.09 NDS)。
要在新环境或部署场景用,有两条更省事的路:MMDetection3D 的 projects/BEVFusion 是官方维护的重实现;NVIDIA 的 CUDA-BEVFusion 提供 TensorRT / INT8 推理,Jetson Orin 上 25 FPS。
参考
- Liu, Tang, Amini, Yang, Mao, Rus, Han. BEVFusion: Multi-Task Multi-Sensor Fusion with Unified Bird's-Eye View Representation. ICRA 2023. arXiv · 代码
- Vora, Lang, Helou, Beijbom. PointPainting: Sequential Fusion for 3D Object Detection. CVPR 2020. arXiv
- Wang, Ma, Zhu, Yang. PointAugmenting: Cross-Modal Augmentation for 3D Object Detection. CVPR 2021. CVF
- Yin, Zhou, Krähenbühl. Multimodal Virtual Point 3D Detection (MVP). NeurIPS 2021. arXiv · 代码
- Chen, Zhang, Wang, Wang, Zhao. FUTR3D: A Unified Sensor Fusion Framework for 3D Detection. CVPRW 2023. arXiv · 代码
- Bai, Hu, Zhu, Huang, Chen, Fu, Tai. TransFusion: Robust LiDAR-Camera Fusion for 3D Object Detection with Transformers. CVPR 2022. arXiv · 代码
- Philion, Fidler. Lift, Splat, Shoot: Encoding Images from Arbitrary Camera Rigs by Implicitly Unprojecting to 3D. ECCV 2020. arXiv · 代码
- Xie, Yu, Zhou, et al. M²BEV: Multi-Camera Joint 3D Detection and Segmentation with Unified Birds-Eye View Representation. arXiv 2204.05088, 2022. arXiv
- Huang, Huang, Zhu, Ye, Du. BEVDet: High-performance Multi-camera 3D Object Detection in Bird-Eye-View. arXiv 2112.11790, 2021. arXiv · 代码
- Reading, Harakeh, Chae, Waslander. Categorical Depth Distribution Network for Monocular 3D Object Detection (CaDDN). CVPR 2021. arXiv · 代码
- Li, Ge, Yu, et al. BEVDepth: Acquisition of Reliable Depth for Multi-view 3D Object Detection. AAAI 2023. arXiv · 代码
- Yin, Zhou, Krähenbühl. Center-based 3D Object Detection and Tracking (CenterPoint). CVPR 2021. arXiv · 代码
- Zhou, Krähenbühl. Cross-view Transformers for Real-time Map-view Semantic Segmentation. CVPR 2022. arXiv · 代码
- Lin, Goyal, Girshick, He, Dollár. Focal Loss for Dense Object Detection. ICCV 2017. arXiv
- Liu, Lin, Cao, et al. Swin Transformer: Hierarchical Vision Transformer using Shifted Windows. ICCV 2021. arXiv · 代码
- Lin, Dollár, Girshick, He, Hariharan, Belongie. Feature Pyramid Networks for Object Detection. CVPR 2017. arXiv
- Zhou, Tuzel. VoxelNet: End-to-End Learning for Point Cloud Based 3D Object Detection. CVPR 2018. arXiv
- Yan, Mao, Li. SECOND: Sparsely Embedded Convolutional Detection. Sensors 2018. Sensors · 代码
- Caesar, Bankiti, Lang, et al. nuScenes: A Multimodal Dataset for Autonomous Driving. CVPR 2020. arXiv · 代码
- Sun, Kretzschmar, Dotiwalla, et al. Scalability in Perception for Autonomous Driving: Waymo Open Dataset. CVPR 2020. arXiv
- Lang, Vora, Caesar, Zhou, Yang, Beijbom. PointPillars: Fast Encoders for Object Detection from Point Clouds. CVPR 2019. arXiv
- Xu, Zhou, Fang, et al. FusionPainting: Multimodal Fusion with Adaptive Attention for 3D Object Detection. ITSC 2021. arXiv
- Chen, Li, Zhang, et al. AutoAlign: Pixel-Instance Feature Aggregation for Multi-Modal 3D Object Detection. IJCAI 2022. arXiv
- Li, Yu, Meng, et al. DeepFusion: Lidar-Camera Deep Fusion for Multi-Modal 3D Object Detection. CVPR 2022. arXiv
- Li, Wang, Li, et al. BEVFormer: Learning Bird's-Eye-View Representation from Multi-Camera Images via Spatiotemporal Transformers. ECCV 2022. arXiv · 代码
- NVIDIA-AI-IOT. CUDA-BEVFusion: BEVFusion 的 TensorRT / INT8 部署实现(Lidar_AI_Solution). GitHub, 2023. 代码
- Liang, Xie, Yu, et al. BEVFusion: A Simple and Robust LiDAR-Camera Fusion Framework. NeurIPS 2022. arXiv · 代码
- OpenMMLab. MMDetection3D 中的 BEVFusion 项目(projects/BEVFusion). GitHub, 2023. 代码
- NVIDIA. DeepStream SDK. NVIDIA Developer. 官网
- Wang, Tang, Shi, et al. UniTR: A Unified and Efficient Multi-Modal Transformer for Bird's-Eye-View Representation. ICCV 2023. arXiv · 代码
- Yan, Liu, Qin, et al. Cross Modal Transformer: Towards Fast and Robust 3D Object Detection (CMT). ICCV 2023. arXiv · 代码
- Xie, Xu, Zhu, et al. SparseFusion: Fusing Multi-Modal Sparse Representations for Multi-Sensor 3D Object Detection. ICCV 2023. arXiv · 代码