· 79 min read
论文解读:Depth Pro 2,让单帧的锐利与视频的稳定同时成立
TL;DR Depth Pro 2 是 Apple 的度量单目深度模型[1],它把 Depth Pro 的「原生分辨率 + 焦距归一化逆深度」和 VGGT、π³ 一路的「多帧联合注意力」拼成一个网络:DINOv3 ViT 的前 1/3 层只做帧内自注意力,后 2/3 层交替做帧内与跨帧注意力;跨帧时把所有帧的 patch token 拼成一个序列,class/register token 取平均后只保留一份,不加任何帧序编码,因此对帧的排列等变,也不新增 transformer block 或参数。整个网络在输入的原生分辨率上处理 1–32 帧的 clip,单图就是长度为 1 的 clip。输出仍是焦距归一化的逆深度,乘上 EXIF 或一个 23.5M 参数 FoV 估计器给出的焦距就得到米制深度。训练用 19 个数据集、四项损失(trimmed L1、尺度不变 L1、多尺度梯度、基于 GT 位姿重投影的多视图一致性),100K 步、128 张 B200。结果:zero-shot 度量深度在 11 个数据集上的平均排名 2.4/2.7(GT/预测内参)第一,视频设置 1.0/1.2 第一;边界 F1 平均排名 1.6(单图)/1.3(视频),jitter 1.5;焦距 δ25 88.6%;1080p 32 帧缓冲流式 H+ 5.3 FPS,S 44.8 FPS。代码与权重已开源,但仓库只含推理,权重限研究用途,训练和评测代码没有发布。
- 论文:Depth Pro 2: Sharp and Temporally Consistent Metric Monocular Depth,Peiyun Hu, Marko Mihajlovic, Lyndon Duong, Lahav Lipson, Wei Dong, Amaël Delaunoy, Stephan R. Richter, Vladlen Koltun;Apple,2026-11-19。
- 代码:github.com/apple-aiml-research/ml-depth-pro-2(仅推理,无训练、无评测代码)
- 权重:huggingface.co/apple/DepthPro2(S/B/L/H+ 四档,另有一个共享的 FoV 估计器;权重许可只允许非商业研究用途)
- 项目页:apple-aiml-research.github.io/ml-depth-pro-2
- 前作 / 预备知识:π⁴ 解读、DUSt3R 解读、RoMa v2 解读。
一、动机:一张图很锐,一段视频很稳,但很难兼得
单目深度这条线在过去两年分成了两个阵营。单图模型——Depth Pro、InfiniDepth、Pixel-Perfect Depth、Lotus-2——在原生分辨率上预测,边界能咬住毛发和栏杆[2, 3, 4];但每一帧独立处理,同一个物体在相邻两帧里会被放到不同的距离上。视频模型——π³、VGGT、Depth Anything 3、MapAnything——联合处理多帧,深度在时间上稳得多[5, 6, 7, 8];但它们通常把输入降采样,或者在点图/低分辨率特征上做全局注意力,代价是边界被抹平。DepthCrafter 一类方法用视频扩散先验换稳定性,计算量和显存又上去了[9]。
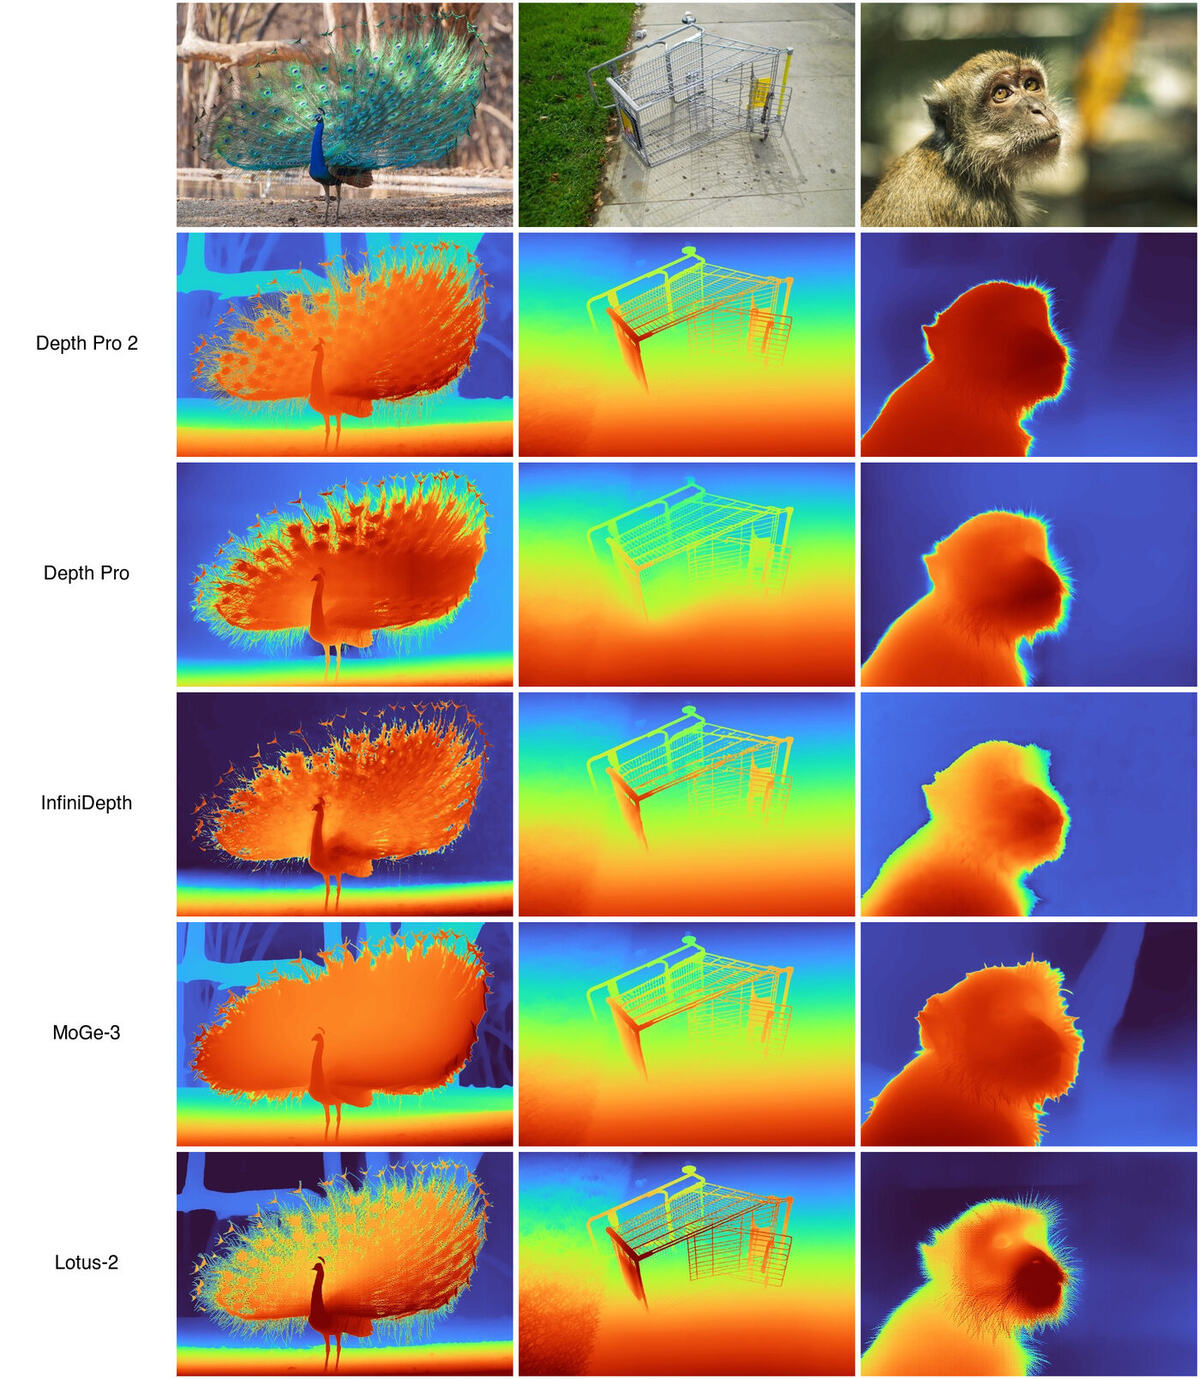
论文用一只猫鼬把这件事讲得很清楚(图 1)。InfiniDepth 把毛发的轮廓分得很细,但两帧里的猫鼬忽远忽近;π³ 把猫鼬稳定地放在同一距离,但毛发被低频化了。图 2 把这种取舍量化成一张散点:横轴是时间一致性(越靠右越好),纵轴是边界 F1(越靠上越好),单图方法挤在左上,多帧方法挤在右下。Depth Pro 2 的四个模型都在右上角,H+ 和 L 在最外侧。
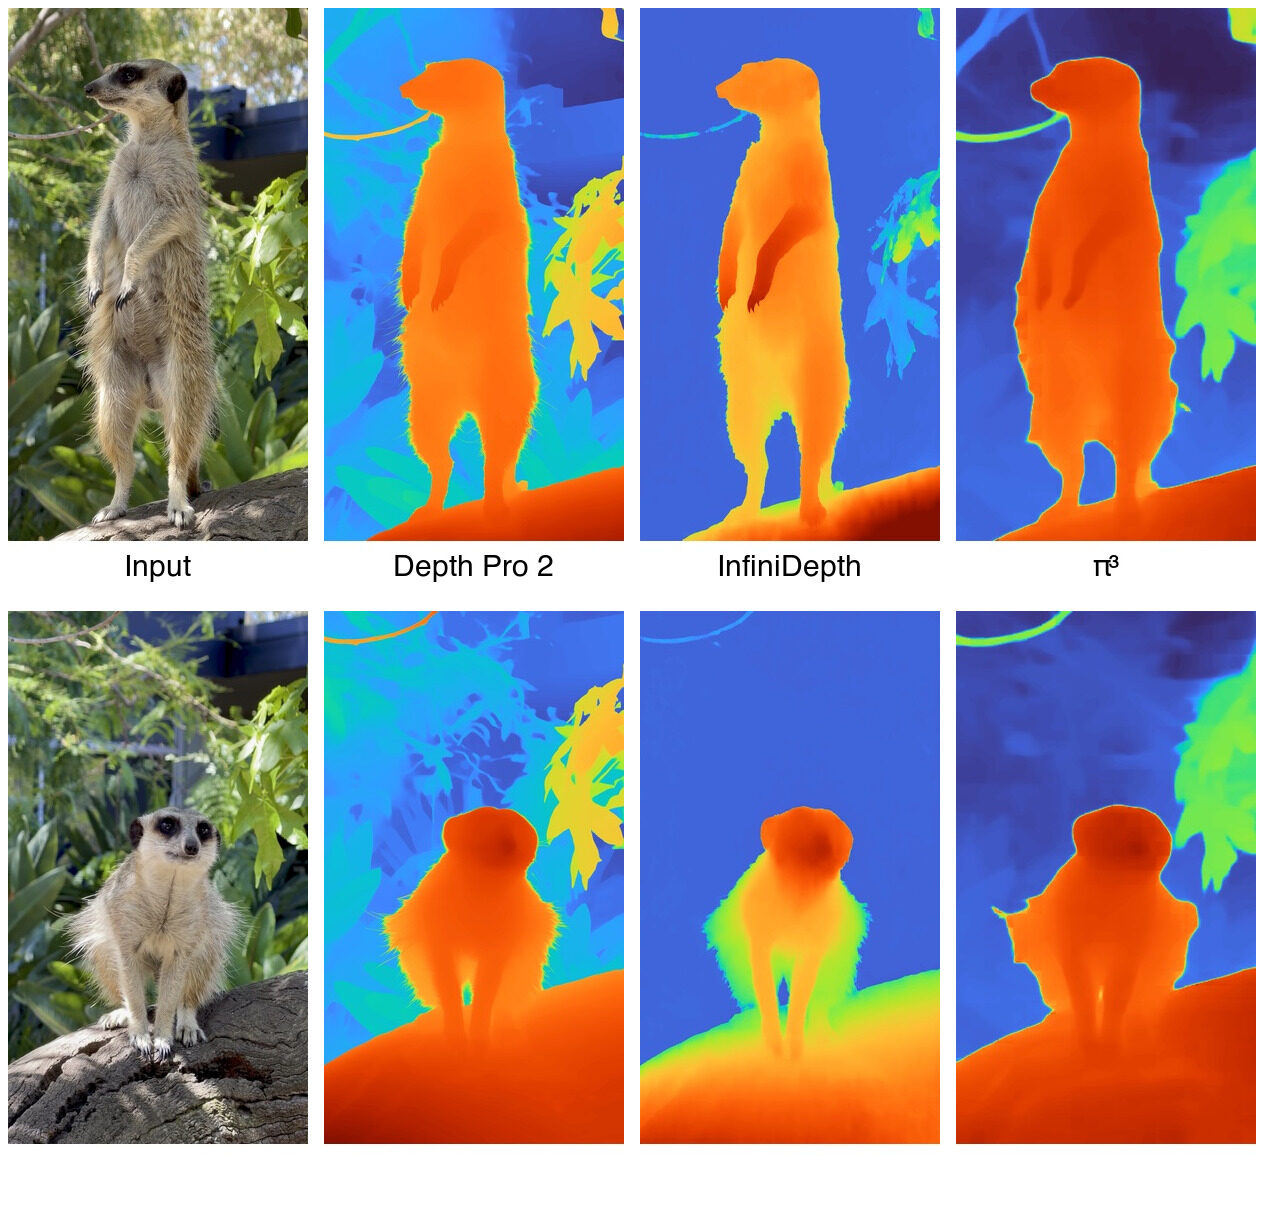
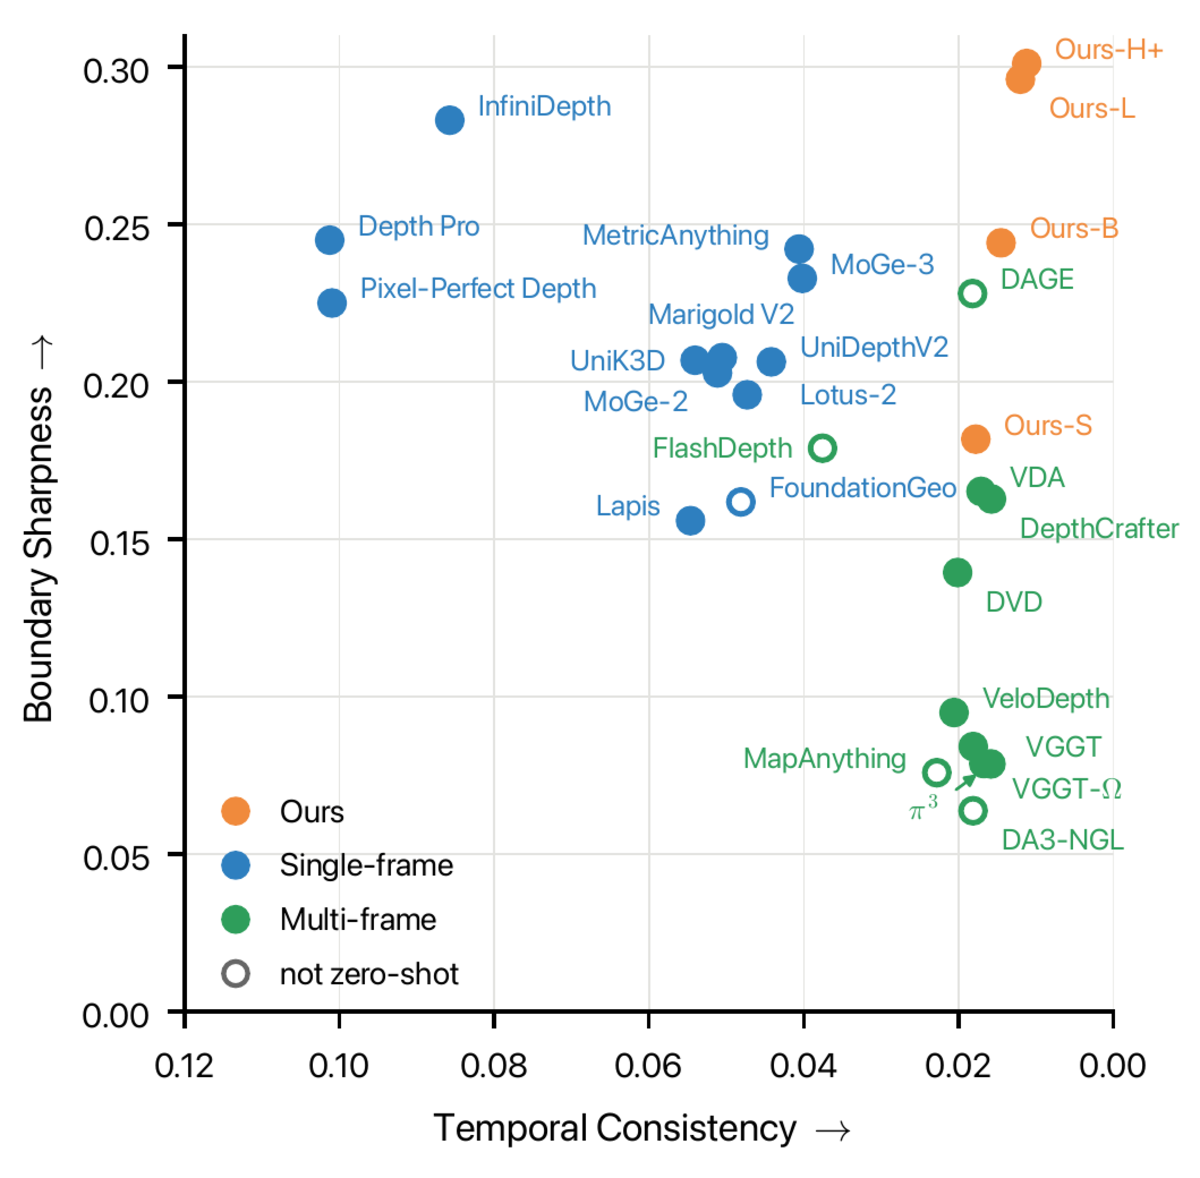
论文的判断是:这个取舍不是本质的,而是因为多帧方法为了处理长序列,牺牲了分辨率。于是它提出一个很直接的组合——用同一个 ViT 在原生分辨率上联合处理可变数量的帧。联合处理带来时间稳定性,原生分辨率带来边界锐度。为了让这两件事同时成立,网络需要满足三个条件:跨帧信息交换不能增加太多参数(否则小模型吃不消)、不能绑定固定的帧数或帧序(否则不能同时处理单图和任意长度视频)、不能要求把输入 resize 到固定尺寸(否则边界先被插值糊掉)。后面的设计基本都是在满足这三个条件。
论文的贡献可以拆成五条:
- 一个网络同时吃单图和多帧:DINOv3 ViT 的前 个 block 只做帧内自注意力,后 个 block 交替做帧内与跨帧注意力;跨帧注意力复用同一套 attention 权重,不新增 block,也不新增参数。
- 原生分辨率 + 2D RoPE:patch 16,输入只 pad 到 32 的倍数,不 resize;RoPE 的两个轴都除以长边,保留宽高比;DPT 解码器用转置卷积上采样,最后接一个全分辨率逆深度头。
- 焦距归一化逆深度 + 轻量 FoV 估计器:深度网络输出 ,焦距来自 EXIF 或一个 23.5M 参数的 DINOv3 ViT-S/16 估计器;估计器在约 92M 张 Flickr EXIF 图上训练,1080p 下只给 S/B/L/H+ 增加 8%/3%/1%/0.5% 的计算量。
- 图像、视频、多视图混训:19 个数据集,clip 长度 1–32,四项损失分别管度量尺度、相对深度、边界梯度、跨帧一致性;其中多视图一致性用 GT 位姿把预测深度重投影到另一帧,再用 2% 的深度差阈值剔除遮挡和运动物体。
- 两套流式推理:缓冲模式用带重叠的 clip + 线性 cross-fade,默认 ;无缓冲模式用因果跨帧注意力和 FIFO KV cache,默认 。两者在 300 帧 DynamicReplica 上的质量几乎一样。
二、核心方法
2.1 总体架构:一个编码器,每帧一个解码器
输入是 帧 , 可以是 1(单图),也可以是视频里的 32 帧。每帧切成 的 patch,展平成 token,加上 DINOv3 的 class/register token[10],送进一个 ViT。ViT 的中间层特征被抽出来,按帧送进 DPT 解码器[11],解码出每帧的逆深度图。图 3 是整体结构。
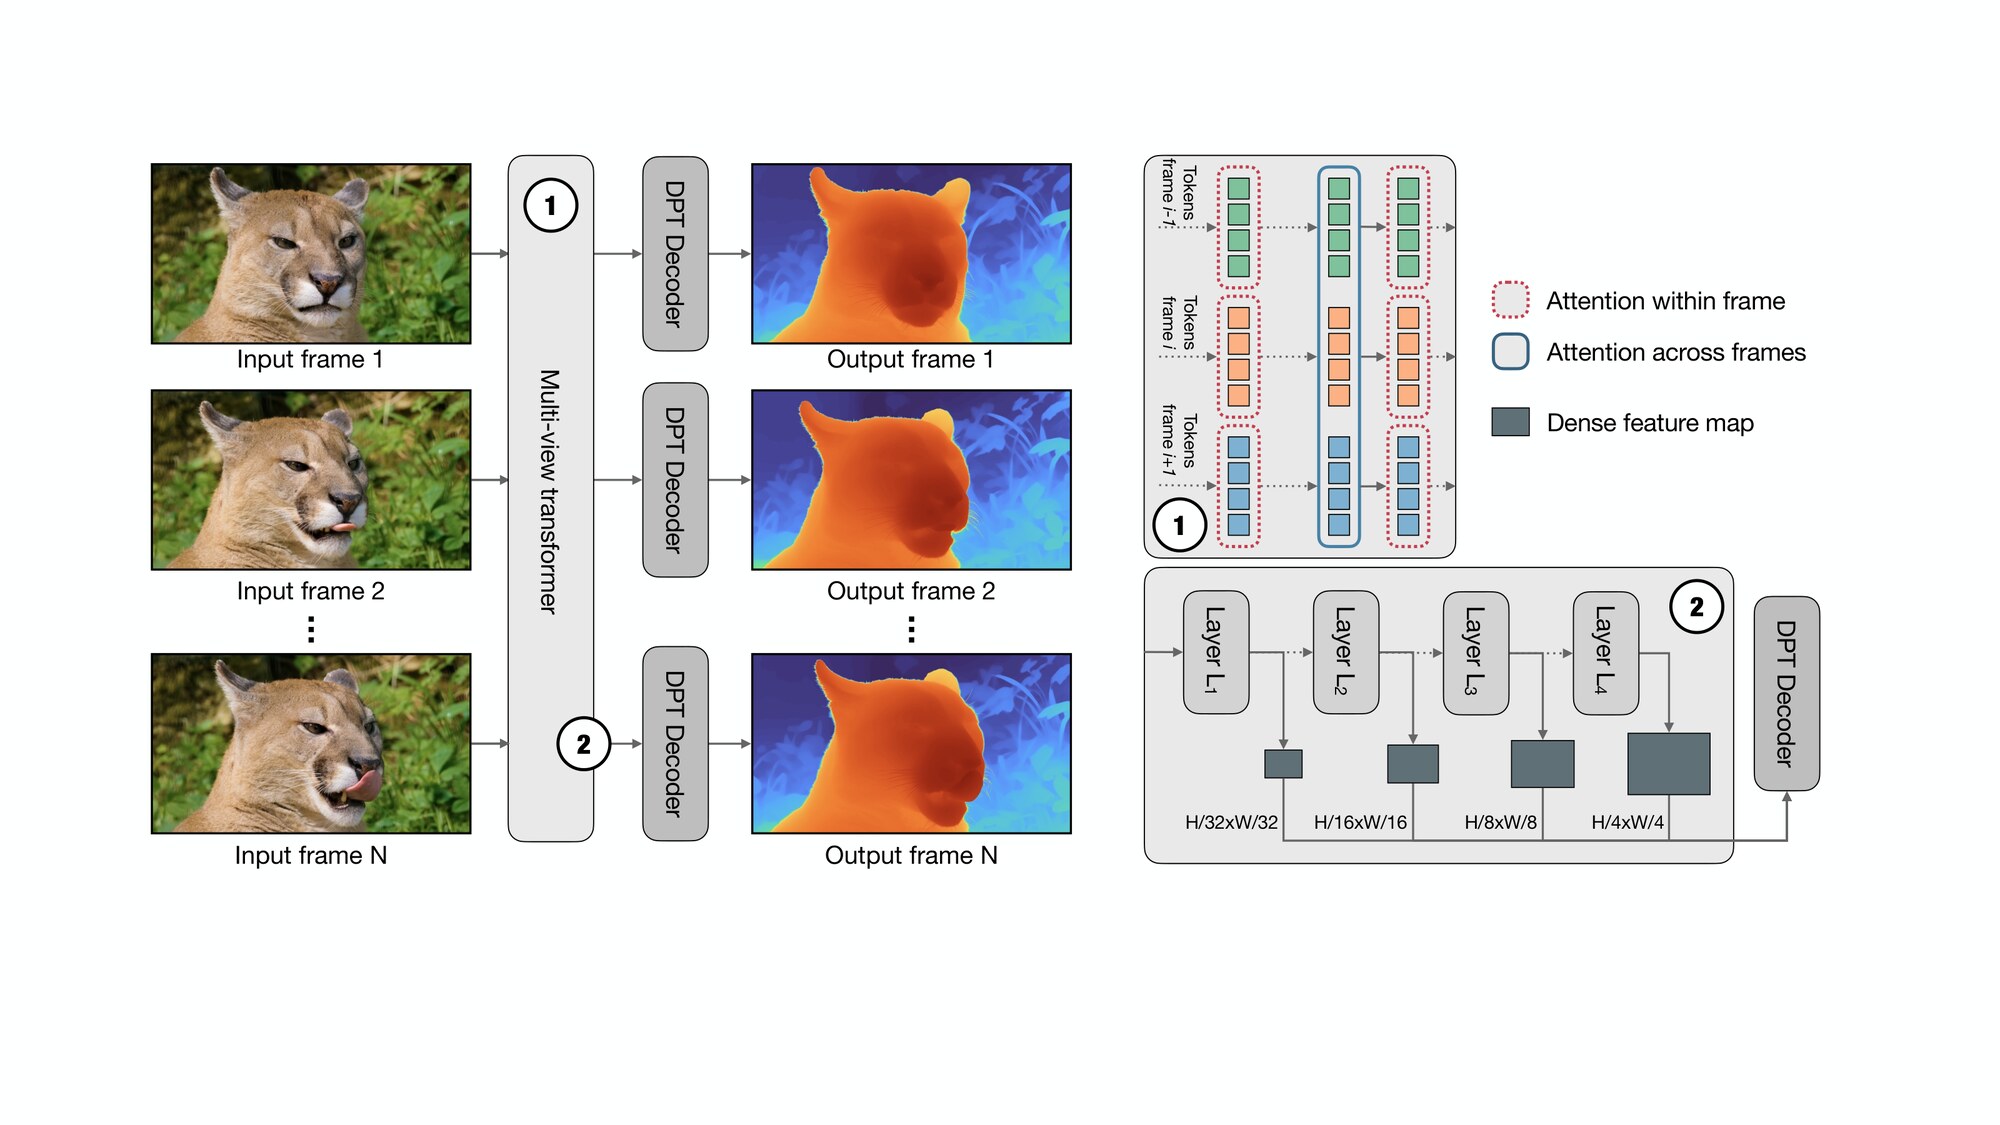
这里没有「参考视角」,也没有「第几帧」的概念。所有帧在 token 维度上是对称的,网络对帧的排列等变;单图只是 的特例。这个性质继承自 π³ 的无参考形式[5],也是同一个模型能同时处理单图、视频和多视图的根本原因。它还有一个工程上的好处:跨帧注意力不需要新参数,可以直接复用 DINOv3 的单图预训练权重,不需要为了多视图从零训练新的 block。
代价是,帧与帧之间没有显式的位置编码,网络只能靠内容匹配来对齐。论文在消融里验证了这个选择:把跨帧连接逐步断掉,度量精度几乎不掉,但 jitter 从 0.24 单调涨到 0.84(Table 20)——说明跨帧注意力主要贡献的是稳定性,而不是单帧精度。
2.2 跨帧注意力:把多帧拼成一个序列,跑同一个 block
设第 个 block 的输入 token 为 ,其中 是 class/register token 数, 是每帧 patch 数。帧内自注意力就是对每个 独立做 。跨帧注意力则把 帧的 patch token 拼成一个长度为 的序列,class/register token 先在各帧间取平均、只保留一份放在序列最前面,然后跑同一个 transformer block;跑完再把 patch token 按帧拆回去,class/register 仍然复制回每帧。用公式说,若 是第 帧的 patch token, 是平均后的 prefix token,则
注意力本身没有帧索引,RoPE 也只按 patch 的空间坐标编码,所以把帧的顺序打乱,输出只是跟着打乱。序列长度是 ,和把所有帧当成一个大图差不多;这也是为什么论文强调「轻量」——它没有为多视图额外堆 block,跨帧的计算量主要来自注意力矩阵从 变成 ,但论文通过限制跨帧层数(S/B 只有 4 层,L 8 层,H+ 11 层)和原生分辨率下的 token 预算来控制成本。
代码:跨帧注意力(官方 src/depth_pro_2/network/encoder.py,原文照录)
def cross_frame_attention(
    self, block: nn.Module, tokens: torch.Tensor, rope: torch.Tensor
) -> torch.Tensor:
    """Run one block jointly over the patch tokens of all frames."""
    num_frames, _, dim = tokens.shape
    npt = self.num_prefix_tokens
    prefix, patches = tokens[:, :npt], tokens[:, npt:]
    x = torch.cat([prefix.mean(dim=0, keepdim=True), patches.reshape(1, -1, dim)], dim=1)
    x = block(x, rope=rope.repeat(num_frames, *(1,) * (rope.ndim - 1)))
return torch.cat([prefix, x[:, npt:].reshape(num_frames, -1, dim)], dim=1)这段代码只有七行,但把论文的几个关键选择都写死了:prefix.mean(dim=0) 是跨帧平均;patches.reshape(1, -1, dim) 是把所有帧的 patch 拼成一个序列;rope.repeat(num_frames, ...) 是同一套空间 RoPE 复制 份,没有帧索引;返回时 prefix 原样保留,patch 再 reshape 回 帧。block 的权重在整个序列上共享,所以跨帧注意力不增加任何参数。
一个自然的疑问是:class/register token 被平均掉,会不会丢失每帧的全局信息?论文的假设是,DINOv3 的 class/register token 主要承载图像级的全局摘要,多帧共享一份平均摘要足以给跨帧注意力提供「这是什么场景」的上下文,而每帧的细节已经在 patch token 里。消融没有单独拆这一项,所以这个解释只能算合理但未被直接验证。
2.3 原生分辨率与 2D RoPE
边界锐度对分辨率非常敏感。Depth Pro 已经示范过「在原生分辨率上做单图深度」的收益[2],Depth Pro 2 把这件事扩展到多帧:输入不 resize,只 pad 到 32 的倍数,ViT 直接在 上跑。patch 16 意味着 一帧有约 个 patch token,32 帧就是 26 万 token;这也是为什么训练时每张 GPU 的 token 预算是 73,728,只能装下十几帧。
位置编码是 2D RoPE。DINOv3 默认的做法是每个轴独立归一化到 ,这会把宽高比信息丢掉:一个 的帧和一个 的帧在归一化后坐标范围一样。Depth Pro 2 改成两个轴都除以长边:
这样短边的坐标范围是 (或 ),宽高比被保留在坐标里。论文没有为这个改动单独给消融,但训练分辨率的消融间接说明了它的重要性:只用方形 crop(E2)会让 Waymo 的度量 掉 46.6 个点,把方形 crop resize 到 (E3)再掉 1.9 个点。Waymo 的帧是 3:2 和约 2.2:1,模型如果没见过足够的宽高比和视场,就学不会从单帧恢复度量尺度。换句话说,保留原生宽高比不只是为了边界,也是为了尺度。
DPT 解码器沿用 Depth Pro 的结构:按模型从第 2/5/8/11(S/B)、5/11/17/23(L)、7/15/23/31(H+)个 block 抽 token,重组为 四层特征图,投影到统一通道,逐级相加 skip、过残差块、用 转置卷积上采样。最后接一个全分辨率头: 分辨率特征先 卷积,再一次转置卷积回到 ,然后 卷积、ReLU、 卷积到单通道、ReLU。逆深度用 ReLU 保证非负,天空等无穷远区域自然落到 0。
代码:全分辨率逆深度头(官方 src/depth_pro_2/network/decoder.py,原文照录)
def create_inverse_depth_head(dim_in: int) -> nn.Sequential:
    """Create the head mapping 1/2-resolution decoder features to full-resolution inverse depth."""
    return nn.Sequential(
        nn.Conv2d(dim_in, dim_in // 2, kernel_size=3, padding=1),
        nn.ConvTranspose2d(dim_in // 2, dim_in // 2, kernel_size=2, stride=2),
        nn.Conv2d(dim_in // 2, 32, kernel_size=3, padding=1),
        nn.ReLU(True),
        nn.Conv2d(32, 1, kernel_size=1),
        nn.ReLU(),
    )
这个头的设计很朴素,没有 CRF、没有隐式场、没有 diffusion。论文的立场是:边界锐度主要来自「在原生分辨率上做一次前向」,而不是来自后处理或高分辨率 refinement。Table 21 支持这个立场:把 H+ 的输入短边从 360 加到原生,边界 F1 从 24.1 翻倍到 57.7,jitter 从 0.33 降到 0.24,而度量精度只涨了 1–2 个点。边界和稳定性都随分辨率单调变好,没有出现「分辨率越高、抖动越大」的 trade-off。
2.4 焦距归一化逆深度与 FoV 估计器
Depth Pro 的核心表示是「焦距归一化的逆深度」:网络不直接回归米,而是回归
其中 是图像宽度, 是焦距(像素), 是沿光轴的深度(米)。推理时
这样训练时可以把不同焦距、不同数据集的样本放在一起:网络只需要学「逆深度相对于焦距的比例」,米制尺度由焦距提供。焦距有两个来源:EXIF 里的 35mm 等效焦距,或者一个单独的 FoV 估计器。代码里这一行就是全部:
depth = None if f_px is None else f_px / (width * inverse_depth)FoV 估计器是一个 DINOv3 ViT-S/16(23.5M 参数),输入短边压到 512,宽高比保留;一个 1.9M 参数的注意力头读第 2、5、8、11 个 block 的 patch/class/register token,回归水平与垂直视场角,范围 。视频取各帧估计的中位数,假设整段视频焦距不变。论文在约 92M 张带 EXIF 的 Flickr 照片上训练它,120K 步、32 张 B200。
为什么不用「在深度编码器上挂一个头」?论文试过:在冻结的 H+ 编码器上加 1.9M 的头,平均 86.5%,还行;但同样大小的头挂在 S 上只有 74.5%,放大 8 倍到 15.1M 也只到 78.8%。小模型的编码器特征不够支撑焦距回归,所以论文选择给四个模型共享一个独立的估计器,代价是多一次前向(短边 512)和 23.5M 参数。这个取舍在工程上很合理:估计器只跑一次(视频取中位数),摊到每帧的成本很小;而如果每个模型都带一个够大的头,S/B 的参数量和延迟都会明显上升。
代码:从 FoV 到焦距(官方 src/depth_pro_2/network/fov.py,原文节选)
def median_focal_length_px(fov_deg: torch.Tensor, height: int, width: int) -> torch.Tensor:
    """The focal length in pixels at the lower median of ``(T, 2)`` FoVs of the shorter side."""
    hfov_deg, vfov_deg = fov_deg.median(dim=0).values
    if width < height:
        return 0.5 * width / torch.tan(torch.deg2rad(hfov_deg) / 2.0)
    return 0.5 * height / torch.tan(torch.deg2rad(vfov_deg) / 2.0)
这里假设正方形像素、单一焦距、主点在图像中心;估计器只预测视场角,不建模畸变、主点偏移或卷帘快门。对手机广角视频,这些假设大多成立;对鱼眼、变形宽银幕或带显著畸变的镜头,误差会直接乘进深度——焦距差 10%,所有深度就差 10%。论文在局限性里没有展开这一点,但它是这套「焦距归一化」表示的根本约束。
2.5 训练:19 个数据集,四项损失
训练数据是 19 个数据集,合成数据占绝对主导:内部合成 24.15M 帧、内部真实 3.05M 帧,加上 BEDLAM、DynamicReplica[12]、EDEN、Hypersim、IRS、MatrixCity、MegaSynth、PointOdyssey、三份 SceneFlow、两份 TartanAir、TartanGround、UrbanSyn、Virtual KITTI 2、Waymo。采样概率 ,并对小数据集设上限,避免被内部大数据集淹没。
每个 step 的 token 预算 73,728/GPU,例如 帧 。一半的 step 用完整原生帧,另一半随机裁 60–100% 的窗口,并以 0.25 的概率做 stride 2 的空间下采样;GT 深度从不插值,因为插值会在深度不连续处制造 flying pixels。clip 长度 1–32,图像视为长度 1 的 clip。总训练 100K 步、128 张 B200,AdamW,峰值学习率 ,5% warmup 后 cosine。
损失是四项无权重之和:
- :焦距归一化逆深度上的 trimmed L1,只用于有度量 GT 的数据。每张图丢掉损失最大的 比例像素,合成数据 ,真实数据 (真实 GT 噪声更大)。
- :把预测和 GT 各自归一化到零中位数、单位平均绝对偏差,再做 trimmed L1,用于所有数据。这一项让模型在只有相对深度的数据上也能学。
- :在 层高斯金字塔上匹配一阶梯度,只用于合成数据,因为真实传感器 GT 的边界不可靠。
- :多视图一致性。把帧 的像素 用预测深度反投影,再用 GT 位姿投影到帧 ,得到 ,惩罚
遮挡和运动物体违反静态场景假设:用 GT 深度把每个像素 warp 过去,若目标位置的 GT 深度差超过 2%,就丢弃这个像素。这样动态场景也能用。
四项损失各管一件事: 锚定米制尺度, 保相对深度泛化, 保边界, 保跨帧一致。消融的对应关系很干净:去掉 (I1)jitter 涨 0.05;把 换成 Depth Pro 的 6 尺度一阶边界损失(I2)边界 F1 掉 3.5 个点;换成 Depth Pro 的完整边界损失(I3)掉 3.8 个点,Waymo 度量也掉 3.3 个点;用预测置信度加权逆深度损失(I4)边界 F1 掉 6.8 个点。最后一条很有意思:模型在边界处最不确定,置信度加权恰好把这些最难学的像素的损失压下去,边界就学不好。
训练分辨率/数据组成的消融也值得记一笔:只用方形 crop(E2)Waymo 掉 46.6;方形 crop 再 resize 到 1536(E3)掉 48.5;冻结 DINOv3(H2)Waymo 掉 13.1、ARKitScenes 掉 29.4;换成 DINOv2(H1)ARKitScenes 掉 12.8;去掉所有真实数据(D2)Waymo 掉 5.5、ARKitScenes 掉 12.3,但边界反而更锐;去掉所有内部数据(D4)Waymo 涨 3.2、边界更锐、jitter 更低,但 ARKitScenes 掉 45.2。论文的结论是内部数据提升了分布外泛化,代价是边界和稳定性。这些数字放在一起,说明 Depth Pro 2 的强项不是某个单点技巧,而是数据、分辨率、损失三者一起撑起来的。
仓库没有训练代码,所以这一节没有官方实现可贴;论文也只给了损失的文字定义和上面这个 公式,没有给 的逐项系数。复现时这部分只能按 Depth Pro 的公开实现去对。
2.6 流式推理:缓冲窗口与因果缓存
训练最长 32 帧,但视频可以任意长。论文给了两种推理方式。
缓冲流式把视频切成 帧的 clip,相邻 clip 重叠 帧,每个 clip 独立跑一次完整的前向。重叠区的两套预测按帧位置线性 cross-fade:越靠近前一个 clip 的末尾,前一套权重越大;越靠近后一个 clip 的开头,后一套权重越大。默认 。这样一帧要等它所在的 clip 凑满才能输出,延迟是 帧;但每一帧都同时看到了前面和后面的帧,质量最好。
无缓冲流式每来一帧就立刻输出。跨帧注意力改成因果的:当前帧只能看自己和之前的 帧。之前帧的 key/value 一旦算好就不再变,放进一个 FIFO 的 KV cache;只有跨帧层用 cache,帧内层仍然只处理当前帧。默认 。第一帧没有历史,前几帧的稳定性会差一些;之后每多缓存一帧,延迟约 ms、显存约 GiB。
代码:重叠区的线性 cross-fade(官方 src/depth_pro_2/streaming.py,原文照录)
def blend_ramp(length: int, like: torch.Tensor) -> torch.Tensor:
    """Weights from 1 to 0 across ``length`` frames, endpoints excluded so the seam has no step."""
    return torch.linspace(1, 0, length + 2, device=like.device, dtype=like.dtype)[1:-1].view(
        -1, 1, 1
    )
linspace(1, 0, length + 2)[1:-1] 生成的是长度为 length、从 到 的权重,端点不取 0 和 1,所以接缝处不会出现阶跃。这个细节很小,但正是「clip 边界不跳」的关键:如果权重取到 0/1,重叠区的第一帧和最后一帧就完全由某一个 clip 决定,两个 clip 的预测只要有微小偏差,接缝就会闪一下。
两种模式在 300 帧 DynamicReplica 上的质量几乎一样(Table 22)。缓冲 与无缓冲 相比,H+ 的度量 是 99.2 对 99.1,相对 99.1 对 99.1,边界 F1 57.4 对 57.1,jitter 0.291 对 0.300;S/B/L 的差异也都在 0.6 个点以内。缓冲模式略好,但无缓冲模式没有 帧的启动延迟,适合直播或机器人。
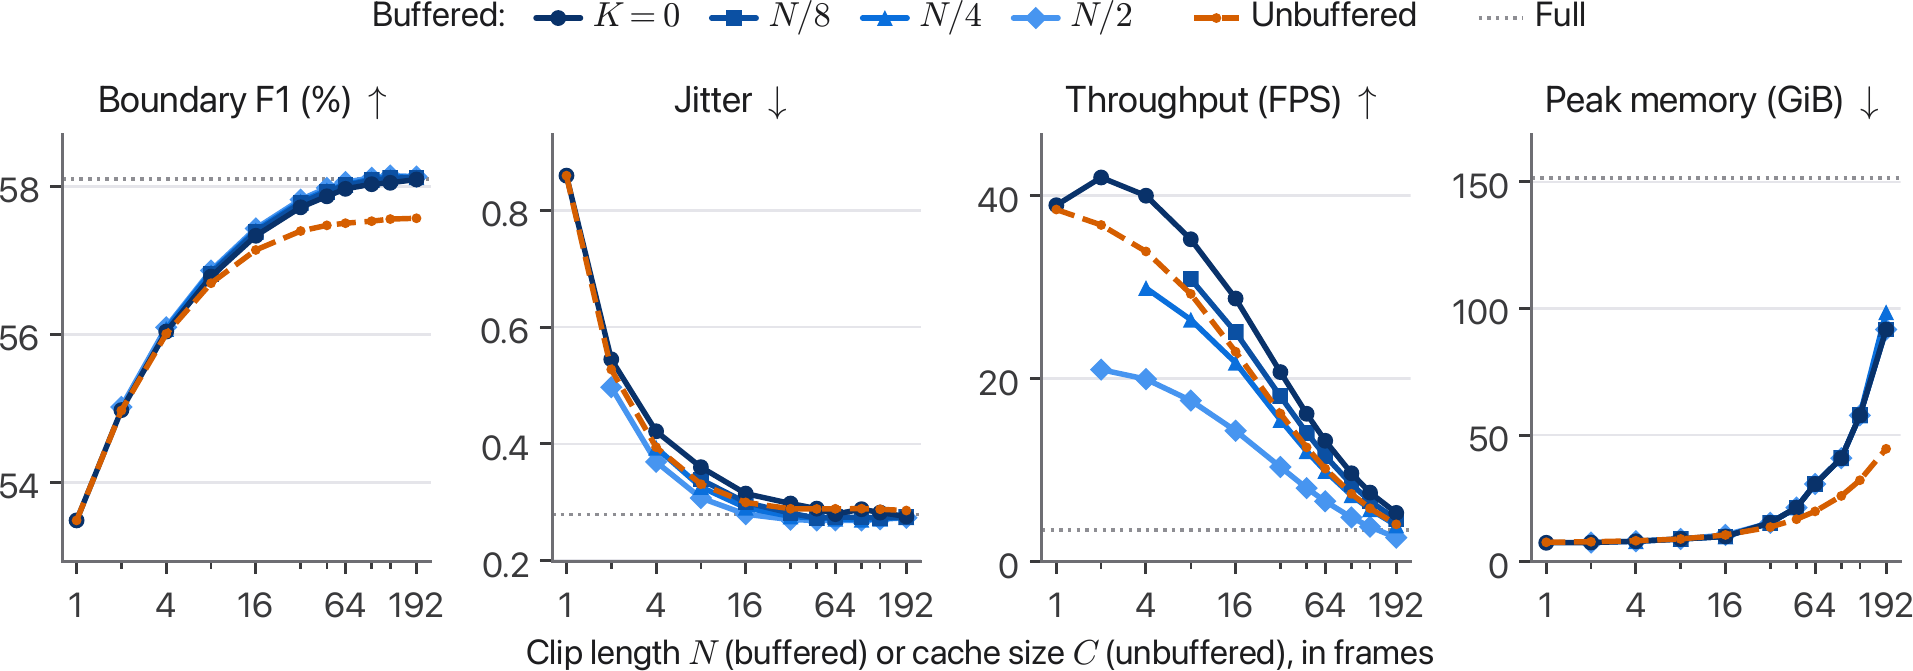
这张图里有几个值得记住的拐点。缓冲模式从 到 ,jitter 从 0.860 降到 0.280,边界 F1 从 53.5 升到 58.0;大部分收益在前 8 帧就拿到了(超过 85% 的 jitter 降幅)。 时已经和一次跑完 300 帧(jitter 0.279)持平,但吞吐是后者的 3.8 倍、峰值显存只有后者的 1/5(后者 151.5 GiB、3.5 FPS)。无缓冲模式 时 jitter 0.860, 降到 0.300, 之后基本平在 0.289——32 正好是最长训练 clip 的长度。超过 32 再加 cache,收益很小,成本却线性涨。
把滑块从 拖到 16,再拖到 64:jitter 在 16 帧时已经拿到大部分收益,64 帧只是再降 0.018;但吞吐从约 93 FPS 掉到 7 FPS,显存从 8 GiB 涨到 27 GiB。把模式切到无缓冲, 和 的质量差不到 0.011,延迟却从 44 ms 涨到 62 ms。这就是论文推荐 16/4 和 16 的原因:它们都在「质量基本饱和、成本还没起飞」的拐点上。需要说明的是,上面的质量曲线是按 Figure 10 的关键点插值的,吞吐按 折算,显存按图中读数插值;它适合比较趋势,不适合当作复现实验的精确数字。
2.7 模型家族
Depth Pro 2 有 S/B/L/H+ 四档,分别从 DINOv3 ViT-S/16、ViT-B/16、ViT-L/16、ViT-H+/16 初始化,patch 都是 16。跨帧 block 的选择随模型变大而增多:S/B 是第 5、7、9、11 层(4 层),L 是第 9 到 23 的奇数层(8 层),H+ 是第 11 到 31 的奇数层(11 层)。DPT 解码器的通道和层数也随模型放大。
| 模型 | 参数量 | / | 跨帧 block | 权重 | 1080p FPS / 显存 |
|---|---|---|---|---|---|
| S | 24.3M (21.6 + 2.7) | 12 / 384 | 5, 7, 9, 11 | 97 MB | 44.8 FPS 8.0 GiB |
| B | 96.5M (85.6 + 10.9) | 12 / 768 | 5, 7, 9, 11 | 386 MB | 23.6 FPS 14.0 GiB |
| L | 334.0M (303.1 + 30.9) | 24 / 1024 | 9, 11, …, 23 | 1.3 GB | 9.1 FPS 21.7 GiB |
| H+ | 872.1M (840.5 + 31.6) | 32 / 1280 | 11, 13, …, 31 | 3.5 GB | 5.3 FPS 29.5 GiB |
四档共享同一个 23.5M 参数的 FoV 估计器(94 MB)。Table 13 的参数量把估计器算进去,所以是 48M / 120M / 357M / 896M;上表按论文 Table 1 只算深度网络本身,避免和「每档都带一个估计器」的账混在一起。1080p 的 FPS/显存来自 Table 13 的缓冲流式、32 帧一次前向,包含 FoV 估计器;无缓冲模式的 Figure 12 数字更高:S 约 53 FPS、B 约 35 FPS、L 约 18 FPS、H+ 约 8 FPS(,焦距已知)。
四档的质量差距不小,这一点后面会展开:S 的 1080p 缓冲吞吐是 H+ 的 8.5 倍,显存只有 1/3.7,但视频边界 F1 只有 25.7(Sintel)对 43.4,jitter 2.43 对 1.39。所以「Depth Pro 2 能实时」和「Depth Pro 2 的 SOTA」其实指的是不同的档位,选型时不能只看标题数字。
三、实验
3.1 零样本度量深度
评测协议分两套。单图设置(Table 2)里,视频和多视图数据集的前 50 帧被逐帧打分,所有方法都只看到单帧;视频设置(Table 3)里,每个方法拿到同样的 50 帧 clip,单图方法仍然逐帧处理。两套都分别在 GT 内参和预测内参下评测;预测内参只有能估焦距的方法才有。数据集是 iBims、Middlebury、Booster、HAMMER、ETH3D、DIODE、KITTI、nuScenes、Sintel[13]、Spring[14]、DyDToF,共 11 个,论文说它们对大多数方法是零样本的。
H+ 在单图设置下的平均排名是 2.4(GT 内参)/ 2.7(预测内参),视频设置是 1.0 / 1.2,都是第一。具体数字里最硬的是 KITTI 98.2、ETH3D 97.8、DIODE 74.2、iBims 94.4、HAMMER 89.4、nuScenes 90.9;视频设置里 KITTI 98.1、Sintel 51.2、Spring 51.7、DyDToF 86.2。作为对比,单图平均排名第二梯队的 UniK3D-L[15] 是 3.6/3.1,UniDepthV2-L[16] 是 4.5/4.0;同表的 MoGe-2-L[17] 和 MoGe-3-G[18] 分别是 5.6/6.2 和 6.2/6.4。视频设置里 UniDepthV2-L 是 3.0/3.0,UniK3D-L 是 4.5/3.8。H+ 不是每个数据集都第一(iBims 输给 UniK3D/UniDepthV2/DA3,Booster 输给 DAGE/UniDepthV2/UniK3D/DA3,nuScenes 输给 UniK3D/UniDepthV2),但平均排名拉开了明显差距。
单看表 2 会发现两个不太对劲的地方,值得单独说。第一,H+ 在 Spring 的单图 只有 20.5,预测内参下 37.0,而视频设置下同一数据集是 51.7/45.0——同一批帧、同一个模型,联合处理比逐帧处理高了 30 多个点。论文没有解释这个差距,我倾向于认为 Spring 的单帧确实缺少恢复度量尺度所需的上下文,但这一点无法从正文确认,引用这组数字时要小心。第二,Booster 的 GT 内参 65.7、预测内参 43.1,掉了 22.6 个点;HAMMER 89.4→86.3、KITTI 98.2→87.9 也都有明显下降。这说明 FoV 估计器的误差会直接乘进度量深度,焦距估计仍然是这套方法的单点故障。
3.2 边界锐度与时间一致性
边界 F1 用 Depth Pro 的定义:在 GT 深度不连续处,比较预测深度图的边缘与 GT 边缘的匹配程度。H+ 在单图设置下平均排名 1.6,视频设置 1.3,都是第一。单图里它在 iBims 20.5、M.bury 21.9、Spring 16.3、DyDToF 31.6 上领先,但 Sintel 40.2 输给 InfiniDepth 44.8;视频里它在 Spring 16.8、DyDToF 34.4 上领先,Sintel 43.4 又输给 InfiniDepth 44.8。所以「平均第一」不等于「每个数据集第一」,InfiniDepth 在 Sintel 这类高频细节多的合成场景上仍然很强。
时间一致性用 jitter:对相邻帧的对应像素,比较深度变化与 GT 光流/遮挡掩码解释的变化之间的偏差,数值越低越稳。H+ 在 Sintel 1.39、Spring 0.86,平均排名 1.5;第二梯队的 VGGT-Ω-1B[19] 是 2.36/0.99,π³ 是 2.13/1.04,DepthCrafter 是 2.09/1.07。单图方法的 jitter 高一个数量级:Depth Pro 11.26/8.99,InfiniDepth 7.66/9.48。这个差距和图 2 的散点一致。
论文还把 jitter 和另一套指标 TAE(Temporal Alignment Error)做了对比。TAE 用 GT 位姿把预测深度重投影到下一帧,测相对误差;H+ 在 Sintel 上 TAE 2.05 是全场最好(VDA 3.98、π³ 3.71),但 Spring 0.90 输给 VeloDepth 0.61,ScanNet 0.51 输给 π³ 0.39,KITTI 4.04 输给 VeloDepth 3.30,平均排名 3.8,排在 VeloDepth(3.5)和 VDA(3.6)之后。论文对此的解释是 TAE 在遮挡处有歧义、对稀疏/低质量 GT 不可靠,而且「偏爱更模糊的预测」——Table 12 里把 H+ 自己的深度模糊 后,Sintel TAE 从 2.05 涨到 8.80,Spring 从 0.90 涨到 0.92,但 ScanNet 从 0.51 降到 0.42,Bonn 从 3.61 降到 2.70,KITTI 从 4.04 降到 2.56——在稀疏/低质量 GT 的数据集上确实有「越糊越好」的倾向,在 Sintel/Spring 这类高质量稠密 GT 上则不成立。这个解释有数据支撑,但也说明 H+ 并不是在所有一致性指标上都快照式领先;如果你的下游用的是 TAE 一类重投影指标,VeloDepth/VDA 仍然值得对比。
3.3 焦距估计
H+ 的 FoV 估计器在 6 个数据集上的平均 是 88.6%,六个数据集全部第一;Depth Pro 71.7%,UniK3D-L 57.8%,AnyCalib[20] 54.2%,DA3-NGL 53.2%,UniDepthV2-L 48.8%,GeoCalib[21] 45.5%。分数据集看,DDDP 95.0、FiveK 89.0、PPR10K 80.2、RAISE 97.2、SPAQ 86.0、ZOOM 84.5。ZOOM 和 PPR10K 是最难的两个,说明长焦/大光圈和后期裁剪仍然会让视场估计失准。
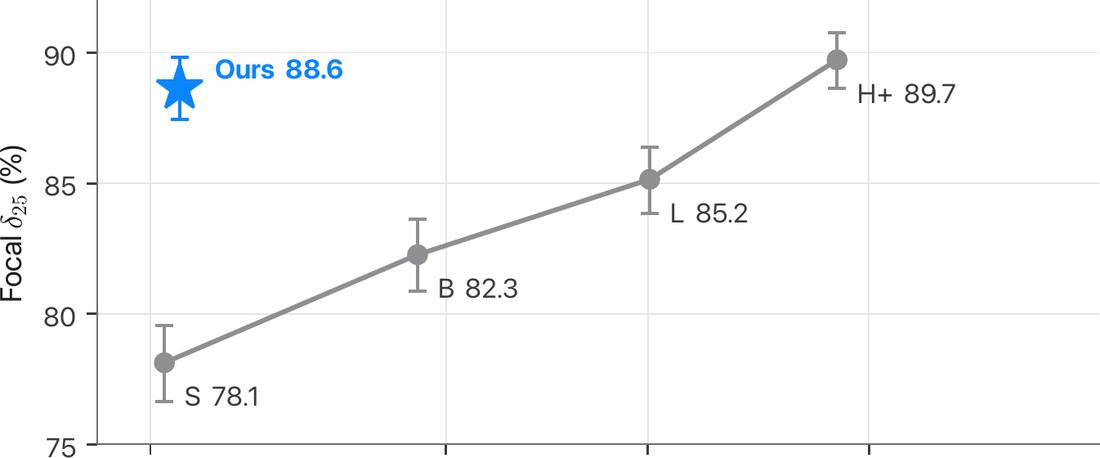
这张图是论文「独立估计器 + 小模型」选择的核心证据:如果把估计器绑在深度编码器上,S 只有 74.5,H+ 才有 86.5;独立训练一个 ViT-S 估计器,反而在 23.5M 参数下拿到 88.6,超过同配方的 ViT-L(85.2),逼近 ViT-H+(89.7)。代价是每个模型都要多跑一次 512 短边的前向。对 S 来说这是 8% 的额外计算,对 H+ 只有 0.5%,所以这个设计对四档都划算。
3.4 下游应用:散景与新视角
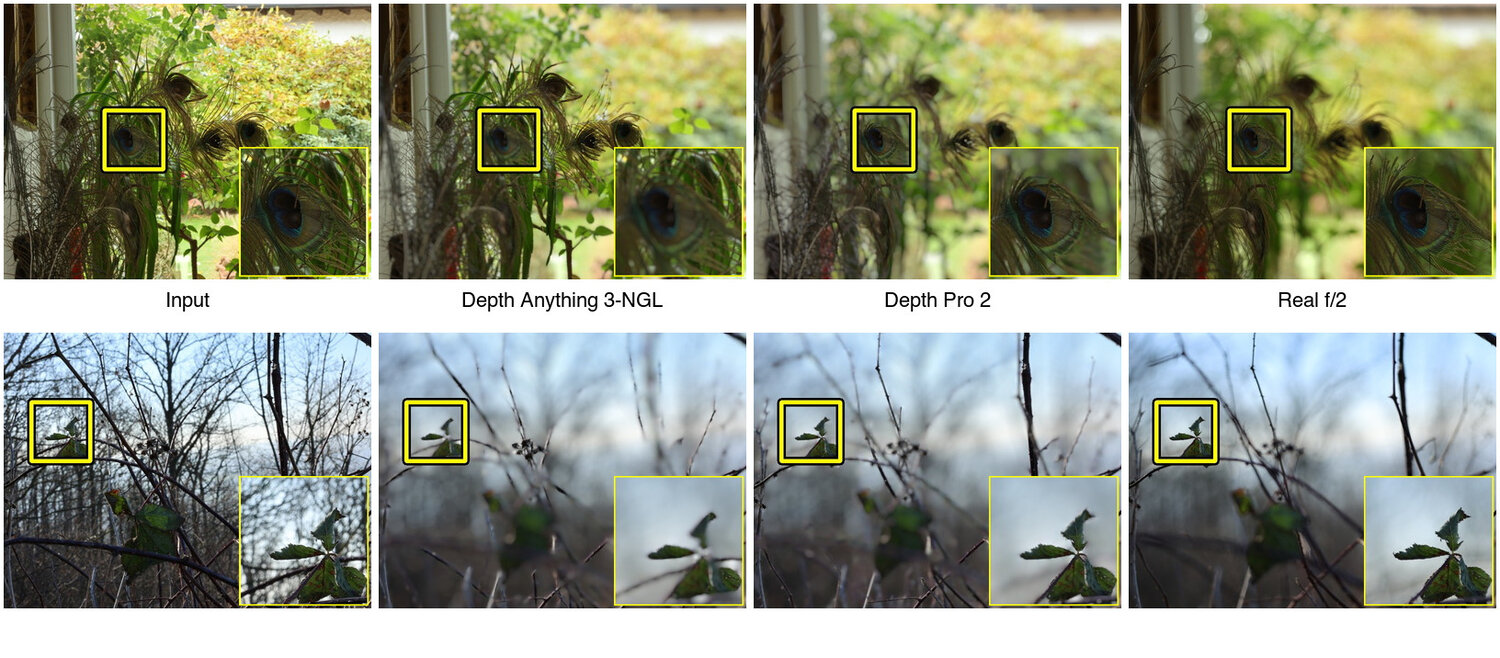
深度边界最直接的下游是深度引导的散景。论文把各方法的度量深度送进同一个冻结的 BokehMe 渲染器[22],在 RealBokeh 的 220 个测试场景上比较,不做任何逐图对齐或拟合。H+ 的 PSNR 23.95、SSIM 0.858、LPIPS 0.291、Boundary LPIPS 0.476、DISTS 0.215,五项全是最好;Depth Pro 是 23.20/0.838/0.319/0.530/0.236,MoGe-3-G 是 23.28/0.841/0.313/0.525/0.223,DA3-NGL 在原生分辨率下是 22.47/0.831/0.341/0.630/0.290。Boundary LPIPS 的差距最大(0.476 对 0.530),这正是散景最容易露馅的地方:前景和后景的过渡带一旦深度糊了,毛发和栏杆周围就会出现光晕。
新视角合成只有定性结果(Figure 9),没有表格:用单图深度把输入反投影成点云,再从前向/侧向的新视角渲染,Depth Pro 2 的边界更干净,Depth Pro 在细结构处会出现拉伸。论文没有给 NVS 的定量指标,所以这部分只能作为「边界更好」的旁证,不能当作独立结论。
3.5 运行时与显存
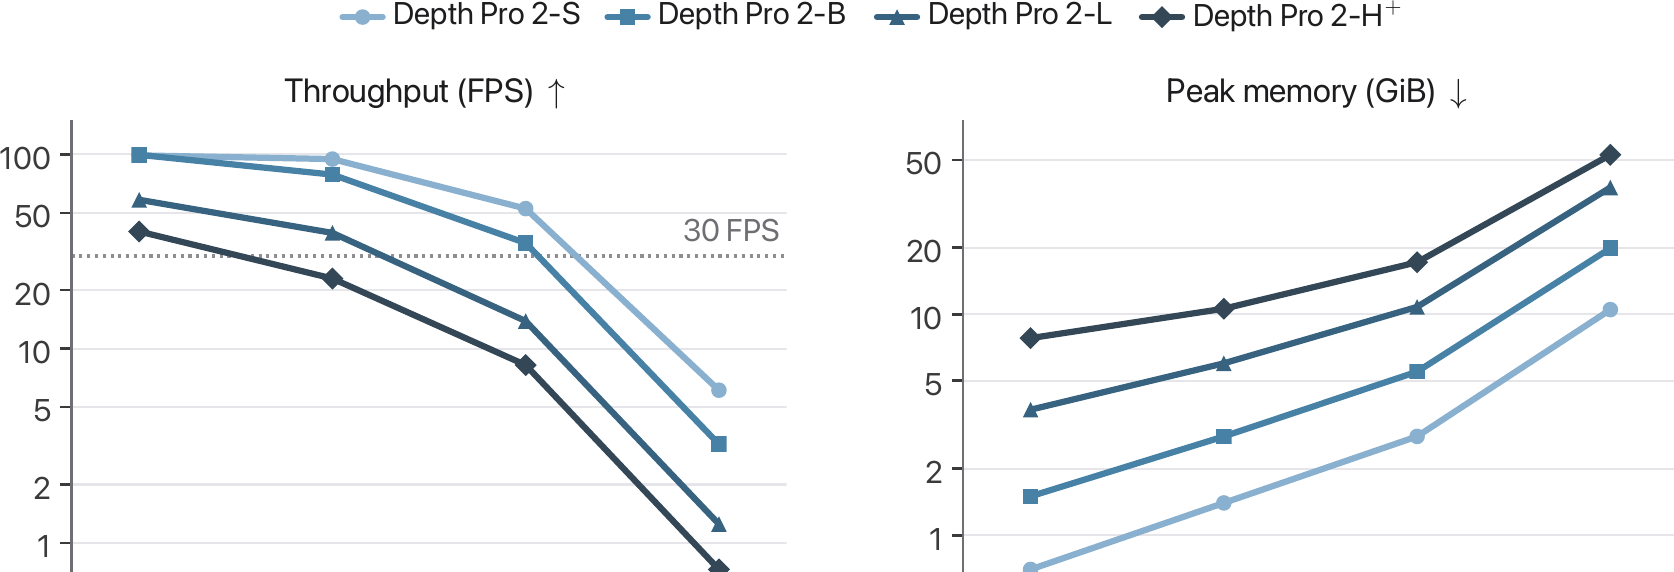
所有 runtime 数字都在一张 B200 上、PyTorch eager、bf16 autocast、不用 torch.compile 的条件下测得;输入是同一段 32 帧 Spring clip,缩放到 VGA/720p/1080p/4K。Depth Pro 2 的吞吐包含 FoV 估计器,baseline 也尽量按其官方推理代码计入各自的前后处理。
| 方法 | 参数量 | VGA | 720p | 1080p | 4K | 1080p 峰值显存 |
|---|---|---|---|---|---|---|
| Depth Pro 2-S | 48M | 347.0 | 143.9 | 44.8 | 3.6 | 8.0 GiB |
| Depth Pro 2-B | 120M | 269.7 | 82.5 | 23.6 | 1.8 | 14.0 GiB |
| Depth Pro 2-L | 357M | 150.1 | 33.7 | 9.1 | 0.7 | 21.7 GiB |
| Depth Pro 2-H+ | 896M | 95.9 | 20.2 | 5.3 | 0.4 | 29.5 GiB |
| DA3-NGL | 1540M | 24.6 | 4.2 | 1.0 | OOM | 114.6 GiB |
| VGGT-1B | 1191M | 26.6 | 4.1 | 0.9 | OOM | 68.0 GiB |
| π³ | 959M | 35.0 | 5.4 | 1.2 | 0.1 | 24.9 GiB |
| Depth Pro(1536×1536) | 951M | 23.5 | 23.5 | 23.4 | 23.4 | 8.0 GiB |
H+ 在 1080p 上是 DA3 的 5.3 倍吞吐、约 1/4 显存,参数量还少 0.6B;VGA 上差距更大(95.9 对 24.6)。这得益于原生分辨率下的 token 数控制和较浅的跨帧层数,而不是单纯靠模型小。但 H+ 的绝对成本仍然很高:1080p 5.3 FPS、29.5 GiB,4K 只有 0.4 FPS、114.6 GiB——4K 基本不可用。S 是唯一在 1080p 上超过 30 FPS 的档位(44.8),4K 也有 3.6 FPS,但质量要打折。
Mac 上的 Core ML demo 给了一个消费级硬件的参照:M4 Max、854×480、 时,S 26 ms(39 FPS)、B 60 ms(16 FPS)、L 188 ms(5 FPS)、H+ 375 ms(2 FPS);1280×720 时 S 88 ms(11 FPS)、H+ 1233 ms(不到 1 FPS)。所以「在笔记本上实时」目前只对 S/B 的低分辨率成立,H+ 的 3.5 GB 权重和计算量不是为端侧准备的。
3.6 消融:跨帧注意力与分辨率各自管什么
论文在 H+ 上做了两组推理期消融,正好把「稳定」和「锐利」拆开。第一组随机断开帧与帧之间的跨帧连接,断开比例从 0 到 100%,所有跨帧层用同一个 dropout 模式;第二组把输入短边缩到 360/540/720 或保留原生。
把断开比例从 0 拖到 80:四个数字里只有 jitter 在动(0.24→0.76),度量 δ1 稳在 98.9,边界 F1 从 57.7 缓降到 56.7;拖到 100 才看到边界 F1 掉到 53.4、度量掉到 98.1。这说明跨帧注意力对「稳定」是因果性的,对「锐利」则有大量冗余——只要还有一部分帧间连接,边界就基本保得住。切到分辨率实验:360→720 时边界 F1 翻倍、jitter 降 0.09,而度量只涨 0.7(Waymo)和 2.1(ARKitScenes)个点;720→原生时 DynamicReplica 的边界 F1 和 jitter 不变(它的原生短边就是 720),Waymo 的度量 δ1 也只再涨 0.4 个点。两组消融拼起来,正好对应论文的核心叙事:跨帧注意力管稳定,原生分辨率管锐利,两者互不替代。
四、局限性
4.1 论文承认的
论文没有单独的 Limitations 一节,但在正文和附录里明确承认了几点:
- jitter 和 TAE 都不是完美指标。jitter 依赖稠密 GT 光流和遮挡掩码,只能在 Sintel/Spring 这类数据集上算;TAE 假设静态场景、在遮挡处有歧义、对稀疏/低质量 GT 会给出非零的 GT 误差,而且偏爱更模糊的预测(Table 12 里把预测模糊化反而降低了 ScanNet/Bonn/KITTI 的 TAE)。
- FoV 估计器只估计视场角,假设正方形像素、单一焦距、主点在中心,不建模畸变、卷帘快门或变焦;视频取所有帧的中位数,默认整段焦距不变。
- 评测集有限。度量深度只覆盖 11 个数据集,其中 10 个沿用 Depth Pro/MoGe-3 的评测集,新增的 DyDToF 是合成的;真实室内场景的 Kinect 类 GT 被排除,因为噪声和缺失太严重。
4.2 我补充的
- 标题数字基本来自 H+,但 H+ 不是能实时跑的那一档。正文的 2.4/2.7、1.0/1.2、1.6/1.3、1.5 都是 H+;H+ 在 1080p 缓冲模式下只有 5.3 FPS、29.5 GiB,4K 直接掉到 0.4 FPS、114.6 GiB。S 能到 44.8 FPS,但视频边界 F1 只有 25.7(Sintel)对 43.4,jitter 2.43 对 1.39,度量 KITTI 93.8 对 98.1。论文的「实时」和「SOTA」是两个档位,选型时必须一起看。
- Spring 的单图数字是个未解释的异常。H+ 单图 20.5/37.0,视频 51.7/45.0:同一批帧、同一个模型,联合处理在 GT 内参下高 31 个点,预测内参下只高 8 个点;而 MapAnything 单图 96.7、DAGE 91.3,又远高于 H+。论文没有分析这个数据集上的取帧/对齐协议,也没有解释为什么联合处理能带来这么大的提升。引用平均排名时,这个异常值会显著影响结论。
- 预测内参的代价很大。Booster 65.7→43.1、KITTI 98.2→87.9、HAMMER 89.4→86.3,焦距估计的误差直接乘进深度;FoV 估计器的平均 δ25 是 88.6%,意味着仍有 11.4% 的图焦距误差超过 25%,这些图的米制深度基本不可用。对没有 EXIF 的视频,这是最大的实际风险。
- 绝对精度仍有明显短板。Spring 单图 20.5、Booster 预测内参 43.1、Sintel 预测内参 43.4,这些数字说明「平均排名第一」掩盖了部分数据集上的低绝对精度。平均排名对每个数据集等权,H+ 在容易的数据集上接近满分,在难的数据集上并不比 UniDepthV2/UniK3D 好多少。
- 边界 F1 的比较混用了不同推理分辨率。论文说每个方法跑自己的默认分辨率,但默认分辨率差别很大:Depth Pro 固定把输入 resize 到 1536×1536,DA3-NGL 的默认推理分辨率可以低到 504×378,H+ 则按数据集原生分辨率处理(在 RealBokeh 上是 2002×1498)。边界 F1 本来就随分辨率变,所以「H+ 边界最锐」有一部分是「H+ 处理的分辨率最高」;论文的原生分辨率主张是对的,但跨方法的边界比较并不是完全同条件的。
- 训练不可复现。仓库只有推理代码,没有训练、评测、数据混合和损失实现;论文给了 的公式,但 的系数、数据采样的细节、内部数据集的构成都没有公开。权重许可只允许非商业研究,商业使用需要另谈。
- 端侧部署仍有距离。Core ML demo 只在 M4 Max 上把 S 跑到 854×480 的 39 FPS(),H+ 只有 2 FPS;1280×720 的 S 是 11 FPS。论文的 B200 数字不能直接外推到笔记本或手机。
- 流式模式有固有的延迟/启动代价。缓冲模式要等 帧才开始输出,默认 16 帧在 30 FPS 下是约 0.53 s 的延迟;无缓冲模式没有启动延迟,但前几帧缺少历史,稳定性差一些,而且 cache 的显存随 线性增长( 已经 10.6 GiB)。对长视频,两种模式都只保留窗口内的帧,不会随视频长度增长,这是优点;但窗口大小本身就是一个需要按硬件调的参数。
五、结论与展望
Depth Pro 2 的核心不是某个新模块,而是一个很克制的系统组合:用 DINOv3 的跨帧注意力买稳定性,用原生分辨率买锐利,用焦距归一化表示买度量尺度,用混合数据和四项损失把三者绑在一起。跨帧注意力只改注意力范围、不加参数;原生分辨率只改预处理和 RoPE 归一化、不换网络;焦距归一化沿用 Depth Pro 的表示;流式推理只是把同一个网络按 clip 或 KV cache 切开。每一块都不新,但组合起来确实同时推高了三个通常互相拉扯的指标,这是论文最有说服力的地方。
从工程角度看,最值得借鉴的是「不为多视图新增参数」和「训练时混合 1–32 帧」这两个决定。前者让 S/B 这样的小模型也能做多帧,后者让同一个模型在单图和视频之间不需要切换。相比之下,很多视频深度方法为了时序稳定专门设计模块或扩散先验,参数量和推理成本都上去了,却在边界上输给单图模型;Depth Pro 2 说明,如果编码器本身够强、分辨率够高,跨帧注意力可以做得非常薄。
下一步值得关注的是:训练代码和评测代码是否会开源(目前没有,复现门槛很高);权重许可是否会放宽到商业可用;FoV 估计器能否扩展到畸变、主点和变焦;以及这套原生分辨率的流式方案能否在手机/头显的算力上落地——目前只有 S 在 M4 Max 的低分辨率下接近实时。如果这几个问题解决,Depth Pro 2 就不只是一篇 benchmark 论文,而是一个能进产品的深度基础设施。
六、上手
官方仓库只含推理,安装和运行都很短。需要 Linux 或 Apple silicon Mac、Python 环境由 uv 管理;第一次运行会下载权重(默认 H+ 3.5 GB,-m depthpro2-s 用 97 MB 的 S)。
安装与命令行推理
git clone https://github.com/apple-aiml-research/ml-depth-pro-2
cd ml-depth-pro-2
uv run depth-pro-2 predict -i assets/example.jpg -o out/    # 单图
uv run depth-pro-2 predict -i assets/example.mp4 -o out/    # 视频,默认缓冲 16/4
uv run depth-pro-2 predict -i assets/example.jpg -o out/ -m depthpro2-s  # 笔记本上用 S
输出默认是彩色深度图(红近蓝远);加 --save-png16 得到 16-bit 灰度逆深度,加 --save-npz 得到以米为单位的 depth 和 focallength_px。视频默认 --mode buffered --window 16 --overlap 4;直播场景用 --mode unbuffered --window 16。
Python API:单图、视频、直播流
import av
from depth_pro_2 import create_model_and_transforms, load_rgb, upright

model, transform = create_model_and_transforms("depthpro2-h")

# 单图;f_px 来自 EXIF,没有就传 None,让 FoV 估计器接手
image, f_px = load_rgb("assets/example.jpg")
depth = model.infer(transform(image), f_px=f_px)["depth"]  # 米,形状 (H, W)

# 视频文件:16 帧一个 clip,重叠 4 帧
video = av.open("assets/example.mp4")
frames = (transform(upright(f)) for f in video.decode(video=0))
for prediction in model.infer_video(frames):
    depth = prediction["depth"]

# 直播流:每帧到达就输出
stream = model.stream(mode="unbuffered")
for f in av.open("assets/example.mp4").decode(video=0):
    for prediction in stream.step(transform(upright(f))):
        depth = prediction["depth"]
Mac Core ML demo
uv run --extra coreml python -m demo.export stream -m depthpro2-s -w 4
./demo/run.sh depthpro2-s_480x854_w4.mlpackage几个容易踩的坑:infer 把 (T, 3, H, W) 的 stack 当成一个 clip,帧之间会互相注意并共享一个焦距;不相关的照片要一张一张传,不要 pad/resize 成同一尺寸,否则深度会变。infer_video 的 f_px 默认取前 16 帧的 FoV 中位数,之后固定;如果视频中途变焦,需要自己分段。depth 是沿光轴的距离,不是到相机的欧氏距离;天空可能是无穷大,也可能是几公里,做点云前要先裁剪。权重的许可是 research-only,商用需要联系 Apple。
参考
- Peiyun Hu, Marko Mihajlovic, Lyndon Duong, Lahav Lipson, Wei Dong, Amaël Delaunoy, Stephan R. Richter, Vladlen Koltun. Depth Pro 2: Sharp and Temporally Consistent Metric Monocular Depth. arXiv 2611.26603, 2026. arXiv
- Bochkovskii, Delaunoy, Germain, Santos, Zhou, Richter, Koltun. Depth Pro: Sharp Monocular Metric Depth in Less Than a Second. ICLR 2025. arXiv · 代码
- Yu, Lin, Wang, Li, Wang, Zhang, Wang, Zhou, Hu, Peng. InfiniDepth: Arbitrary-Resolution and Fine-Grained Depth Estimation with Neural Implicit Fields. CVPR 2026. arXiv · 代码
- He, Li, Sheng, Chen. Lotus-2: Advancing Geometric Dense Prediction with Powerful Image Generative Model. arXiv 2512.01030, 2026. arXiv
- Wang, Zhou, Zhu, Chang, Zhou, Li, Chen, Pang, Shen, He. π³: Permutation-Equivariant Visual Geometry Learning. ICLR 2026. arXiv · 代码
- Wang, Chen, Karaev, Vedaldi, Rupprecht, Novotny. VGGT: Visual Geometry Grounded Transformer. CVPR 2025. arXiv · 代码
- Lin, Chen, Liew, Chen, Li, Zhao, Peng, Guo, Zhou, Shi, Feng, Kang. Depth Anything 3: Recovering the Visual Space from Any Views. ICLR 2026. arXiv · 代码
- Keetha, Müller, Schönberger, Porzi, Zhang, Fischer, et al.. MapAnything: Universal Feed-Forward Metric 3D Reconstruction. 3DV 2026. arXiv · 代码
- Hu, Gao, Li, Zhao, Cun, Zhang, Quan, Shan. DepthCrafter: Generating Consistent Long Depth Sequences for Open-world Videos. CVPR 2025. arXiv · 代码
- Siméoni, Vo, Seitzer, Baldassarre, Oquab, Jose, Khalidov, et al.. DINOv3. TMLR 2026. arXiv
- Ranftl, Bochkovskiy, Koltun. Vision Transformers for Dense Prediction. ICCV 2021. arXiv
- Karaev, Rocco, Graham, Neverova, Vedaldi, Rupprecht. DynamicStereo: Consistent Dynamic Depth from Stereo Videos. CVPR 2023. arXiv
- Butler, Wulff, Stanley, Black. A Naturalistic Open Source Movie for Optical Flow Evaluation. ECCV 2012. PDF
- Mehl, Schmalfuss, Jahedi, Nalivayko, Bruhn. Spring: A High-Resolution High-Detail Dataset and Benchmark for Scene Flow, Optical Flow and Stereo. CVPR 2023. arXiv
- Piccinelli, Sakaridis, Segu, Yang, Li, Abbeloos, Van Gool. UniK3D: Universal Camera Monocular 3D Estimation. CVPR 2025. arXiv · 代码
- Piccinelli, Sakaridis, Yang, Segu, Li, Abbeloos, Van Gool. UniDepthV2: Universal Monocular Metric Depth Estimation Made Simpler. TPAMI 2025. arXiv · 代码
- Wang, Xu, Dong, Deng, Xiang, Lv, Sun, Tong, Yang. MoGe-2: Accurate Monocular Geometry with Metric Scale and Sharp Details. NeurIPS 2025. arXiv · 代码
- Kong, Li, Wang, Xu, Yao, Xiang, Yang. MoGe-3: Fine-Detail Monocular Geometry Estimation with Self-Guided Sparse Volumetric Refinement. NeurIPS 2026. arXiv · 代码
- Wang, Chen, Zhang, Karaev, Schönberger, Labatut, Bojanowski, Novotny, Vedaldi, Rupprecht. VGGT-Ω. CVPR 2026. arXiv · 代码
- Tirado-Garín, Civera. AnyCalib: On-Manifold Learning for Model-Agnostic Single-View Camera Calibration. ICCV 2025. arXiv · 代码
- Veicht, Sarlin, Lindenberger, Pollefeys. GeoCalib: Learning Single-image Calibration with Geometric Optimization. ECCV 2024. arXiv · 代码
- Peng, Cao, Luo, Lu, Xian, Zhang. BokehMe: When Neural Rendering Meets Classical Rendering. CVPR 2022. arXiv