· 69 min read
论文解读:DISK,用策略梯度直接优化匹配数
TL;DR DISK(DIScrete Keypoints)是 EPFL 与 Google Research Zürich 在 NeurIPS 2020 提出的端到端局部特征学习器[1]。它既不把检测器输出过一个可微的 argmax,也不靠关键点标注:网络对每个 8×8 网格单元输出一张热图,先按 softmax 采样一个像素,再用 sigmoid 决定接不接受,把「选哪些点」看成一个随机策略;训练时用 REINFORCE 直接最大化下游匹配的期望奖励,而匹配本身用行/列 softmax 松弛成概率分布,于是整个期望匹配数可以闭式求和,梯度里没有匹配采样的方差。1.1M 参数的 U-Net 在 MegaDepth 上用深度重投影奖励从零训练,IMC 2020 的 2k 类别拿到 stereo mAA 0.5132、multiview 0.7271(相对最佳基线 +9.4% / +6.7%),是当时不用学习型匹配器的第一名;HPatches AUC@5px 为 0.689(2k)/0.698(8k),比 RFP 相对高 12%。代码与权重以 Apache 2.0 开源。
- 论文:DISK: Learning local features with policy gradient,Michał Tyszkiewicz、Pascal Fua、Eduard Trulls,EPFL / Google Research Zürich,NeurIPS 2020,2020 年 6 月 30 日(v2 2020 年 10 月 27 日)。
- 代码:github.com/cvlab-epfl/disk(Apache 2.0,含 depth / epipolar 权重与训练代码)
- 前作 / 预备知识:SuperPoint(网格检测与单应自适应)、D2-Net(描述子即检测器)、R2D2(可重复性与可靠性)、LoFTR(论文展望里的学习型匹配器)、RaCo(同样用策略梯度训练检测器)。
一、动机:检测器的 argmax 挡住了梯度
局部特征通常由两步组成:先找关键点,再算描述子。SIFT 用 DoG 找极值、用梯度直方图定方向,再用手工描述子,二十年过去仍是很多流水线里的强基线[2]。深度学习时代的第一波工作把描述子单独拿出来学,关键点仍沿用 SIFT 的检测结果;后来的端到端方法则试图把检测和描述一起学,但 detection 这一步始终有个麻烦:最终要取 argmax / NMS,而 argmax 不可导。
已有的绕法各有各的妥协。SuperPoint 把图像划成网格,每个单元加一个「没有特征」的 dustbin,用 softmax 选一个位置,检测头用合成形状上的伪标签做分类训练[3];D2-Net 干脆不做检测头,把描述子范数当检测分数,再用「延迟检测」在测试时取极大值[4];R2D2 显式预测可重复性和可靠性两张图,用可重复性作为检测器的监督信号[5];LF-Net 也做端到端训练,但检测的离散选择破坏了可导性,论文把它归为「break differentiability」的一类[6]。这些方法的共同点是:优化目标与最终要的东西隔了一层。分类损失、peakiness 损失、可重复性热图都是「关键点质量」的代理,代理好不一定等于下游匹配多;而匹配本身又依赖检测结果,误差会叠加。
最接近 DISK 的是 Reinforced Feature Points(RFP)[7]:它把 RANSAC 放进训练回路,用最终位姿的奖励直接做策略梯度。但整条检测 + 匹配链只有一个标量奖励,训练信号太弱,RFP 只能微调预训练的 SuperPoint,没法从零训练。DISK 的做法是把奖励从「位姿」降到「匹配」:不要求一次梯度更新就改好位姿,只要求选出的点更容易产生正确匹配。这个代理目标足够密,才能从随机初始化开始学。
论文的贡献可以概括成四条:
- 把特征提取和匹配都写成概率分布:检测是「单元内 proposal + Bernoulli 接受」,匹配是「行/列 softmax + 双向一致性」。
- 匹配分布让期望奖励可以闭式求和,于是策略梯度估计只有特征采样的方差,没有匹配采样的方差——这是它能稳定从零训练的关键。
- 奖励用深度重投影误差(没有深度时退化为对极距离),不需要关键点标注,也不需要可微的检测算子。
- 在 IMC 2020、HPatches、ETH-COLMAP 上拿到当时最好的一档结果,同时保持 1024×1024 约 7 fps 的推理速度。
二、核心方法
2.1 概率检测:每个单元掷两次硬币
网络是一个简化版 U-Net[8]:4 个下采样块和 4 个上采样块,每个块只有一层 5×5 卷积(标准 U-Net 是两层),用 instance normalization 和 PReLU,输出 129 个通道——128 维描述子 加 1 张检测热图 。整个模型 1.1M 参数,理论感受野 219×219 像素。
检测被限制在 的网格里,每个单元 最多出一个点。对单元内的热图 (64 个像素),先做一次 proposal:
这回答的是「单元内哪个像素相对更值得选」。选出像素 之后,再做一次 Bernoulli 接受:
这回答的是「这个像素的绝对质量够不够」。两者相乘就是实际采样到 的概率:
被接受的像素取出该位置的 128 维描述子并做 l2 归一化,得到特征集合 。点的数量不是固定的 k:每个单元独立掷一次「选哪个像素」和一次「接不接受」,一张图可能出 3 个点,也可能出 8 个点;网络通过热图的整体高低来控制密度。这一点和「全局采样 k 个点」的常见描述不同,也是 DISK 与 SuperPoint 的另一处差别:SuperPoint 把「无特征」当成同一个 softmax 里的一个 bin,DISK 则保留了单元内的空间结构,把相对偏好(softmax)和绝对质量(sigmoid)分开建模。
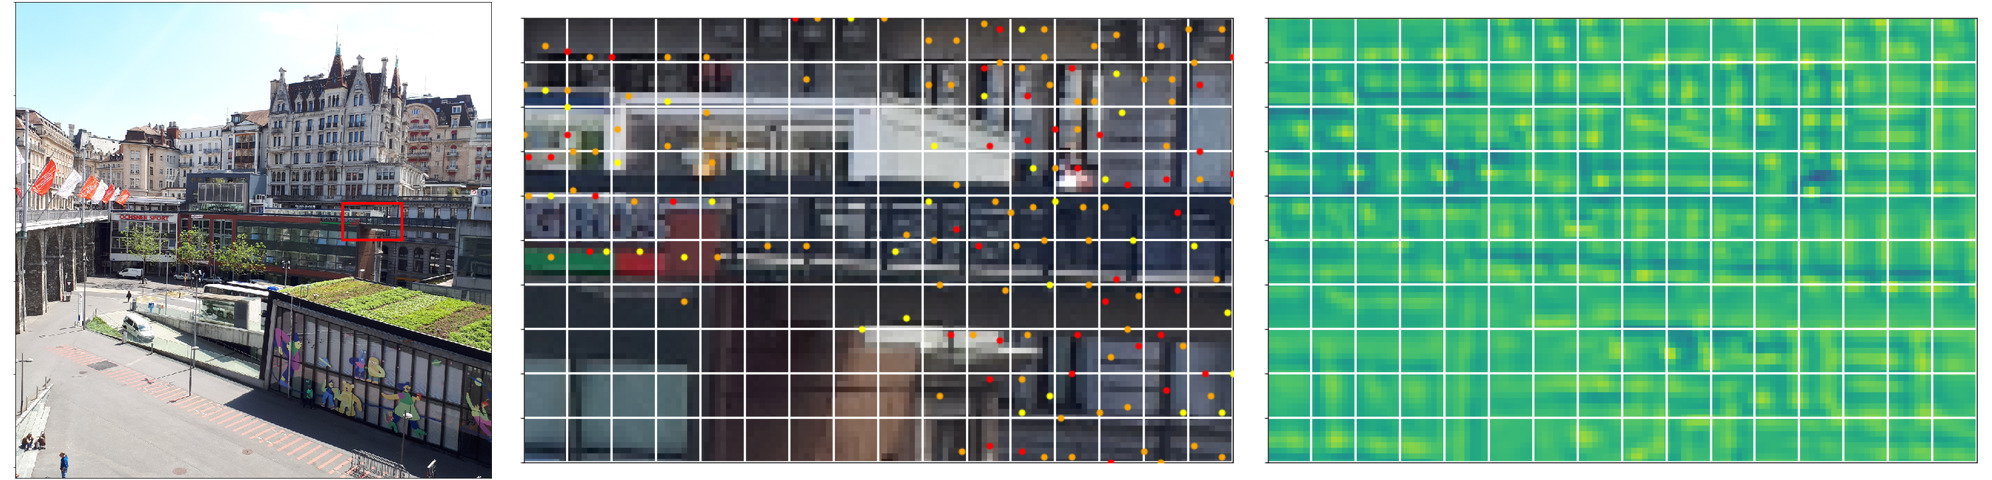
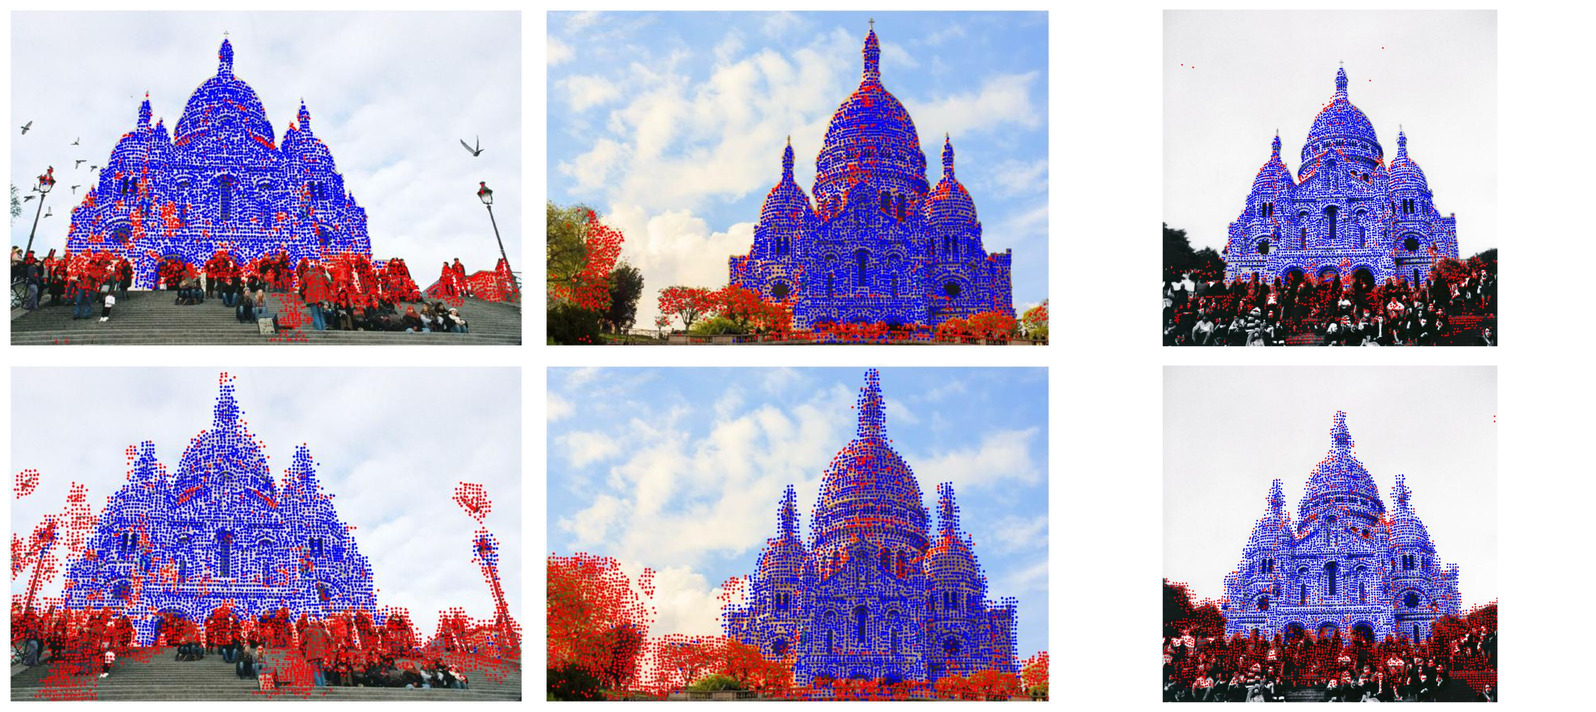
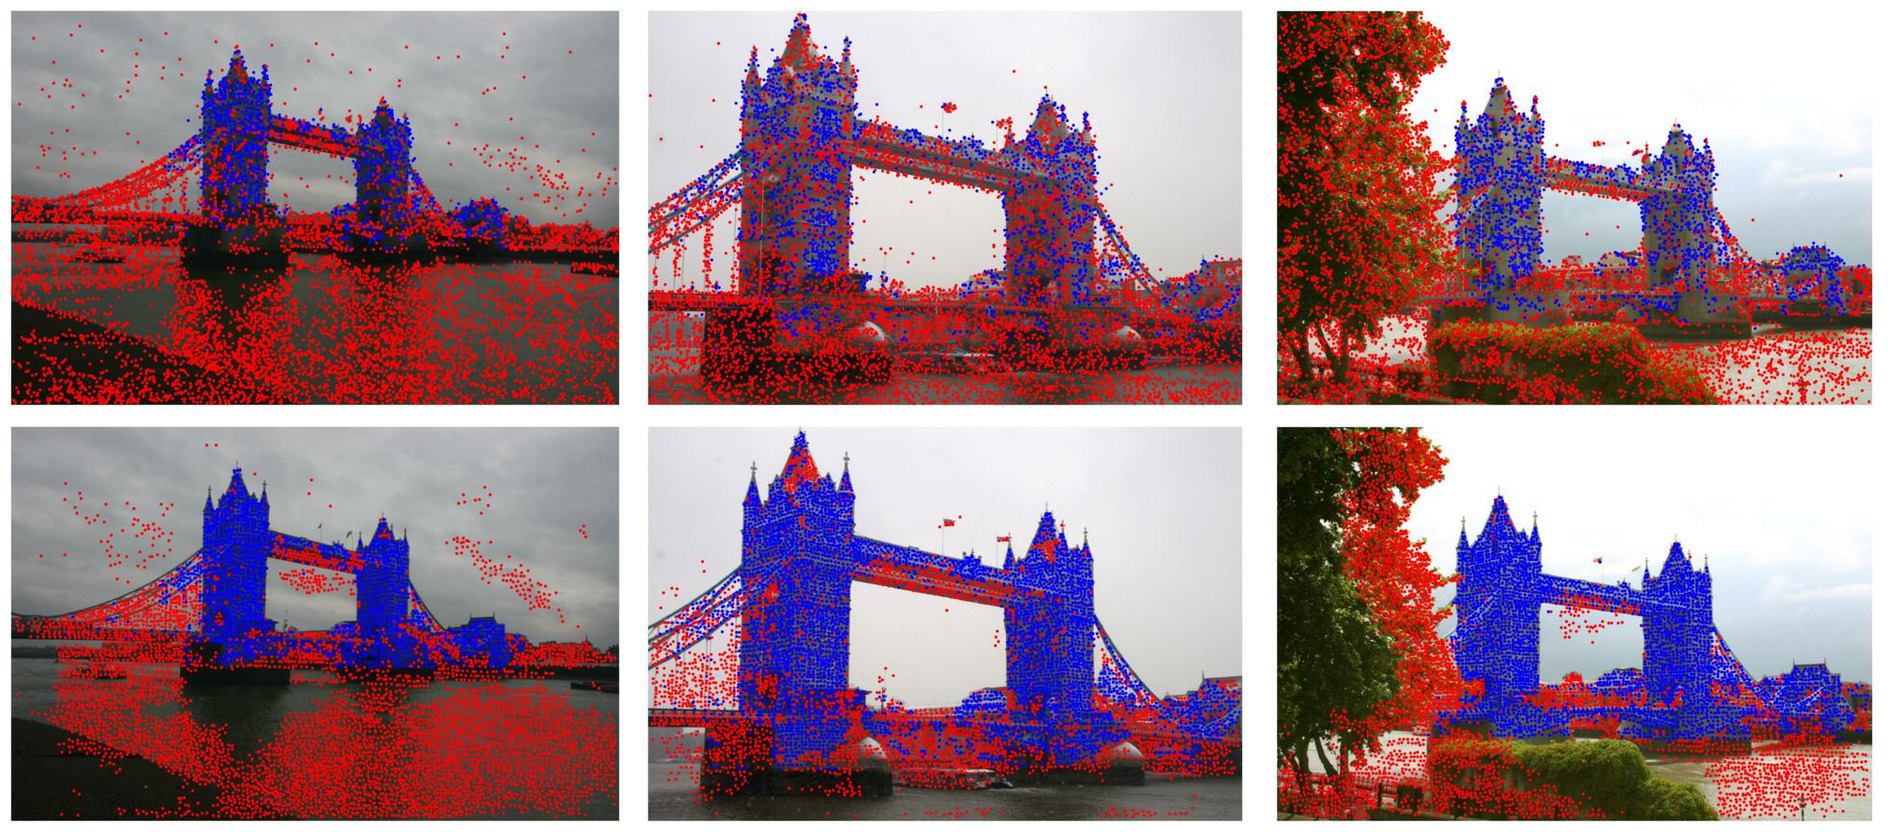
推理时如果把 softmax 换成 argmax、把 sigmoid 换成符号函数,得到的是「每个单元最多一个点」的确定性版本;官方代码则更进一步,直接在整张热图上做 NMS,再按热图值排序取前 个。为什么不继续用训练时的网格采样?图 2 给了直观理由:网格会切断跨越单元边界的极大值,一个单元里最多一个点,而 NMS 在整张热图上找局部极大,能保留更显著的点。代价是训练/推理不一致,论文在消融里专门量了这一点(见 3.4)。
代码:proposal + Bernoulli 接受与 log-prob(官方 disk/model/detector.py,原文照录)
@dimchecked
def point_distribution(
    logits: [..., 'T']
) -> ([...], [...], [...]):
    '''
    Implements the categorical proposal -> Bernoulli acceptance sampling
    scheme. Given a tensor of logits, performs samples on the last dimension,
    returning
        a) the proposals
        b) a binary mask indicating which ones were accepted
        c) the logp-probability of (proposal and acceptance decision)
    '''

    proposal_dist = Categorical(logits=logits)
    proposals     = proposal_dist.sample()
    proposal_logp = proposal_dist.log_prob(proposals)

    accept_logits = select_on_last(logits, proposals).squeeze(-1)

    accept_dist    = Bernoulli(logits=accept_logits)
    accept_samples = accept_dist.sample()
    accept_logp    = accept_dist.log_prob(accept_samples)
    accept_mask    = accept_samples == 1.

    logp = proposal_logp + accept_logp

    return proposals, accept_mask, logp
下面的部件把这段采样放大成一个 6×6 单元的玩具热图。拖动 改变 proposal softmax 的尖锐程度(),拖动 给整张热图加一个偏置(只影响接受率;DISK 本身没有这个旋钮,点的多少完全由 决定,这里加 只是为了让接受率可调)。绿点是这一次实际采到的点,右侧是 2000 次采样的点数分布。默认 、 时期望约 5.5 个点,标准差约 1.5——同一个网络、同一张图,每次前向采到的点数都不一样,这正是策略梯度要面对的随机性。
2.2 匹配分布:把最近邻松弛成概率
有了两边的特征集合 ,先算 l2 距离矩阵 。标准做法是互最近邻 + ratio test:只保留互为最近邻、且最近距离与次近距离之比小于阈值的匹配。这套规则在推理时很有效,但不可导,没法进训练回路。DISK 把它松弛成两个 categorical 分布:从 A 的每个点出发,在 B 的所有点里按距离采样一个;反过来从 B 出发再采一次;两次采样互相指向对方,才算一对匹配。
前向分布是距离矩阵每一行的 softmax,后向是每一列的 softmax:
其中 是匹配的逆温度(代码里叫 inverse_T)。一对匹配的概率就是两个方向的乘积:
这个式子等于「前向采样选中 、后向采样选中 」同时发生的概率,也就是松弛后的循环一致性。 越大,softmax 越尖,匹配越接近硬最近邻;越小,分布越平,训练信号越软。
为什么这个松弛是全文的关键。假设奖励可以按匹配对分解,,那么给定 时,期望奖励
可以对所有 个对精确求和,不需要采样匹配。于是策略梯度里匹配这一步不贡献方差;论文明确说,这是它相比 RFP 能稳定从零训练的主要原因。剩下的随机性只有两个:特征集合 的采样,以及 mini-batch。论文没有用 baseline,也不需要——奖励的期望是闭式的,减 baseline 只会引入额外的估计量。
推理时这套分布被整个丢掉,换回标准的循环一致匹配加 ratio test(IMC 上用 0.95)。也就是说,训练用一个可求期望的软匹配,推理用一个更准的硬匹配;两者共享同一套描述子。
代码:匹配分布与精确的 P(i↔j)(官方 disk/model/consistent_matcher.py,原文节选)
class ConsistentMatchDistribution(MatchDistribution):
    def __init__(
        self,
        features_1: Features,
        features_2: Features,
        inverse_T: float,
    ):
        self._features_1 = features_1
        self._features_2 = features_2
        self.inverse_T = inverse_T

        distances = distance_matrix(
            self.features_1().desc,
            self.features_2().desc,
        )
        affinity = -inverse_T * distances

        self._cat_I = Categorical(logits=affinity)
        self._cat_T = Categorical(logits=affinity.T)

        self._dense_logp = None
        self._dense_p    = None

    @dimchecked
    def dense_p(self) -> ['N', 'M']:
        if self._dense_p is None:
            self._dense_p = self._cat_I.probs * self._cat_T.probs.T

        return self._dense_p

    @dimchecked
    def dense_logp(self) -> ['N', 'M']:
        if self._dense_logp is None:
            self._dense_logp = self._cat_I.logits + self._cat_T.logits.T

        return self._dense_logp
下面的部件用一个 8 对正确匹配 + 1 个干扰点的玩具例子,把「精确期望」和「采样匹配」放在一起。左图是 矩阵,绿框是正确匹配,虚线列是干扰点;右图是 2000 次采样匹配得到的奖励分布。默认 时,精确期望 ,但单次采样匹配的奖励标准差约 1.5。训练时 DISK 直接用左边的精确期望,所以这部分波动不会进入梯度;如果像普通 REINFORCE 那样采样匹配,梯度里就会多出这一层方差。
2.3 奖励:有深度用重投影,没深度用对极
匹配分布只给了「怎么把概率挪到正确对上」,还需要一个奖励告诉它哪些对是正确的。DISK 用几何真值把每一对 分成三类:
- 正确:两个位置都有深度,把 的点反投影到 3D、再投影到 ,与 的点的像素距离小于 ;反向同理。奖励 。
- 可疑:至少一边没有深度,但两个点满足对极约束(对极距离小于 )。奖励 0,不奖不罚。
- 错误:其余情况。奖励 。
代码里把「错误」具体落成「对极距离超阈值」:good_pairs = close1 & close2,epi_bad = ~epipolar.classify(...),返回 λ_tp * good_pairs + λ_fp * epi_bad。所以一个深度可用、重投影不接近、但对极约束仍然满足的对子会落在 0,而不是 -0.25——实现比论文正文的「其余都算错」更保守一些。这个细节不影响主旨,但读代码时值得知道。
奖励是离散的、不可导的,训练时只作为 REINFORCE 的权重,不参与求导。另有每点一个小惩罚 ,防止网络在云、天空这类无纹理区域撒太多永远匹配不上的点。 和 在前 5 个 epoch 从 0 线性升到目标值:随机初始化的网络一开始匹配质量很差,如果立刻罚假匹配,网络会迅速收敛到「一个点都不选」的局部最优(奖励 0,反而比负奖励好)。
顺带澄清一个常见混淆:DISK 的奖励不是 NRE(neural reprojection error)[9]。NRE 是 Germain 等人在 2021 年提出的、把重投影误差做成的可微损失,用来端到端训练位姿估计;DISK 这里是用深度/对极几何判定的离散匹配奖励,训练时只当权重。两者都利用几何监督,但作用点不同:NRE 要可微,DISK 恰恰不需要奖励可微。
没有深度时,可以把整个奖励换成纯对极版本:满足对极约束 ,否则 ,没有「可疑」这一档。表 3 的结果是:对极监督在 multiview 上略好,在 stereo 上略差,但整体很接近,说明 DISK 不依赖高质量的稠密深度也能学。
代码:深度重投影奖励(官方 disk/loss/rewards.py,原文照录)
    @dimchecked
    def __call__(
        self,
        kps1: ['N', 2],
        kps2: ['M', 2],
        img1: Image,
        img2: Image
    ) -> ['N', 'M']:
        '''
        classifies all (kp1, kp2) pairs as either
        * correct  : within dist_α in reprojection
        * incorrect: above dist_α away in epipolar constraints
        * unknown  : no depth is available and is not incorrect

        and assigns them rewards according to DepthReward parameters
        '''

        # reproject to the other image.
        kps1_r = img2.project(img1.unproject(kps1.T)) # [2, N]
        kps2_r = img1.project(img2.unproject(kps2.T)) # [2, M]

        # compute pixel-space differences between (kp1, repr(kp2))
        # and (repr(kp1), kp2)
        diff1 = kps2_r[:, None, :] - kps1.T[:, :, None] # [2, N, M]
        diff2 = kps1_r[:, :, None] - kps2.T[:, None, :] # [2, N, M]

        # NaNs indicate we had no depth available at this location
        has_depth = (torch.isfinite(diff1) & torch.isfinite(diff2)).all(dim=0)

        # threshold the distances
        close1    = torch.norm(diff1, p=2, dim=0) < self.th
        close2    = torch.norm(diff2, p=2, dim=0) < self.th

        epi_bad    = ~self._epipolar.classify(kps1, kps2, img1, img2)
        good_pairs = close1 & close2

        return self.lm_tp * good_pairs + self.lm_fp * epi_bad
2.4 策略梯度:对匹配求和,而不是对匹配采样
把 2.1 的采样和 2.2 的匹配分布接起来,整个系统的参数是 , 是 U-Net 的权重。REINFORCE 的标准做法是采样一条轨迹、用奖励乘 log-prob 的梯度;DISK 的特殊之处在于匹配轨迹不用采:给定 ,所有 都能算出来,奖励又是按对求和的,于是
其中
第一项让描述子朝着「正确对更容易被匹配、错误对更难被匹配」的方向走;后两项让热图朝着「产生好匹配的位置更容易被采样」的方向走。奖励 是分段常数,梯度为 0,所以它只作为权重出现。没有被匹配上的点奖励为 0,可以从求和里省略;这也意味着一个从未被匹配的点不会被惩罚——它可能只是不共视,不该因此被否定。
代码里的损失就是负的估计量再加关键点惩罚:
实现上还有两个工程细节。第一,sample_p 在 torch.no_grad() 里算,只当前向权重;dense_logp 返回的是两个 Categorical 的 logits 之和(dense_p 才给出精确概率),代码注释明确说「不想对概率反传」。第二,距离矩阵是 的稠密矩阵,显存吃不消,所以 accumulate_grad 先把特征 detach、逐对反传、把梯度累积在特征上,最后再用 torch.autograd.backward(leaves, grads) 一次性反传到 U-Net——这样任意时刻只需要存一对的匹配矩阵。
虽然是匹配分布里唯一的参数,论文并没有让它跟着梯度学,而是用固定日程退火:论文正文说从 15 升到 25、训 10 个 epoch 后再 fine-tune;官方代码默认从 15 升到 50、覆盖前 20 个 epoch。README 也交代了论文结果来自一个更绕的 ad-hoc 日程(15→25 训 10 轮,再训 40 轮,取第 39 个 checkpoint,再用 fine-tune 50 轮,最好的在第 20 轮,)。这类日程说明匹配温度对训练稳定性很敏感,不是一个可以随便拍的超参。
代码:REINFORCE 损失(官方 disk/loss/reinforce.py,原文照录)
    def _loss_for_pair(self, match_dist: MatchDistribution, img1: Image, img2: Image):
        elementwise_rewards = self.reward(
            match_dist.features_1().kp,
            match_dist.features_2().kp,
            img1,
            img2,
        )

        with torch.no_grad():
            # we don't want to backpropagate through this
            sample_p = match_dist.dense_p() # [N, M]

        sample_logp = match_dist.dense_logp() # [N, M]

        # [N, M]
        kps_logp    = match_dist.features_1().kp_logp.reshape(-1, 1) \
                    + match_dist.features_2().kp_logp.reshape(1, -1)

        # scalar, used for introducing the lm_kp penalty
        sample_lp_flat = match_dist.features_1().kp_logp.sum() \
                       + match_dist.features_2().kp_logp.sum()

        # [N, M], p * logp of sampling a pair
        sample_plogp = sample_p * (sample_logp + kps_logp)

        reinforce  = (elementwise_rewards * sample_plogp).sum()
        kp_penalty = self.lm_kp * sample_lp_flat
        #loss = -((elementwise_rewards * sample_plogp).sum() \
        #         + self.lm_kp * sample_lp_flat.sum())

        loss = -reinforce - kp_penalty

        n_keypoints = match_dist.shape[0] + match_dist.shape[1]
        exp_n_pairs = sample_p.sum().item()
        exp_reward  = (sample_p * elementwise_rewards).sum().item() \
                    + self.lm_kp * n_keypoints

        stats = {
            'reward'     : exp_reward,
            'n_keypoints': n_keypoints,
            'n_pairs'    : exp_n_pairs,
        }

        return loss, stats
2.5 网络与训练设置
特征提取网络在官方代码里是一行配置就能看清的:
代码:U-Net 通道配置(官方 disk/model/disk.py,原文节选)
        self.unet = Unet(
            in_features=3, size=kernel_size,
            down=[16, 32, 64, 64, 64],
            up=[64, 64, 64, desc_dim+1],
            setup=setup,
        )
训练数据是 MegaDepth 的一个子集[10]:135 个场景、约 6.3 万张图。用 COLMAP 的 3D 点共视比例 筛图像对,只保留 的,再以每场景约 1 万个三元组采样,总共约 13.3 万个共视三元组。和 IMC 测试集重叠的场景被手工拉黑,验证集用 Sacre Coeur 和 St. Peter’s Square。
每个 batch 是 2 个场景 × 3 张共视图片。三张图能组成 3 个图像对(AB、AC、BC),而两个不相关的图像对要 4 张图才凑出 2 个对——三图一组既多了匹配,又省了特征提取的显存。图像缩放到长边 768、短边零填充成正方形,不做任何数据增强。Adam,学习率 ,训练 30 万步;V100 32GB 上 768×768 输入约 1.2 秒 / 两个三元组,1024×1024 推理约 7 fps。显存不够时可以用 --substep 累积梯度,README 说 11/12GB 的卡也能跑,代价是大约两周。
三、实验结果
3.1 IMC 2020:下游位姿才是硬指标
Image Matching Challenge 2020 用两个任务评局部特征[11]:stereo 任务把每对图的匹配交给 DEGENSAC[12] 估计相对位姿,multiview 任务把 5/10/25 张图的匹配交给 COLMAP 做 SfM;指标是位姿误差 10° 以内的 mean Average Accuracy(mAA)。它不看你中间的可重复性、匹配数,只看最后位姿对不对,这正是 DISK 想优化的东西。论文在 2k 和 8k 两个特征预算下都参赛,匹配用循环一致 + 0.95 的 ratio test,stereo 的 DEGENSAC 内点阈值 0.75 px。
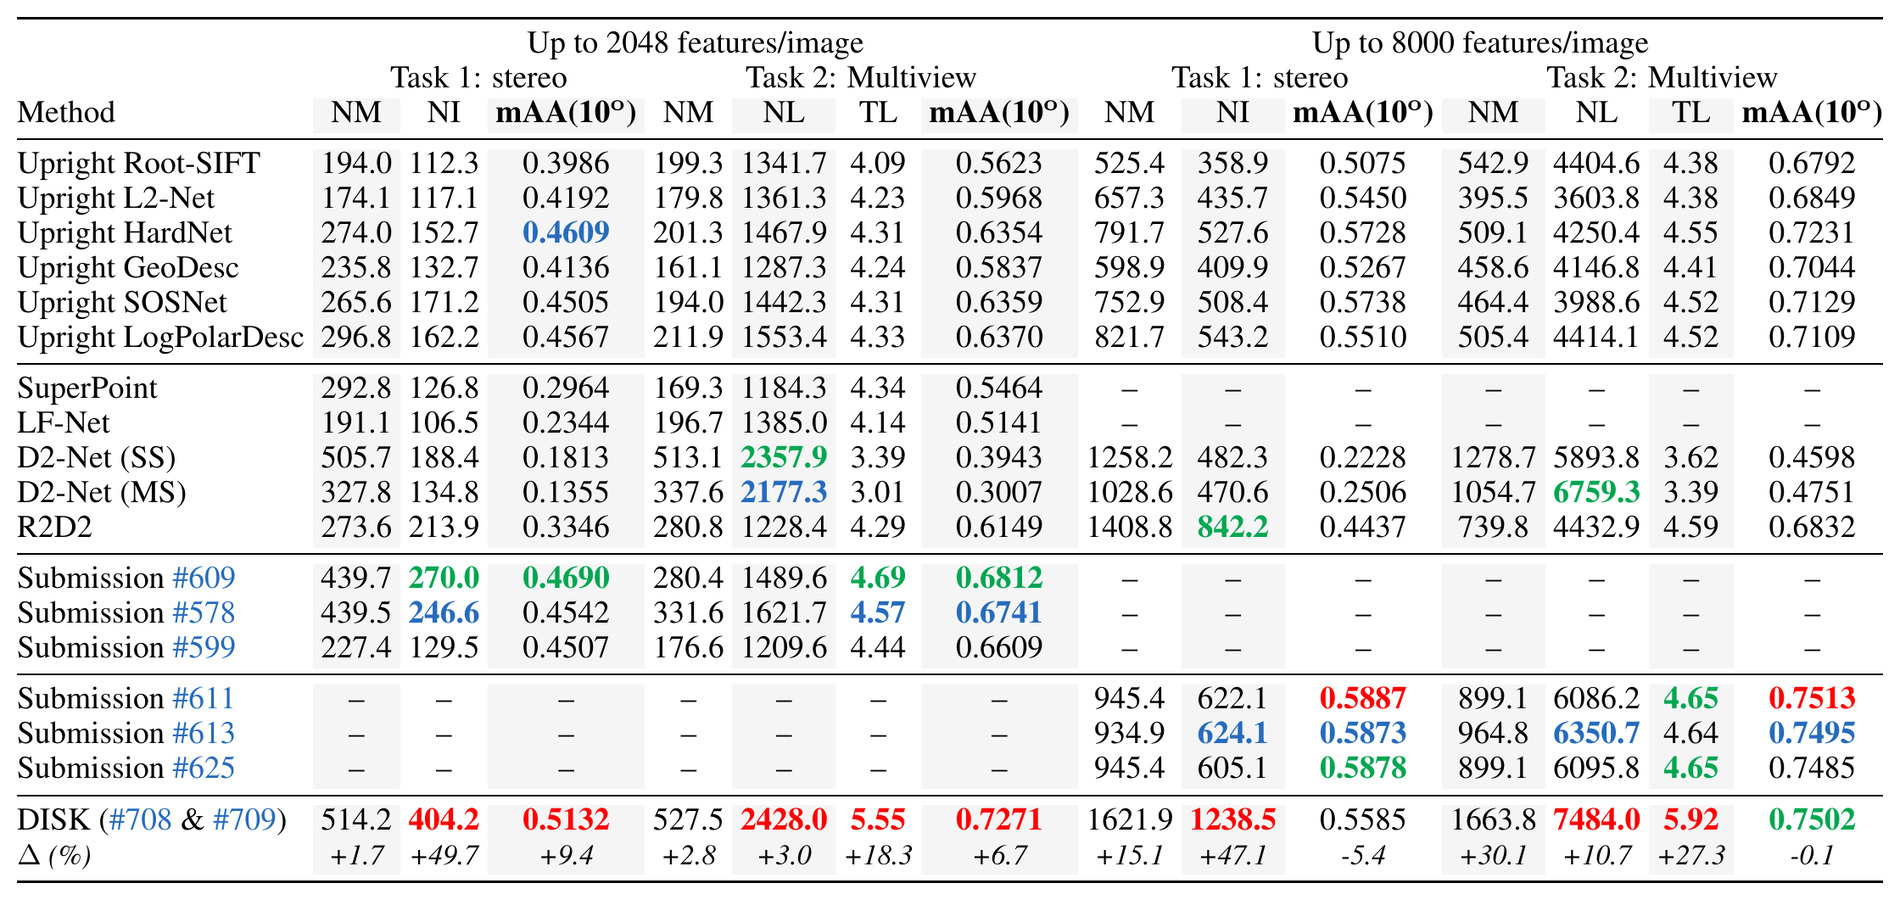 表 1:IMC 2020 结果。上半部分是 2k 特征/图,下半部分是 8k。NM 是匹配数,NI 是 RANSAC 内点数,NL 是地标数,TL 是每个地标的平均观测数;粗体/颜色标出前三名。DISK 在 2k 的 stereo 和 multiview 都是第一,8k 略低于三份用户提交,但高于所有基线方法。
2k 预算下,DISK 的 stereo mAA 是 0.5132,multiview 是 0.7271,相对所有对比方法分别高 9.4% 和 6.7%。它产生的匹配也多得夸张:stereo 平均 514.2 对匹配、404.2 个内点,而 R2D2 是 273.6/213.9,DoG + Upright HardNet 是 274.0/152.7;multiview 的 3D 地标数是 2428.0,R2D2 是 1228.4。8k 预算下是 0.5585/0.7502,multiview 与榜首的 Submission #611(0.7513)几乎打平,stereo 低于它(0.5887),但所有基线方法都被压在下面。论文特别说明:2k 的特征是 8k 的子集,说明 8k 的预算没有被充分利用——更大的训练分辨率或更小的网格可能有帮助。
在「只用现成的 l2 匹配器」这个组里,DISK 是 2k category 的第一;总榜第二,仅次于用了 SuperGlue 的提交。这个区分很重要:DISK 的强项是特征本身,不是匹配器。
3.2 HPatches:视角场景第一,光照场景第二
HPatches 有 116 个场景、每个 6 张图,场景是平面的,只有视角或光照变化(不同时出现),真值是单应[13]。评测把第一张图与其余五张匹配,去掉 8 个高分辨率场景,算 1–10 px 阈值下的 Mean Matching Accuracy(MMA),再用 5 px 以内的 AUC 汇总。
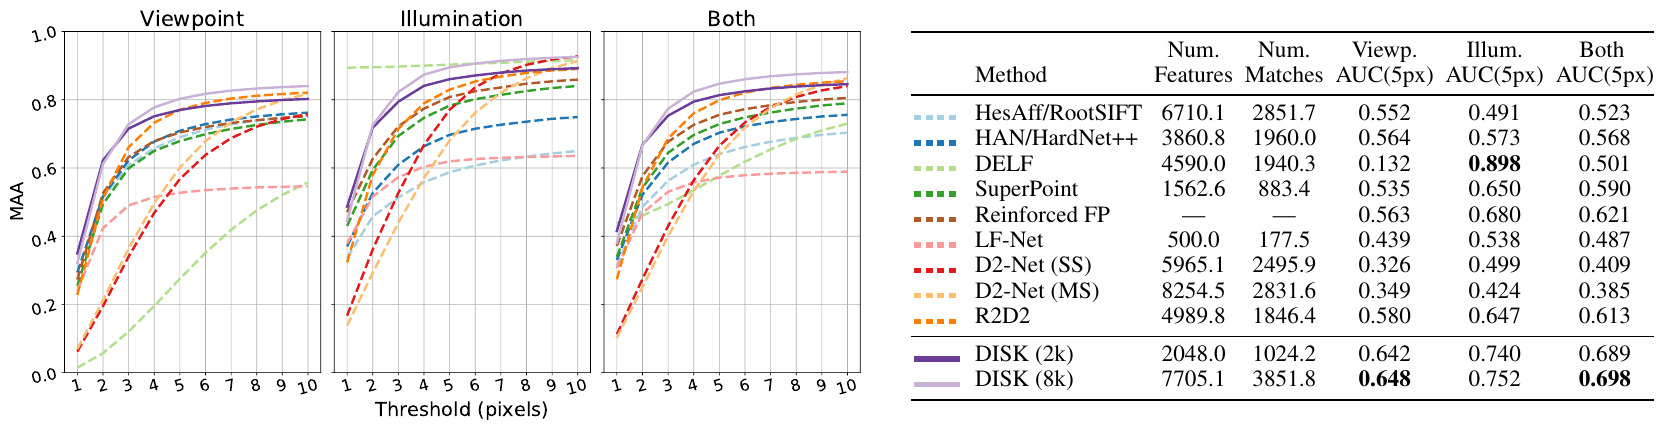
具体数字:视角场景 AUC 0.642(2k)/0.648(8k),R2D2 0.580,RFP 0.563,SuperPoint 0.535;光照场景 0.740/0.752,DELF 0.898,RFP 0.680;两者都有 0.689/0.698,RFP 0.621,R2D2 0.613。论文的说法是「视角第一、光照第二,综合比最接近的 RFP 相对高 12%」。注意 DISK 是在非平面数据上训练的,也没做仿射增强,HPatches 的平面单应对它其实不算「主场」;光照场景落后 DELF 较多,说明它没有专门优化光度不变性。
3.3 ETH-COLMAP:更多、更长的轨迹
ETH-COLMAP benchmark 统计大规模 SfM 的重建质量[14]:地标数 NL、每个地标的平均观测数 TL、重投影误差 。这个基准不统一特征数,所以论文在全分辨率上取约 12k 个 DISK 特征,和 SIFT 的量级对齐。
| 场景 | 方法 | NL | TL | |
|---|---|---|---|---|
| Fountain | Root-SIFT | 15k | 4.70 | 0.41 |
| Fountain | SuperPoint | 31k | 4.75 | 0.97 |
| Fountain | RFP | 9k | 4.86 | 0.87 |
| Fountain | DISK | 18k | 5.52 | 0.50 |
| Herzjesu | Root-SIFT | 8k | 4.22 | 0.46 |
| Herzjesu | DISK | 11k | 4.71 | 0.48 |
| South Building | Root-SIFT | 113k | 5.92 | 0.58 |
| South Building | SuperPoint | 160k | 7.83 | 0.92 |
| South Building | RFP | 102k | 7.86 | 0.88 |
| South Building | DISK | 115k | 9.91 | 0.59 |
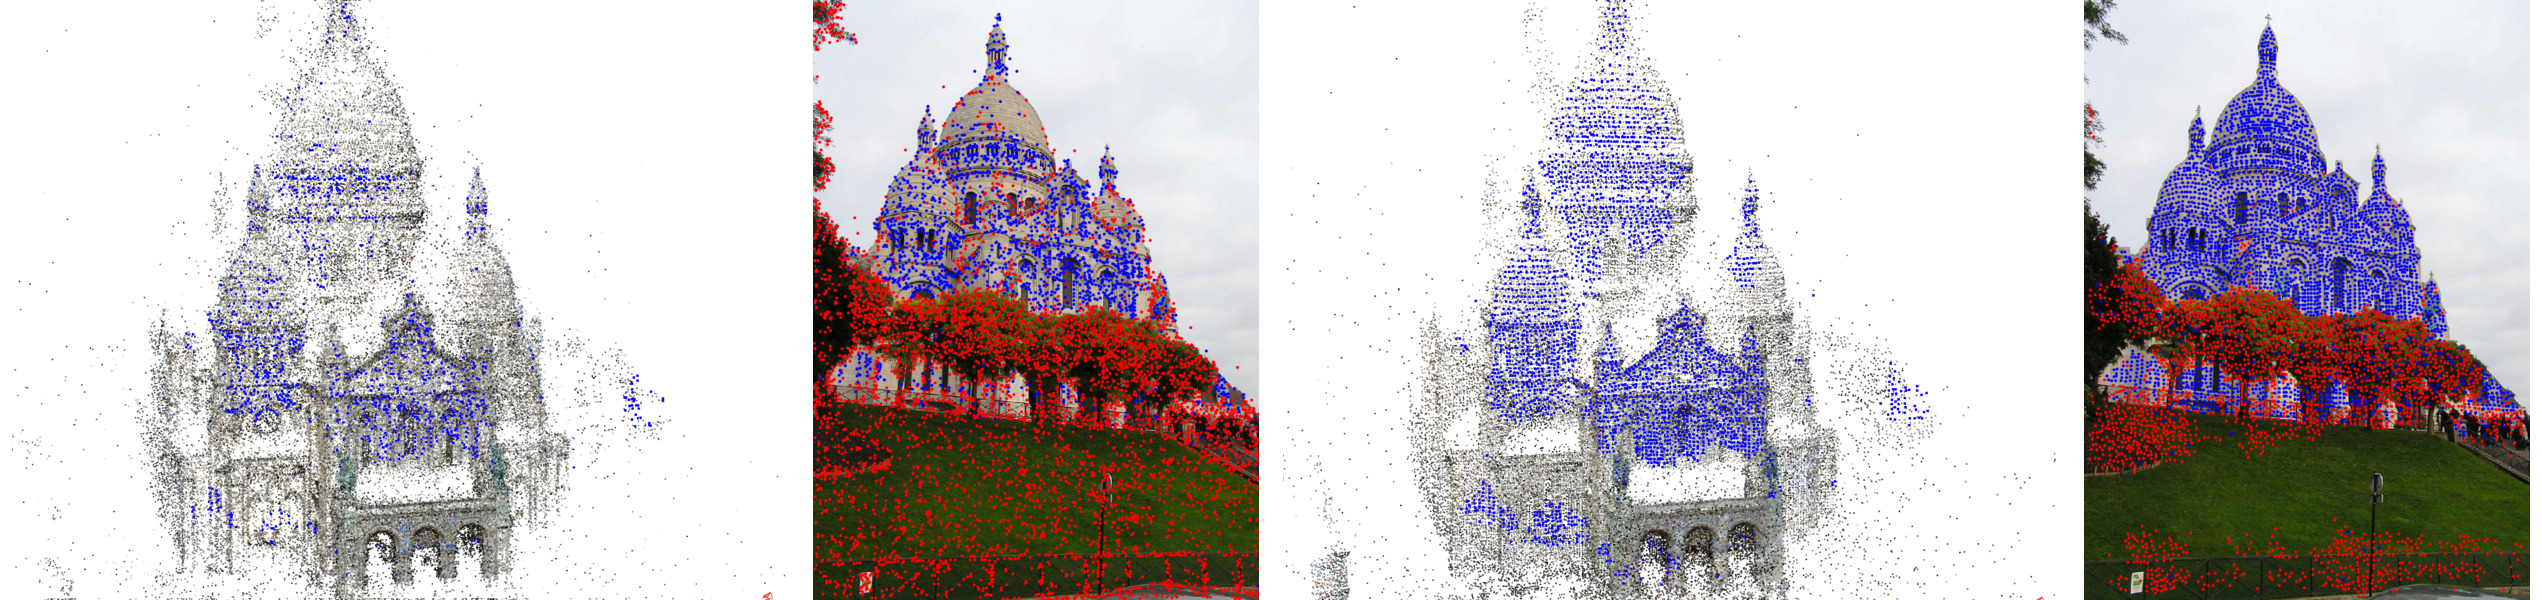
DISK 的地标数和轨迹长度普遍高于 SIFT、SuperPoint 和 RFP,重投影误差和 SIFT 接近、明显低于 SuperPoint/RFP。Fountain 上不设上限能出 6.7 万个地标,说明 12k 的帽子压掉了很多可用的点。需要说明的是,这个基准没有标准化输入特征数,跨方法比较时不能只看 NL。
3.4 消融:NMS、网格、监督信号
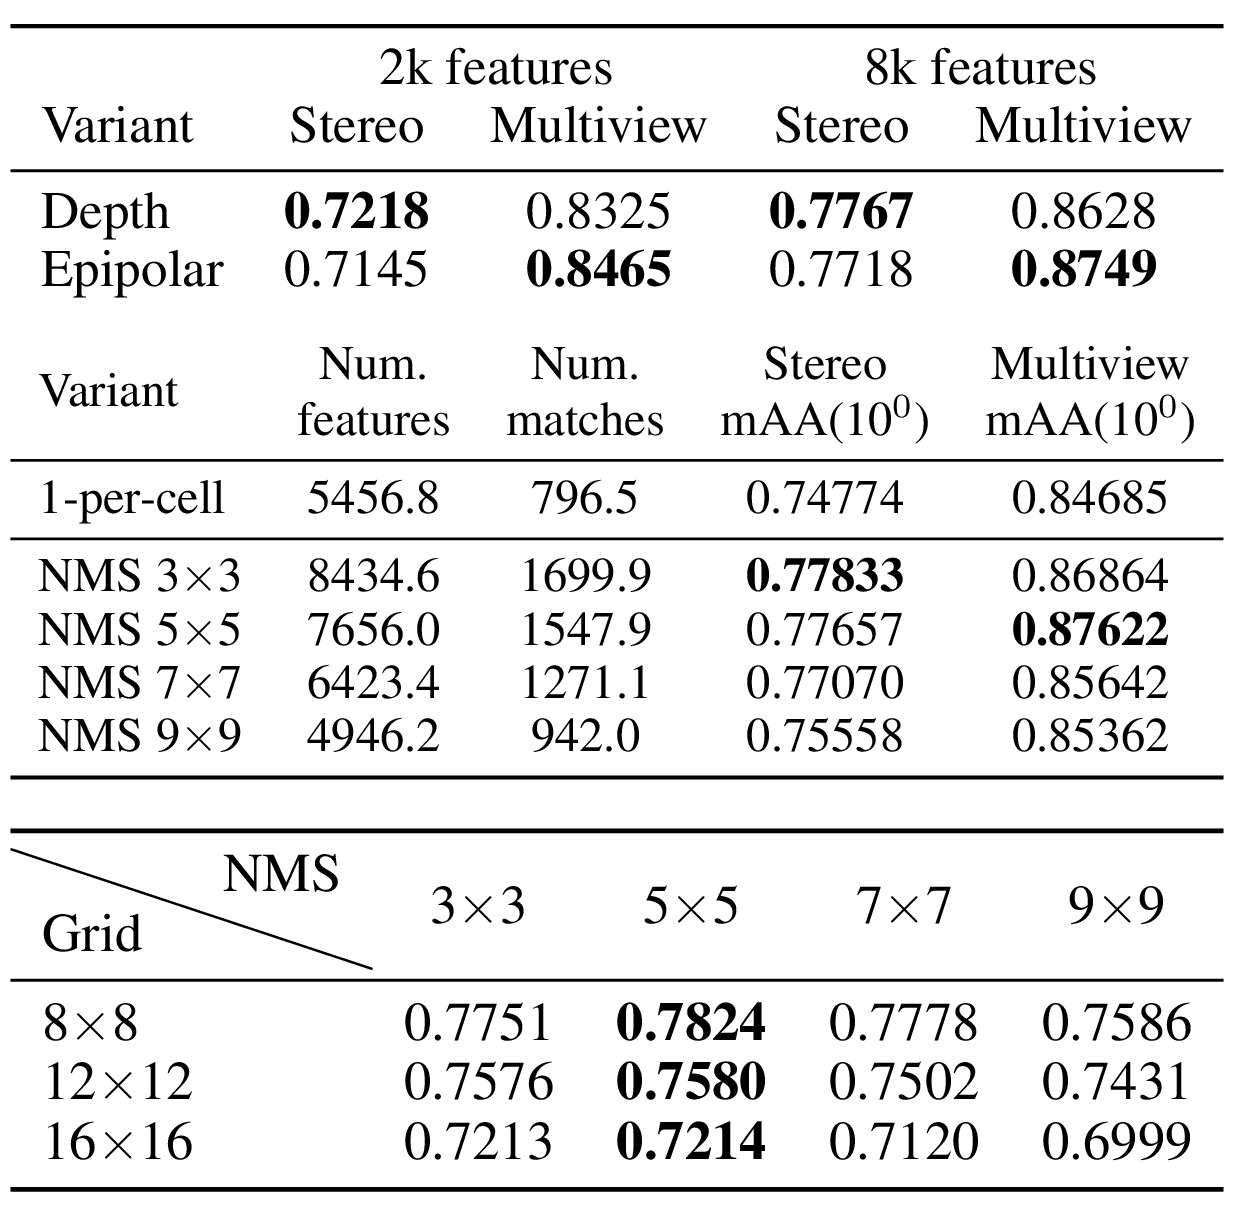 表 3–5 原图:从上到下依次是深度 vs 对极监督、1-per-cell vs NMS、以及网格大小 × NMS 的 mAA(2k 预算)。下面逐项拆开。
深度 vs 对极(表 3,IMC 验证集):
| 监督 | 2k stereo | 2k multiview | 8k stereo | 8k multiview |
|---|---|---|---|---|
| 深度重投影 | 0.7218 | 0.8325 | 0.7767 | 0.8628 |
| 对极约束 | 0.7145 | 0.8465 | 0.7718 | 0.8749 |
对极监督在 multiview 上高 1.2–1.4 个百分点,在 stereo 上低 0.5–0.7 个百分点。差距不大,但方向一致:深度奖励更准,对极奖励覆盖更广(不要求深度),点会跑到 3D 物体边界上(图 7)。这给没有深度数据的场景留了一条可用的退路。
NMS vs 网格(表 4,IMC 验证集,不做特征预算截断):
| 选择方式 | 特征数 | 匹配数 | stereo mAA | multiview mAA |
|---|---|---|---|---|
| 训练时 1-per-cell | 5456.8 | 796.5 | 0.74774 | 0.84685 |
| NMS 3×3 | 8434.6 | 1699.9 | 0.77833 | 0.86864 |
| NMS 5×5 | 7656.0 | 1547.9 | 0.77657 | 0.87622 |
| NMS 7×7 | 6423.4 | 1271.1 | 0.77070 | 0.85642 |
| NMS 9×9 | 4946.2 | 942.0 | 0.75558 | 0.85362 |
推理换 NMS 后 stereo 从 0.748 涨到 0.778、multiview 从 0.847 涨到 0.876,尽管这引入了训练/推理不一致。原因就是图 2 说的:网格会切断边界上的极大值,也会在一个单元里漏掉第二个显著点;NMS 在整张热图上找局部极大,特征数和匹配数都更多。3×3 的 stereo 最好,5×5 的 multiview 最好,官方 detect.py 默认 5×5。
网格大小(表 5,2k 预算):8×8 网格配 3×3 NMS 是 0.7751,配 5×5 是 0.7824(最好),配 7×7 是 0.7778,配 9×9 是 0.7586;网格放大到 12×12,同样的 3×3 NMS 降到 0.7576,16×16 降到 0.7213。小网格性能更好,但特征更多、距离矩阵更大、显存更贵,是一个明确的 trade-off。
特征重复:训练时 19.9% 的网格特征在 2 px 内还有另一个特征,基本是单元边界切出来的重复检测。论文讨论了三点影响:匹配矩阵变大、 的实际作用被放大、描述子被推得比需要的更 shift-invariant。但 HPatches 的 1 px 结果和 ETH-COLMAP 的低重投影误差说明这个问题没有伤到最终性能。
3.5 旋转鲁棒性与定性结果
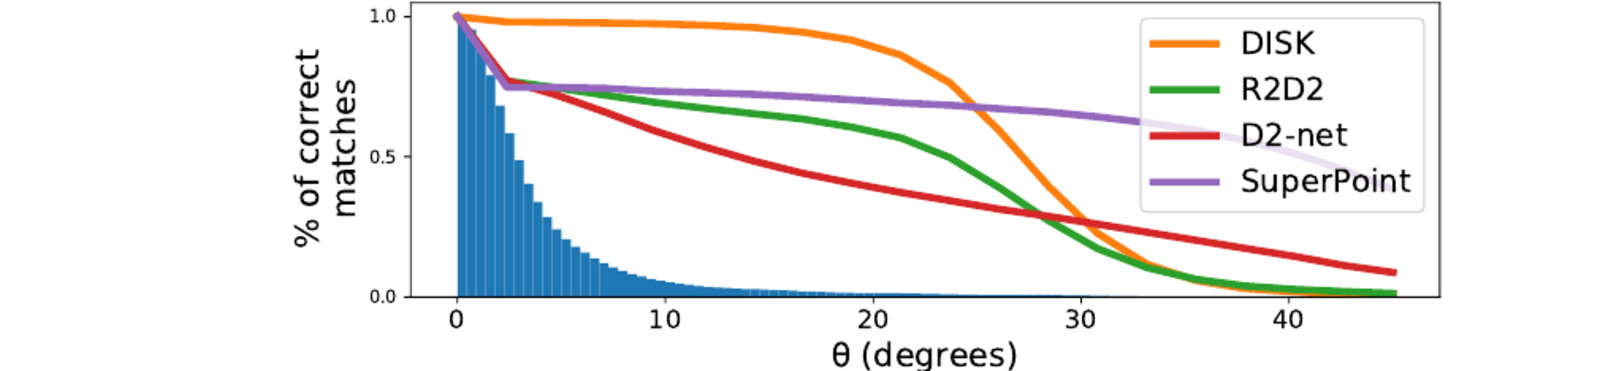
这是 DISK 最明确的短板,也是论文自己主动摆出来的:它在训练数据覆盖的旋转范围内非常稳,出了这个范围就崩。原因不神秘——训练不做旋转增强,U-Net 也不是旋转等变的。论文的建议是数据增强,而不是换网络结构;后来的 RaCo 正是沿着这条线,用全 360° 旋转增强把检测器的旋转鲁棒性拉了上去[15]。
四、局限性
论文承认的
- 大角度面内旋转会失效。训练分布外的旋转正确匹配率明显下降(图 6),论文归因于没有旋转增强,建议用数据增强解决。
- 训练/推理不一致。训练用网格采样(每单元最多一个点、单元间互不知情),推理用 NMS;网格会切断极大值,也会产生 2 px 内的重复检测(19.9%)。NMS 在消融里反而更好,但这是「歪打正着」,不是训练目标直接优化出来的。
- 深度监督有偏。只在深度可靠的区域给奖励,可能让点避开某些区域;对极监督覆盖更广但更弱,stereo 会掉一点。
- 特征预算利用不充分。2k 的特征是 8k 的子集,8k 没有发挥出全部潜力;论文猜测更大的训练图或更小的网格能改善。
- 无纹理区域仍会出点。没有被匹配的点奖励为 0,网络可能在一些永远匹配不上的结构(云、天空)上撒点,只用 的小惩罚压着。
- 匹配松弛仍是代理。训练用软匹配 + 期望奖励,推理用硬循环一致 + ratio test;论文在结论里明确说,未来想把匹配松弛换成 SuperGlue、LoFTR 这类学习型匹配器[16]。
我自己再补几条
- 训练成本不低。30 万步、768×768、V100 32GB 约 1.2 秒 / 两个三元组,加上 164GB 的数据集和稠密 距离矩阵,复现门槛远高于「1.1M 参数」给人的印象。README 的低显存配置(
--substep 2 --batch-size 1)虽然能在 11/12GB 上跑,但要大约两周。 - 采样方差只在检测端。论文把匹配端的方差消掉了,但特征采样仍是高方差来源;论文没有报告梯度方差或不同随机种子下的训练稳定性。、 的退火日程和 的日程都像是调出来的,换数据集可能要重调。
- 没有光照/旋转增强。HPatches 光照场景落后 DELF 较多(0.740 vs 0.898),旋转场景外推会崩,这两件事同源:训练分布太窄。对真实应用来说,「训练时见过什么」比「网络结构多巧」更能决定鲁棒性。
- 推理分数不跨图校准。按热图值取 top- 时,不同图像的热图尺度不一定可比;论文用验证集选阈值,实际部署到新场景时需要重新看分布。
- 评测范围。论文只在 IMC 2020、HPatches、ETH-COLMAP 上评,没有 Aachen 这类视觉定位,也没有和 SuperGlue/LoFTR 这类学习型匹配器组合后的端到端数字;它的比较对象是「现成的 l2 匹配器 + 各方法特征」,这个设定对 DISK 有利也有代表性,但不能直接外推到「特征 + 现代匹配器」的完整系统。
五、结论与展望
DISK 的故事线其实很短:检测器的 argmax 挡住了梯度,那就别做 argmax,改成采样;采样让目标变成期望奖励,而匹配分布又让这个期望可以闭式求和;于是整个系统可以用 REINFORCE 从零训练,不需要关键点标注,也不需要可微的检测算子。它把一个「结构上不可导」的问题转成了「统计上可估计」的问题,这是 2020 年前后局部特征领域最干净的一次建模之一。
给实践者的几条建议:
- 如果你的场景是宽基线、纹理丰富、旋转不大,DISK 仍是很强的选择:匹配多、位姿准、推理快。stereo 用 5×5 NMS + DEGENSAC,多视图用 COLMAP 的默认链路即可。
- 如果旋转是主要变量(无人机俯拍、手机随意拍),优先考虑做了全角度旋转增强的检测器(如 RaCo、ALIKED),或者自己给 DISK 加旋转增强重训;不要指望原版 DISK 外推。
- 如果没有深度真值,用 epipolar 奖励训练,multiview 甚至略好;但 stereo 会掉一点,且点会跑到物体边界上,下游三角化要留意。
- 如果显存/时间紧张,别从零复现训练;直接用官方
depth-save.pth推理,或者只在目标域上做轻量微调。
展望方面,论文自己指了两个方向:用学习型匹配器替换软匹配松弛,以及更大的训练图/更小的网格。前者在 LoFTR、LightGlue 之后已经成为主流,后者则被后来的工作反复验证——检测器的网格越细,能出的点越多,但匹配矩阵也越贵。DISK 没有解决旋转和光照,但它把「检测器应该为下游匹配负责」这件事说清楚了;后来的 RaCo 把策略梯度检测器单独拿出来、用合成单应做旋转增强,可以看作这条线的直接延续。
六、上手
官方仓库是 cvlab-epfl/disk,Apache 2.0,带 depth-save.pth 和 epipolar-save.pth 两个 checkpoint。安装需要递归 clone(disk 依赖 submodules/ 里的 torch-localize、torch-dimcheck、unets),然后 pip install --user -r requirements.txt。requirements.txt 没有锁版本,且同时列了 tensorboard 和 tensorflow;旧代码在新 PyTorch 上可能需要小修,这是这类 2020 年仓库的常态。
安装命令(递归 clone + requirements)
git clone --recursive https://github.com/cvlab-epfl/disk.git
cd disk
pip install --user -r requirements.txt推理分三步:detect.py 提特征(写 keypoints.h5 / descriptors.h5),match.py 做匹配(写 matches.h5),需要的话用 colmap/h5_to_db.py 转成 COLMAP 数据库。图像尺寸必须是 16 的倍数(4 层 U-Net 的下采样),所以通常显式给 --height 和 --width;脚本会保持长宽比、零填充,并把关键点坐标映射回原图。--n 控制最多取多少个点(按热图值排序),--window 是 NMS 窗口(默认 5),--mode rng 可以切回训练时的网格采样(主要用于调试)。
提特征、匹配与导出 COLMAP(README 的命令)
# 提特征:长边缩到 1024,最多 2048 个点
python detect.py --height 1024 --width 1024 --n 2048 scene/h5 scene/images

# 循环一致匹配 + ratio test 0.95
python match.py --rt 0.95 --save-threshold 100 scene/h5

# 转成 COLMAP 数据库(特征不带描述子,匹配已经由 match.py 做好)
python colmap/h5_to_db.py --database-path scene/database.db scene/h5 scene/images

# 剩下的交给 COLMAP:穷举匹配(只用 RANSAC,不需要 GPU)+ 建图
colmap exhaustive_matcher --database_path scene/database.db --SiftMatching.use_gpu 0
mkdir scene/sparse
colmap mapper --database_path scene/database.db --image_path scene/images --output_path scene/sparse
训练需要先下载约 164GB 的 MegaDepth 子集(download_dataset 脚本),然后:
训练命令(默认深度奖励;低显存配置)
# 默认:2 场景 × 3 图,768×768,θ_M 从 15 退火到 50(前 20 个 epoch)
python train.py DATASETS_LOCATION

# 低显存:功能等价,11/12GB 显存可跑,但大约要两周
python train.py --substep 2 --batch-size 1 --chunk-size 10000 --warmup 500几个参数和论文概念的对应:--reward depth|epipolar 对应 2.3 的两种奖励;--window 8 是训练网格(代码里 DISK(window=8)),推理时 detect.py --window 5 是 NMS 窗口,两者不是同一个东西;--desc-dim 128 必须和 checkpoint 一致;inverse_T 就是论文的 ,在 train.py 里按 epoch 退火,不是可学习参数。README 里写的 save-depth.pth 是笔误,仓库里的实际文件名是 depth-save.pth(epipolar-save.pth 同理),detect.py 的默认路径用的就是后者。
参考
- Tyszkiewicz, Fua, Trulls. DISK: Learning Local Features with Policy Gradient. NeurIPS 2020. arXiv · 代码
- Lowe. Distinctive Image Features from Scale-Invariant Keypoints. IJCV 2004. PDF
- DeTone, Malisiewicz, Rabinovich. SuperPoint: Self-Supervised Interest Point Detection and Description. CVPR Workshops 2018. arXiv · 代码
- Dusmanu, Rocco, Pajdla, Pollefeys, Sivic, Torii, Sattler. D2-Net: A Trainable CNN for Joint Description and Detection of Local Features. CVPR 2019. arXiv · 代码
- Revaud, Weinzaepfel, De Souza, Pion, Csurka, Cabon, Humenberger. R2D2: Repeatable and Reliable Detector and Descriptor. NeurIPS 2019. arXiv · 代码
- Ono, Trulls, Fua, Yi. LF-Net: Learning Local Features from Images. NeurIPS 2018. arXiv · 代码
- Bhowmik, Gumhold, Rother, Brachmann. Reinforced Feature Points: Optimizing Feature Detection and Description for a High-Level Task. CVPR 2020. arXiv
- Ronneberger, Fischer, Brox. U-Net: Convolutional Networks for Biomedical Image Segmentation. MICCAI 2015. arXiv
- Germain, Lepetit, Bourmaud. Neural Reprojection Error: Merging Feature Learning and Camera Pose Estimation. CVPR 2021. arXiv
- Li, Snavely. MegaDepth: Learning Single-View Depth Prediction from Internet Photos. CVPR 2018. arXiv · 代码
- Jin, Mishkin, Mishchuk, Matas, Fua, Yi, Trulls. Image Matching across Wide Baselines: From Paper to Practice. IJCV 2021. arXiv
- Chum, Werner, Matas. Two-View Geometry Estimation Unaffected by a Dominant Plane. CVPR 2005. PDF
- Balntas, Lenc, Vedaldi, Mikolajczyk. HPatches: A Benchmark and Evaluation of Handcrafted and Learned Local Descriptors. CVPR 2017. arXiv · 代码
- Schönberger, Hardmeier, Sattler, Pollefeys. Comparative Evaluation of Hand-Crafted and Learned Local Features. CVPR 2017. CVF
- Shenoi, Lindenberger, Sarlin, Pollefeys. RaCo: Ranking and Covariance for Practical Learned Keypoints. 3DV 2026. arXiv · 代码
- Sun, Shen, Wang, Bao, Zhou. LoFTR: Detector-Free Local Feature Matching with Transformers. CVPR 2021. arXiv · 代码