· 97 min read
论文解读:MINIMA,用数据引擎把 RGB 匹配数据扩成 480M 跨模态对
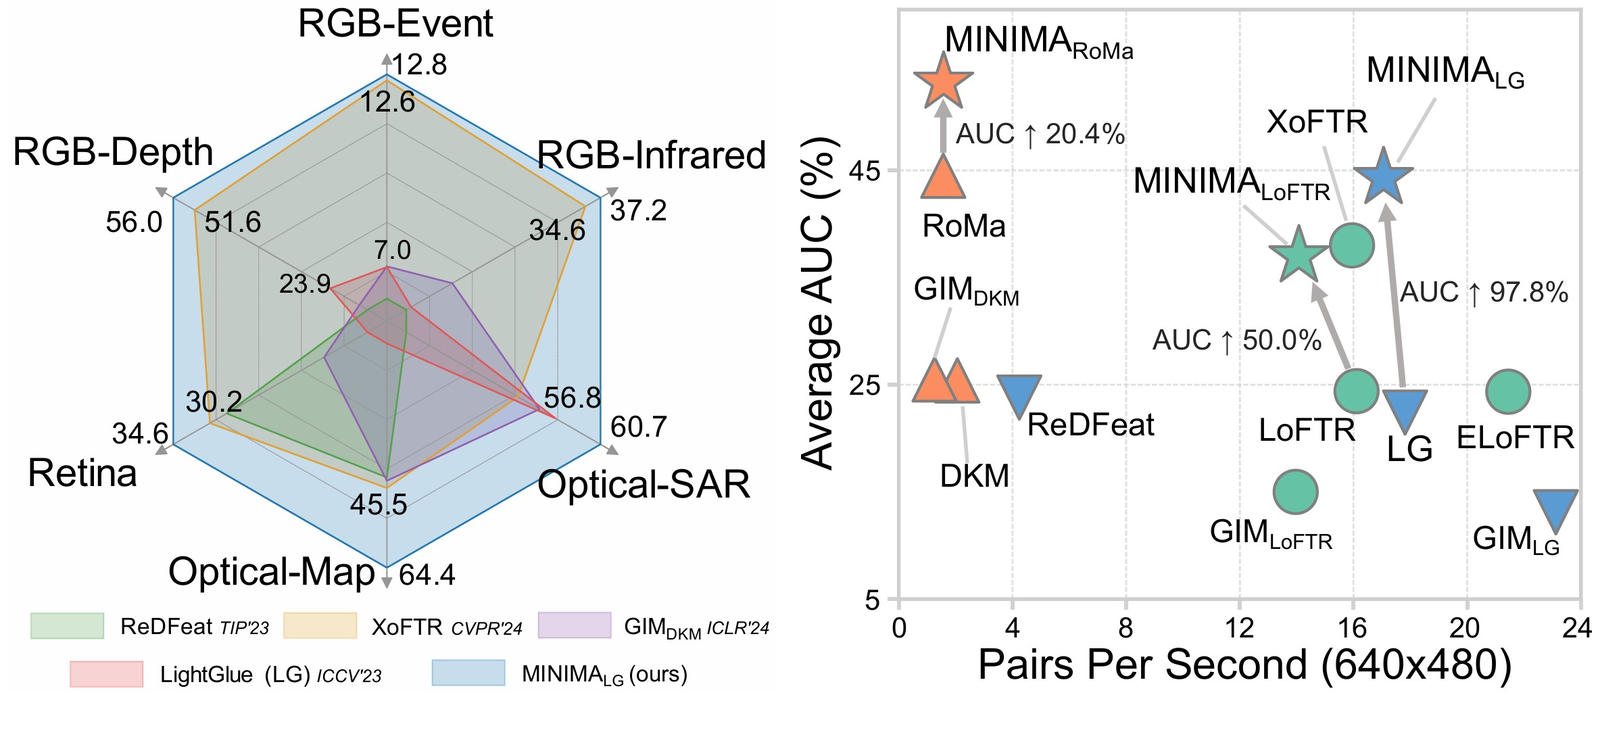
TL;DR 跨模态匹配的瓶颈不是网络不够花哨,而是缺少大规模、带几何标签的多模态数据[1]。MINIMA 的解法是“改数据不改网络”:以 MegaDepth 的 40M 个 RGB 匹配对为源,用 StyleBooth、DepthAnything V2、DSINE、物理事件模拟器、PaintTransformer 和 Anime2Sketch 把它们逐像素转成红外、深度、法向、事件、油画、素描六种伪模态;生成图与 RGB 共享像素网格,因此深度、相机位姿和内参标签原样继承。由此得到 196 个户外场景、7 种模态、约 480M 个跨模态对的 MD-syn,再用很小的学习率微调现成的 LightGlue、LoFTR 和 RoMa,得到 MINIMA 家族。只见过合成 IR/Depth/Normal 的模型,在真实 RGB-IR 的 METU-VisTIR 上把 MINIMA-RoMa 的 AUC@5° 从 RoMa 的 25.61 提到 37.45,MINIMA-LG 从 2.17 提到 19.14,后者甚至超过专门为 RGB-IR 设计的 XoFTR(18.47);零样本遥感、医学、RGB-Event 也普遍好于对应底座。代价是模型相关:MegaDepth-1500 上 MINIMA-RoMa 基本无损(61.7 对 62.6),MINIMA-LoFTR 却从 53.6 崩到 29.9。代码、权重、数据引擎和 480M 数据集均已开源。
- 论文:MINIMA: Modality Invariant Image Matching,Jiangwei Ren、Xingyu Jiang、Zizhuo Li、Dingkang Liang、Xin Zhou、Xiang Bai,华中科技大学 / 武汉大学,CVPR 2025(arXiv 2024-12-27,v2 2025-03-29)。
- 代码:github.com/LSXI7/MINIMA(Apache-2.0;
MINIMA_LG使用的 SuperPoint 是另一套限制性许可,见文末)。 - 前作 / 预备知识:LoFTR、LightGlue、RoMa、XoFTR、FlexGlue、RaCo。
一、动机:缺的是数据,不是模块
跨模态图像匹配是很多系统的前置环节:红外与可见光融合、深度增强、事件相机视觉、医学图像配准、遥感变化检测,都要先在不同成像系统之间找到同名点。它比同模态匹配难,因为两幅图的像素强度可能完全不在一个统计分布里:同一栋楼在 RGB 里是米色墙面加窗户,在红外里可能只剩一片均匀亮区,在深度图里是按距离着色的色块,在事件相机里只剩亮度变化处的红蓝点。
1.1 两条路线各自的天花板
路线一:为特定模态设计不变特征。 手工方法如 RIFT[2] 用辐射变化不敏感的特征变换;学习方法如 ReDFeat[3] 用检测-描述解耦;半稠密方法如 XoFTR[4] 直接在多光谱数据上训练 LoFTR 变体。这条路线在目标模态上可以很强,但通常一个模型只服务一对模态,换一对就要重新设计、重新收数据;而且真实多模态数据集很小,场景覆盖窄,模型容易记住数据集而不是学会匹配。论文的表 1 把这一点量化得很清楚:METU-VisTIR 只有 2.5K 对、6 个户外场景,M3FD 4.2K 对 / 15 个场景,LLVIP 15K 对 / 26 个场景,DIODE 25K 对 / 20 个场景,DVS128 只有 1.3K 对;相比之下 MegaDepth 有 40M 对、196 个场景,ScanNet 有 230M 对、1513 个场景。[5, 6]
路线二:把同模态匹配器直接搬到跨模态。 SuperGlue、LightGlue、LoFTR、DKM、RoMa 这类模型在 MegaDepth / ScanNet 上训练,架构和训练配方都很成熟。[7, 8, 9, 10, 11] 但它们的特征是在 RGB 上学到的,换到红外、深度、事件上会明显退化。论文表 2 的合成基准上,LightGlue 在 RGB-Depth 的 AUC@10° 只有 2.87,LoFTR 只有 0.44;也就是说,绝大多数图像对连一个可用的相对位姿都估不出来。这不是微调一下分类头能解决的问题,而是训练分布里根本没有这些外观。
两条路线的共同盲区是数据:真实多模态配对难采(要同时架设多台相机、保证同步和重叠),几何标签更难标(手工点、标定、或昂贵的 SfM)。所以现有工作只能在“小数据上做模态专用设计”和“大数据上做 RGB 专用设计”之间二选一。
1.2 本文的赌注:把“外观”换掉,把“几何”留下
MINIMA 的观察很朴素:匹配真正需要的是几何结构,而不是某种固定的像素强度。同一场景的 RGB、红外、深度、法线、事件图,外观千差万别,但建筑边缘、窗户角点、人物轮廓、道路边界这些几何线索是共享的。既然如此,能不能保留 RGB 数据的几何和标签,只把外观“翻译”成目标模态?
这就是论文所说的 data engine:不追求一个新的匹配模块,而是造一个可扩展的数据生成管线。它的三个卖点对应论文第 3.2 节:
- 便宜:源数据是公开的 RGB 匹配数据(MegaDepth),不需要在野外同时采集多传感器数据。
- 灵活:想要哪种模态,就接一个对应的生成器;模态的数量、比例、场景分布都可以自由定义。
- 标签免费:生成图与 RGB 在同一像素网格上,深度图、相机位姿、内参不需要重新标注,直接继承。
论文的贡献可以概括为三条:
- 提出一个由「源数据 + 引导数据 + 生成模型」组成的数据引擎,把廉价 RGB 匹配数据扩成多模态匹配数据;
- 构建 MD-syn:196 个户外场景、7 种模态(RGB + 6 种伪模态)、约 480M 个跨模态对,带深度和位姿标签;
- 用 MD-syn 微调 LightGlue、LoFTR、RoMa,得到 MINIMA 家族;在 19 个真实跨模态 case 上验证 in-domain 和 zero-shot,并把代码、权重、数据引擎、数据集全部开源。
二、核心方法
2.1 总体流程:三件事,没有新网络
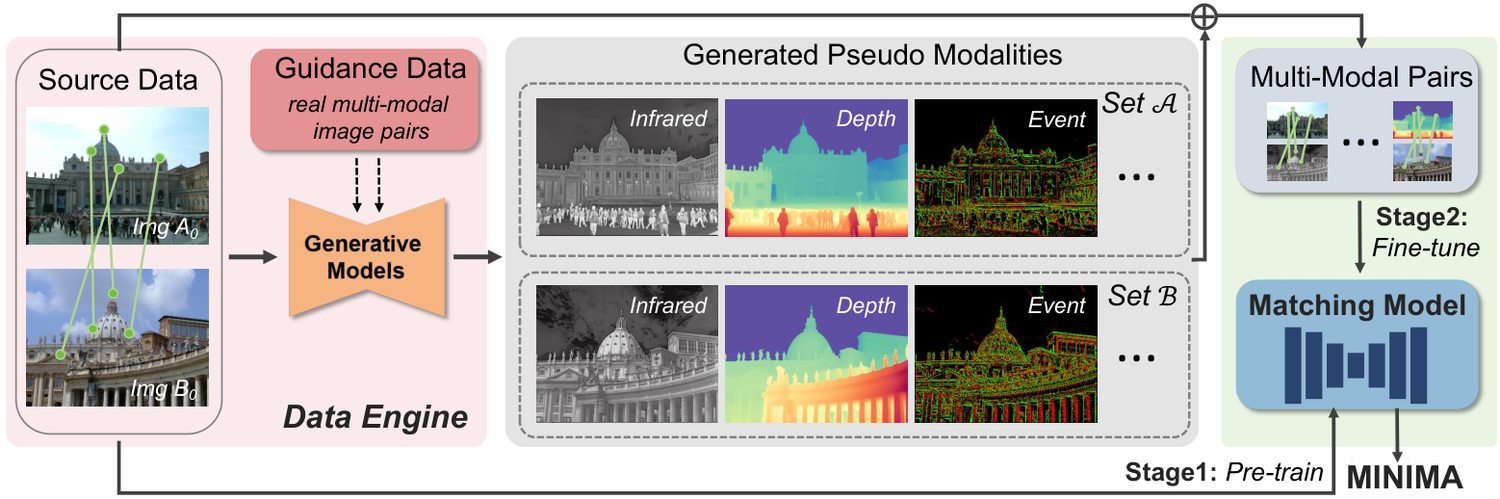
设源 RGB 匹配对为 ,其几何标签为相机内参 、相对位姿 和深度图 。对第 种目标模态,生成器 做的是逐像素的图像到图像转换:
因为 不改变图像尺寸和像素坐标,生成图上的任意像素 仍对应原图的同一场景点。于是
匹配标签(相对位姿或单应)是 和 的函数,所以也原样继承。对 种模态,每个 RGB 对可以拆出 个跨模态对:
这里有两个容易忽略的细节。
第一,生成器是 image-to-image,不是 text-to-image。输入是同一张 RGB,输出保持构图;如果让模型凭空生成“一张红外图”,几何就对不上了,标签也就无从继承。这是整个数据引擎能成立的前提。
第二,“模态不变”不是一条损失项。论文没有在网络上加模态判别器、对抗损失或不变性正则;它只是把不同模态的图像对混在同一个匹配目标里训练,让网络自己学出对 appearance 不敏感、对 geometry 敏感的特征。这一点在 2.4 节还会展开。
标签继承在代码里非常直白:读取伪模态视图时,文件名、位姿、内参都从原 RGB 视图的同一索引取,只是把根目录换成对应模态的目录。
代码:伪模态视图的读取(官方 gluefactory/datasets/megadepth.py,原文节选)
    def _read_view2(self, scene, idx, png=False):
        path = self.multi_model_root / self.images[scene][idx]

        # read pose data
        K = self.intrinsics[scene][idx].astype(np.float32, copy=False)
        T = self.poses[scene][idx].astype(np.float32, copy=False)

        # read image
        if self.conf.read_image:
            if png:
                name = self.images[scene][idx].replace('jpg', 'png')
            else:
                name = self.images[scene][idx].replace('png', 'jpg')

            img = load_image(self.multi_model_root / name, self.conf.grayscale)


        else:
            size = PIL.Image.open(path).size[::-1]
2.2 数据引擎:六种伪模态怎么造
论文的生成器选择遵循一个原则:能直接用现成模型就用现成模型,只有红外这种“RGB 到热成像”跨得太大、现成模型效果差的,才用真实配对数据微调。具体配置如下。
| 目标模态 | 生成器 | 是否需要真实引导对 | 关键设置 |
|---|---|---|---|
| 红外(Infrared) | StyleBooth[12] + LoRA[13] | 是,LLVIP + M3FD 的 80% | LoRA rank 256,,210k steps,lr ,batch 2,单卡 |
| 深度(Depth) | DepthAnything V2-L[14] | 否 | 单目相对深度,按 Spectral_r 色图归一化到 0–255 |
| 法向(Normal) | DSINE[15] | 否 | 逐像素射线方向,估计表面法向 |
| 事件(Event) | 物理模拟器 | 否 | 对数亮度差,阈值 ,随机 1–3 px 位移 |
| 油画(Paint) | PaintTransformer[16] | 否 | 前馈笔画预测 |
| 素描(Sketch) | Anime2Sketch[17] | 否 | CLAHE clip 10,load size 1024 |
红外。 这是唯一需要“学风格”的模态。论文用 StyleBooth 作为底座:它原本是多模态指令驱动的风格编辑扩散模型,作者用 LLVIP[18] 和 M3FD[19] 中 80% 的对齐 RGB-IR 对微调,让模型学会“把可见光照片变成热成像外观”,剩下 20% 作为生成质量测试。LoRA rank 256 是在单卡上能承受的容量; 是生成分辨率,保证后续匹配时细节不糊。图 3 是数据引擎的示例:同一张照片被转成红外、深度、事件、法向、素描、油画六种外观。
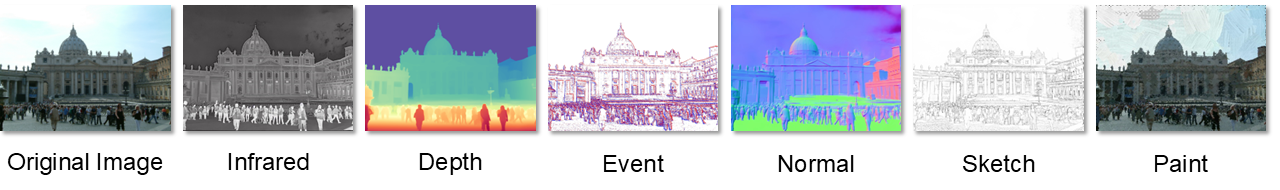
深度与法向。 这两个模态直接调用现成模型。深度用 DepthAnything V2 的大模型,输出单目相对深度,再归一化并用 Spectral_r 上色。这里要区分两件事:伪深度图的像素值只是相对深度的可视化,不是米制深度;训练时用的深度标签仍然是 MegaDepth 提供的原深度图。法向用 DSINE,它把表面法向估计写成逐像素射线方向之间的相对旋转,输出的 RGB 三通道分别编码法向的三个分量。两者都不需要真实引导对,因为单目深度/法向估计的零样本能力已经足够好。
事件。 事件相机不是记录亮度,而是记录亮度变化。论文用式 (1) 的简化模型:
其中 是对数亮度, 是时间对比阈值, 是极性。代码里对 Log 亮度图做随机位移(1–3 px)来模拟轻微运动,然后逐像素比较位移前后的亮度差:超过 记红色,低于 记蓝色,其余保持白色。这解释了一个重要细节:伪事件图与 RGB 不是严格逐像素对齐的,随机位移最多带来几个像素的偏移;论文把它当作传感器噪声/增强,而不是精确几何。这一点在局限里还会提到。
代码:事件模拟器(官方 data_engine/tools/event/event_transfer.py,原文照录)
def random_shift(shift_min, shift_max):
    range_choice = random.choice([(shift_min, shift_max), (-shift_max, -shift_min)])
    return random.randint(*range_choice)


def event_transfer_single(image_path, contrast_min=0.05, contrast_max=0.5, shift_min=1, shift_max=3):
    gray_img = cv2.imread(image_path, cv2.IMREAD_GRAYSCALE).astype(np.float32)
    gray_img_log = np.log1p(gray_img)

    contrast_threshold = random.uniform(contrast_min, contrast_max)

    xshift = random_shift(shift_min, shift_max)
    yshift = random_shift(shift_min, shift_max)

    pic_shape = [gray_img.shape[0], gray_img.shape[1], 3]
    img = np.full(pic_shape, [255, 255, 255], dtype=np.uint8)

    for i in range(abs(yshift), gray_img.shape[0] - abs(yshift)):
        for j in range(abs(xshift), gray_img.shape[1] - abs(xshift)):
            delta_L = gray_img_log[i + yshift, j + xshift] - gray_img_log[i, j]
            if delta_L > contrast_threshold:
                img[i, j] = [255, 0, 0]
            elif delta_L < -contrast_threshold:
                img[i, j] = [0, 0, 255]

    return img
油画与素描。 这两个“艺术模态”不是物理传感器,但论文仍然加进来,目的是测试数据引擎是否只对“物理模态”有效。PaintTransformer 用前馈网络预测笔画,Anime2Sketch 把照片转成线稿。它们与 RGB 的差距比红外/深度小,所以后面的实验里增益也最小,甚至个别指标会掉——这符合直觉:如果新模态没有提供新的几何/外观变化,数据引擎就只是在重复 RGB 信息。
深度生成的实现。 深度转换只有“推理 + 归一化 + 上色”三步,没有任何训练;这也是数据引擎“便宜”的来源之一。
代码:深度伪模态生成(官方 data_engine/tools/depth/depth_transfer.py,原文节选)
def process_image(image, model):
    depth = model.infer_image(image)  # HxW raw depth map in numpy
    cmap = matplotlib.colormaps.get_cmap('Spectral_r')

    depth = (depth - depth.min()) / (depth.max() - depth.min()) * 255.0
    depth = depth.astype(np.uint8)

    depth_colored = (cmap(depth)[:, :, :3] * 255)[:, :, ::-1].astype(np.uint8)
    return depth_colored
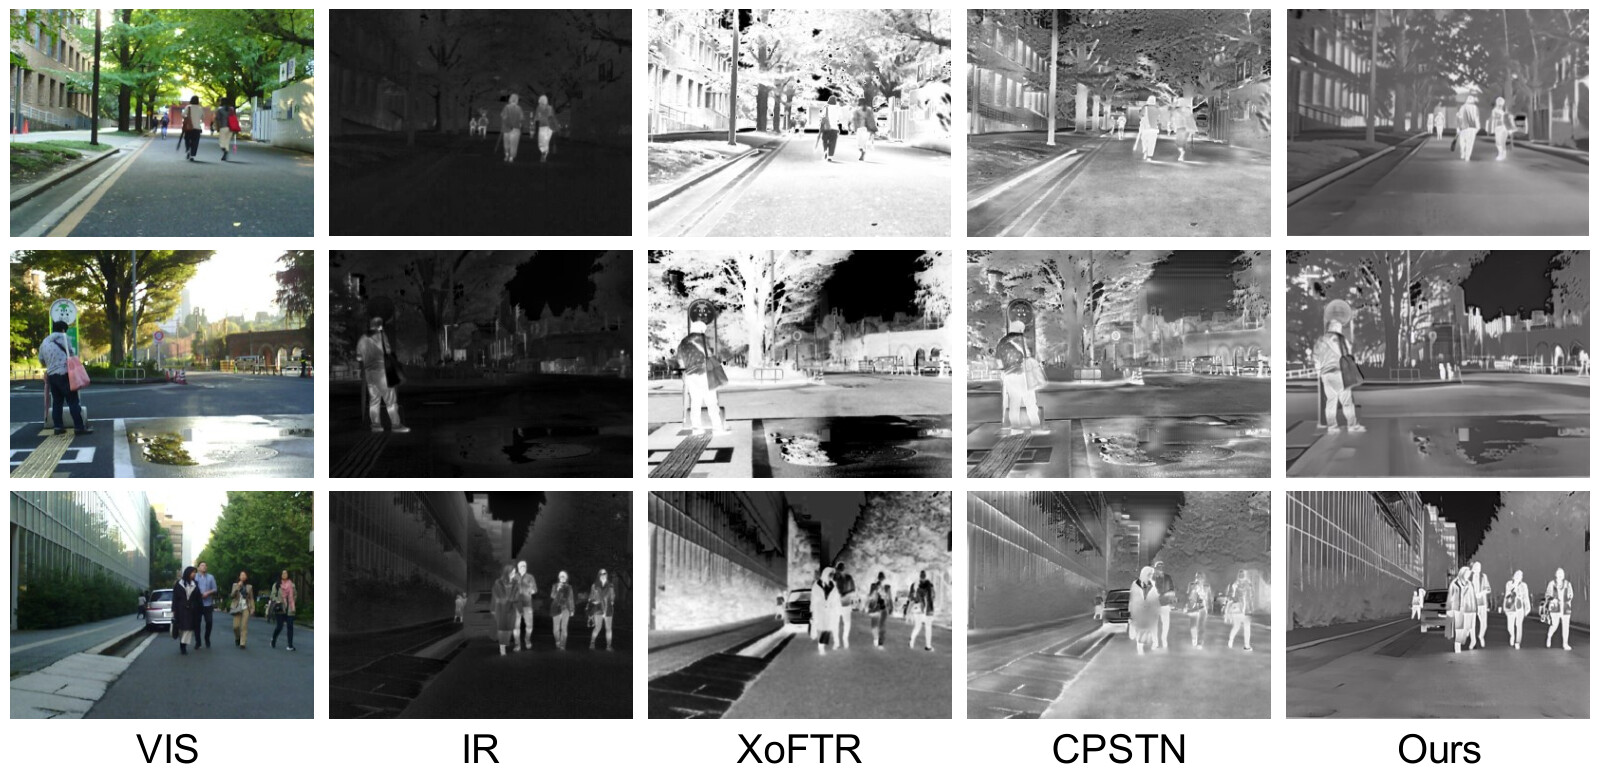
红外生成质量。 论文在 LLVIP、M3FD、MSRS 三个数据集上,把生成的伪红外和真实红外对比(表 A1)。PSNR 都在 27.8–28.3 dB 之间,差距不到 0.5 dB,说明逐像素亮度并不是这项任务的关键;更有区分度的是结构/感知指标:LLVIP 上本方法的 SSIM 是 0.55,CPSTN[20] 是 0.32,XoFTR 是 0.29;LPIPS 是 0.42,对手是 0.66/0.71;FID 是 145.93,对手是 303.55/204.44。M3FD 上 SSIM 0.53 对 0.37/0.33,FID 119.96 对 161.71/125.07。MSRS 上优势缩小(SSIM 0.19 对 0.15/0.16,FID 161.37 对 204.37/167.39),说明跨数据集时红外生成仍然吃风格差异。
数据清洗。 生成模型可能产生几何畸变或错误内容,所以论文做了一个自检:对每个 RGB 图和它的伪模态图,用已经在目标模态上微调过的匹配模型估计单应,真值应当是单位矩阵;如果四个角点的平均投影误差超过 10 px,就判为脏数据丢弃。最终训练集只丢了 0.91% 的匹配对。这个比例很低,一方面说明生成器大多保持了构图,另一方面也说明清洗只抓“大畸变”,抓不到细微的语义 hallucination。
2.3 MD-syn:480M 对与它的真实含义
MD-syn 的规模来自一个简单的乘法:MegaDepth 有 40M 个 RGB 对,每个对生成 6 种伪模态、两个方向(RGB→伪模态、伪模态→RGB),总共 480M 个跨模态对。数据集包含 196 个户外场景、7 种模态(RGB + 6 种伪模态),标签是深度和位姿。和表 1 里的真实数据集相比,它的“对数量”高出一个到五个数量级,但场景数仍然是 MegaDepth 的 196 个。
| 数据集 | 对数 | 场景数(类型) | 模态数 | 标签形式 |
|---|---|---|---|---|
| MegaDepth | 40M | 196(室外) | 1 | 深度、位姿 |
| ScanNet | 230M | 1513(室内) | 1 | 深度、位姿 |
| METU-VisTIR | 2.5K | 6(室外) | 2 | 位姿 |
| M3FD | 4.2K | 15(室外) | 2 | 预对齐 |
| LLVIP | 15K | 26(室外) | 2 | 预对齐 |
| DIODE | 25K | 20(室内外) | 3 | 预对齐 |
| NYU-Depth V2 | 408K | 464(室内) | 2 | 预对齐 |
| DVS128 | 1.3K | 122(室内) | 2 | 预对齐 |
| MD-syn(本文) | 480M | 196(室外) | 7 | 深度、位姿 |
这张表里最该被记住的不是 480M,而是最后一行的“196”。480M 是 40M × 6 × 2 的配对数,不是 480M 张独立照片,也不是 480M 个独立场景。同一个 RGB 对的 12 个跨模态变体共享同一套几何,相关性极高;数据引擎扩的是模态覆盖,不是场景覆盖。论文自己在表 1 里也把 196 个场景原样列出,这一点是诚实的。
另一个容易误解的地方是训练用了多少。MD-syn 有 6 种目标模态,但最终发布的统一模型只用了 RGB-IR、RGB-Depth、RGB-Normal 三种(约 240M 个潜在对);Event、Sketch、Paint 被留作零样本测试。配置文件里的 modality 列表写得很清楚:
代码:LightGlue 版训练配置(官方 train_orders/minima_lightglue_train_config.yaml,原文照录)
MINIMA_LIGHTGLUE:
  dataset:
    #    modality: [ 'visible', 'infrared', 'depth', 'event', 'normal', 'sketch', 'paint' ]
    modality: [ 'visible', 'infrared', 'depth', 'normal' ]


  train:
    lr_scale: 1.0
    experiment: minima_lightglue
    # else config please change in MINIMA/third_party/glue_factory_minima/gluefactory/configs/superpoint+lightglue_megadepth.yaml
    load_feature: false

  weight:
    pre_trained: true
    pre_trained_path: './weights/superpoint_lightglue.pth'
    resume_from_checkpoint: false # if true, load the model from the checkpoint in experiment folder
数据集采样时,每个样本随机选一种目标模态和一个方向。代码里的 reverse_mode 控制谁是 RGB、谁是伪模态;multi_model 从 modal_options 里抽。这个随机化是“统一模型”的关键:同一个网络在每次迭代看到不同的模态组合,而不是为每种模态训练一个单独的分支。
代码:随机模态与方向采样(官方 gluefactory/datasets/megadepth.py,原文节选)
    def getitem(self, idx):
        reverse_mode = self.local_random_1.randint(0, 1)  # 0: visible-infrared, 1: infrared-visible
        self.multi_model = self.local_random_2.choice(self.modal_options)
        self.multi_model = str(self.multi_model).strip().strip('"').strip("'")
        try:
            self.multi_model_root = self.modality_to_root[self.multi_model]
        except KeyError:
            raise ValueError(f"Unknown multi_model: {self.multi_model}")
        if self.conf.views == 2:
            idx = idx // 2
            if isinstance(idx, list):
                scene, idx0, idx1, overlap = idx
            else:
                scene, idx0, idx1, overlap = self.items[idx]

            print('multi_model:', self.multi_model, 'reverse_mode:', reverse_mode)
            if reverse_mode:
                if self.multi_model in ['infrared', 'depth', 'normal', 'paint', 'sketch']:
                    data0 = self._read_view(scene, idx0)
                    data1 = self._read_view2(scene, idx1, png=False)
                elif self.multi_model in ['event']:
                    data0 = self._read_view(scene, idx0)
                    data1 = self._read_view2(scene, idx1, png=True)
                elif self.multi_model == 'visible':
                    data0 = self._read_view(scene, idx0)
                    data1 = self._read_view(scene, idx1)
                else:
                    raise ValueError(f"Unknown multi_model: {self.multi_model}")
            else:
                if self.multi_model in ['infrared', 'depth', 'normal', 'paint', 'sketch']:
                    data0 = self._read_view2(scene, idx0, png=False)
                    data1 = self._read_view(scene, idx1)
                elif self.multi_model in ['event']:
                    data0 = self._read_view2(scene, idx0, png=True)
                    data1 = self._read_view(scene, idx1)
                elif self.multi_model == 'visible':
                    data0 = self._read_view(scene, idx0)
                    data1 = self._read_view(scene, idx1)
                else:
                    raise ValueError(f"Unknown multi_model: {self.multi_model}")
下面这个部件把“数据账本”做成可拖的:源 RGB 对数 和目标模态数 决定总配对数 。默认 40M × 6 正好是论文的 480M;把 拉到 3,就得到最终模型实际使用的约 240M。
模态差距有多大。 图 5 是论文附录里的像素强度统计:沿同一行画 RGB、红外、深度、事件、法向、油画、素描的强度曲线。RGB 曲线有剧烈的纹理波动,红外是一条平滑但完全不同的曲线,深度是分段常数,事件只在边缘处有脉冲,法向和油画/素描又各有自己的统计。这些曲线说明:跨模态匹配不是“加一点颜色扰动”,而是输入分布的整体改变;也说明为什么只在 RGB 上训练的 LightGlue 会在深度上跌到 2.87。
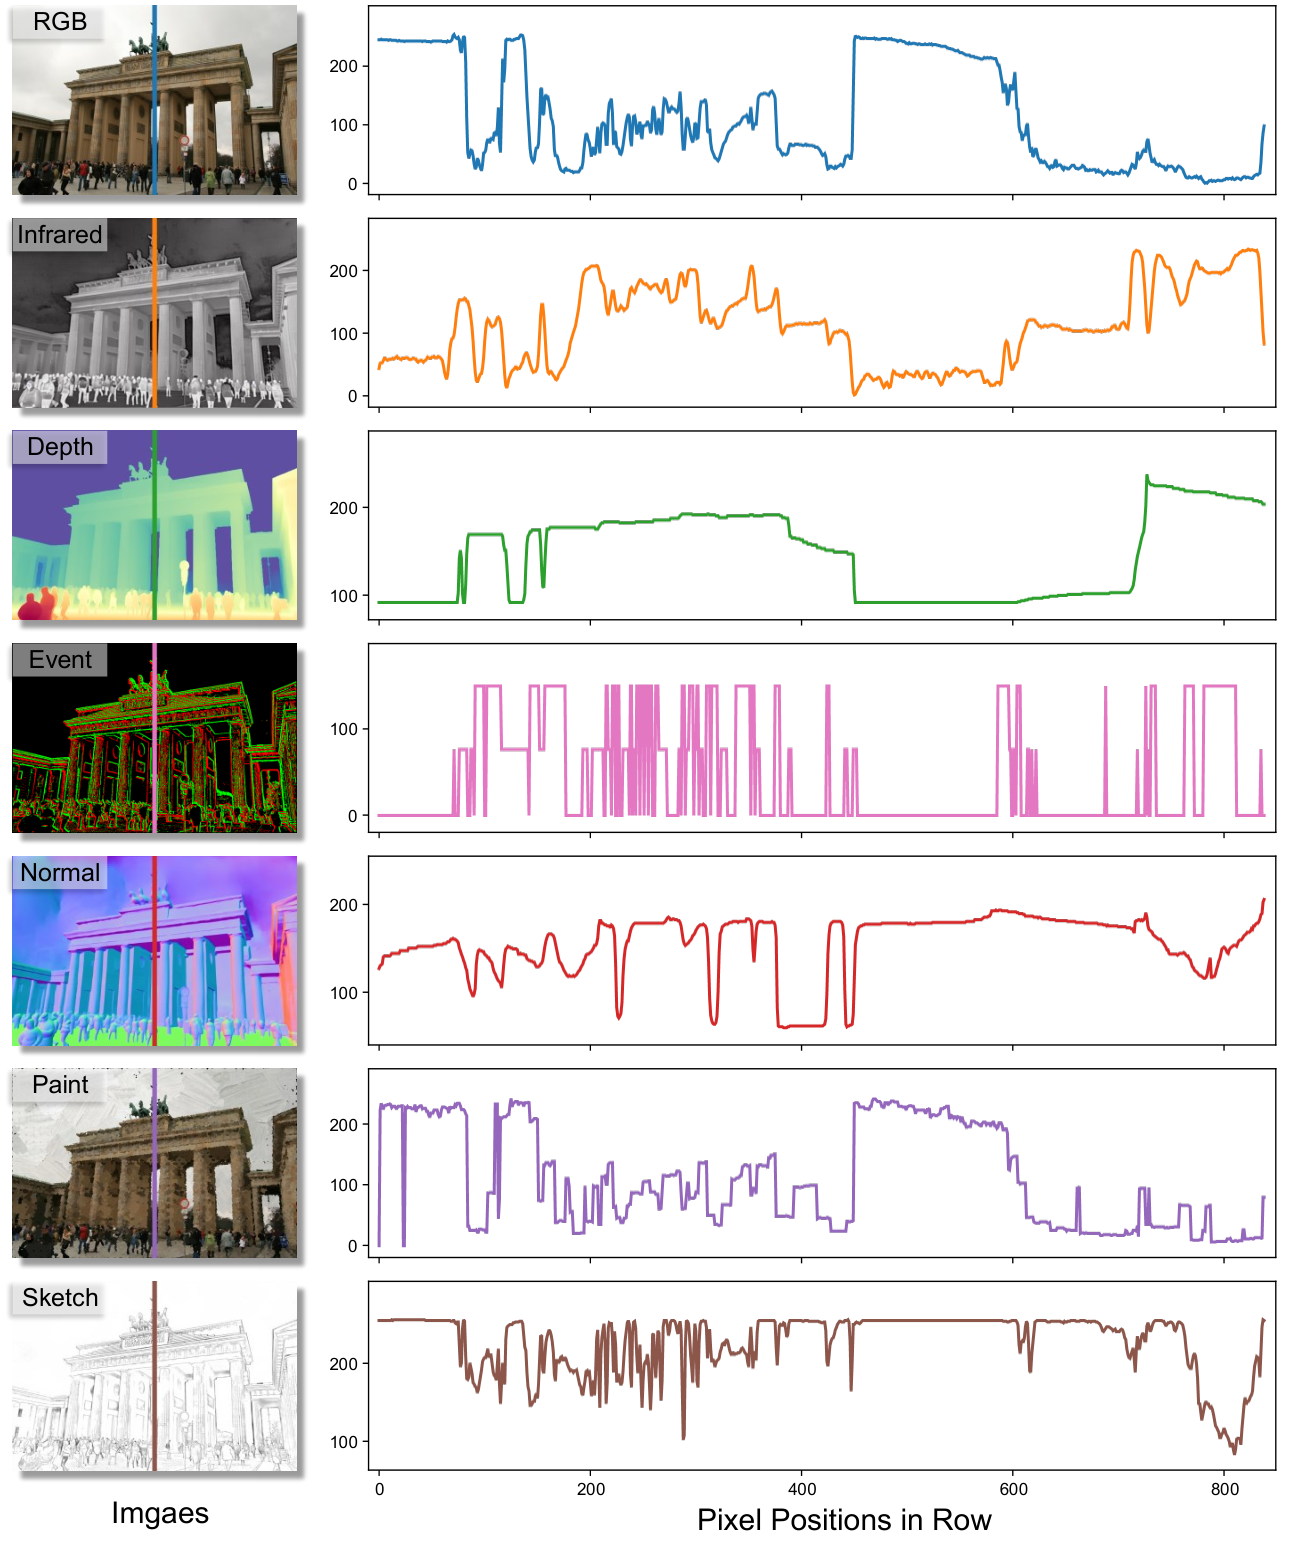
2.4 模态不变训练:只微调,不改结构
论文的训练分两阶段:
- Stage 1:在 RGB 多视图数据上预训练到收敛。 直接使用 LightGlue、LoFTR、RoMa 的官方权重,不重新训练。
- Stage 2:在随机采样的跨模态对上用小学习率微调。 每个 iteration 随机选一种模态和一个方向,目标函数用各底座原来的匹配损失,不额外加模态分类/对抗/不变性损失。
为什么不在 MD-syn 上从零训练?论文给了两个理由。第一,不同模态之间的方差太大,从零训练需要很多迭代才能收敛;第二,RGB 预训练已经提供了很好的边缘/纹理先验,微调可以快速把匹配头“掰”到跨模态分布上。图 6 的曲线很直观:从零训练(蓝线)的 loss 从 2.2 开始,前 10 个 epoch 快速降到 1.0 附近,之后缓慢下降;30 个 epoch 时 AUC@5° 约 14.7。微调(橙线)从 1.0 开始,30 个 epoch 时约 18.7,而且前 5 个 epoch 就拉开了差距。
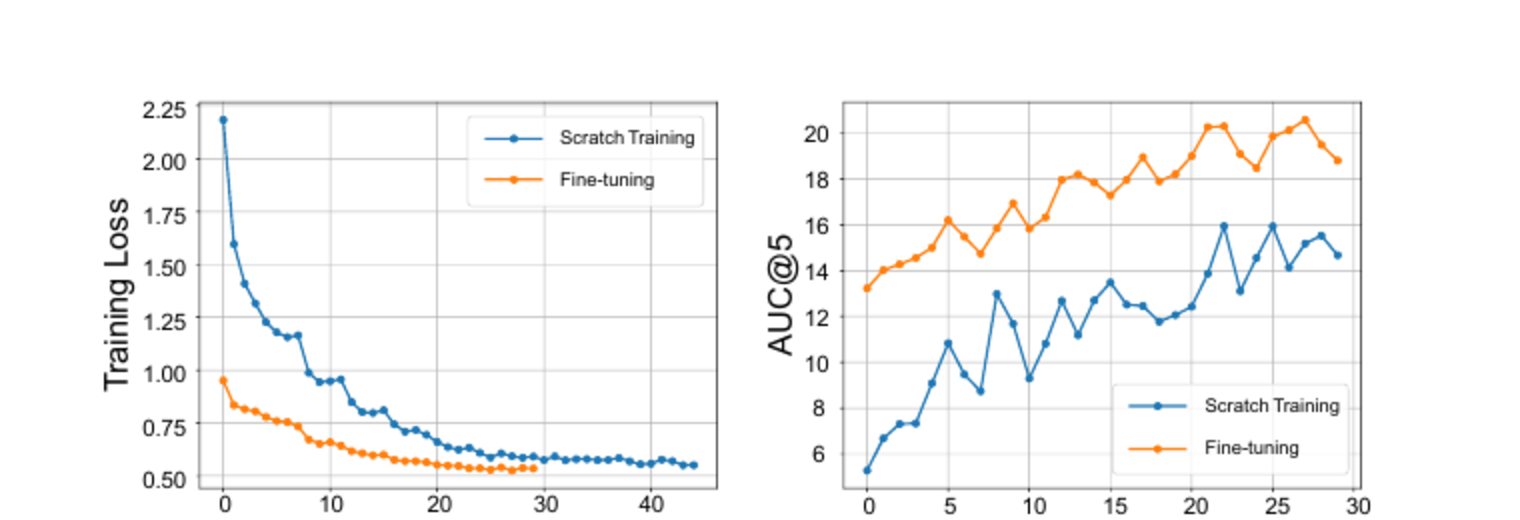
三个底座的具体超参:
| 底座 | 可训练部分 | 学习率 | epoch | 分辨率 / batch | 总 batch(4×3090) |
|---|---|---|---|---|---|
| LightGlue | 只调 LightGlue,SuperPoint 冻结 | 50 | 默认 / — | 32 | |
| LoFTR | 全部 | (原 1/10) | 30 | 640 / 每卡 2 | 8 |
| RoMa | 全部 | decoder ,encoder | 4 | 560(medium)/ 每卡 3 | 12 |
LightGlue 只调匹配头、冻结 SuperPoint,是因为 SuperPoint 在跨模态图像上仍然能提出可匹配的角点(论文引用 MMIM 的结论);LoFTR 和 RoMa 则整体微调,但把学习率降到原来的 1/10,避免把 RGB 预训练的特征完全冲掉。RoMa 只训 4 个 epoch,论文的说法是“它本身的能力已经很强”,不需要长时间微调。
这一节的“所以呢”落在表 6 的消融上(LoFTR 底座,AUC@10):
| 训练策略 | 合成 RGB-IR | 真实 RGB-IR | 真实 RGB-Depth |
|---|---|---|---|
| 原始 LoFTR | 12.58 | 6.94 | 15.16 |
| (1) 在合成 IR 上从零训练 | 23.63 | 21.41 | 30.04 |
| (2) 在真实 IR(LLVIP+M3FD)上微调 | 6.28 | 9.78 | 32.93 |
| (3) 在合成 IR 上微调 | 29.43 | 29.55 | 39.23 |
| (4) 在合成 Depth 上微调 | 17.30 | 15.12 | 36.06 |
| (5) 在合成 IR/Depth/Normal 上微调 | 32.36 | 30.84 | 44.85 |
三个结论:
- 微调 > 从零训练:(3) 在合成和真实 IR 上都明显高于 (1),说明 RGB 预训练的先验确实有用。
- 合成数据 > 小规模真实数据:(3) 在合成/真实 IR 上是 29.43/29.55,而 (2) 只有 6.28/9.78;真实 IR 数据太少,模型记住了 LLVIP/M3FD 的域,反而不会泛化。
- 跨模态可以互相迁移:(4) 只在合成深度上训练,却在真实 RGB-IR 上达到 15.12,甚至比 (2) 的真实 IR 微调(9.78)更好;三种模态混合的 (5) 又在三个测试上都最好。这说明数据引擎提供的不是“某种模态的补丁”,而是一种共享的几何监督。
2.5 评测协议:19 个真实 case 加 6 个合成 case
论文的评测范围要分两层看:
- MD-syn 合成基准:6 个跨模态 case,3 个 in-domain(RGB-IR、RGB-Depth、RGB-Normal,训练时见过),3 个 zero-shot(RGB-Event、RGB-Sketch、RGB-Paint,训练时没见过)。六个 case 共用 MegaDepth 的 2 个测试场景、1500 个图像对。
- 真实数据:5 个多模态数据集,共 19 个跨模态 case——METU-VisTIR 的 RGB-IR,DIODE 的 RGB-Depth/Normal,DSEC 的 RGB-Event(3 个序列、100 对),MMIM 的 7 个遥感 case 和 6 个医学 case。[21, 22, 23]
评测指标分两类:两视图位姿用 AUC@{5°,10°,20°},单应(homography)用 AUC@{3px,5px,10px}。跨模态评测中所有图像长边统一缩到 640(3.3 的 MegaDepth-1500 回归按原方法用 1200/1600),所有方法用同一套 RANSAC 参数,计时在单张 RTX 3090 上。对于本来就对齐的图像对(DIODE、医学、遥感),评测前会人为加一个单应变换来模拟视角形变,再让方法去恢复,以保证公平。
基线覆盖三类:稀疏(SuperGlue、LightGlue、OmniGlue、GIM-LG、ReDFeat、RIFT/SRIT/LNIFT),半稠密(LoFTR、ELoFTR、XoFTR、GIM-LoFTR),稠密(DKM、GIM-DKM、RoMa)。[7, 8, 24, 25, 26, 3, 2] 所有稀疏方法(包括 MINIMA-LG)用 SuperPoint 提 2048 个关键点。[27]
三、实验结果
3.1 MD-syn:合成基准上的模态差距
先看合成数据。下面的部件让你在同一场景的四种伪模态之间切换,并在 LightGlue 和 MINIMA-LG 之间切换。默认是 RGB-Depth + LightGlue:伪深度图几乎全是错误匹配,柱状图也显示 2.87 对 32.53 的差距。切到 MINIMA-LG,连线会明显变绿——这就是“只换数据、不换网络”带来的变化。
表 2 的完整数字太大,这里只摘出六个代表模型在 AUC@10° 上的结果:
| 方法 | RGB-IR | RGB-Depth | RGB-Normal | RGB-Event | RGB-Sketch | RGB-Paint |
|---|---|---|---|---|---|---|
| LightGlue | 17.73 | 2.87 | 24.93 | 22.40 | 44.47 | 27.99 |
| MINIMA-LG | 30.24 | 32.53 | 37.33 | 36.27 | 45.71 | 32.85 |
| LoFTR | 12.58 | 0.44 | 12.07 | 12.43 | 54.82 | 12.22 |
| MINIMA-LoFTR | 32.36 | 28.81 | 44.26 | 32.74 | 53.54 | 15.45 |
| RoMa | 35.99 | 22.75 | 59.48 | 58.87 | 73.90 | 58.36 |
| MINIMA-RoMa | 40.94 | 48.58 | 64.48 | 61.48 | 74.30 | 57.21 |
几个值得注意的现象:
- 深度是最大的短板,也是提升最大的地方。 LightGlue 从 2.87 到 32.53(11.3 倍),LoFTR 从 0.44 到 28.81(65 倍),RoMa 从 22.75 到 48.58(2.1 倍)。深度图没有纹理,只有分段平滑的距离色块;RGB 预训练的纹理匹配器几乎无法工作,而数据引擎补上了这种外观。
- 红外和事件的提升也很稳定。 LightGlue 的红外 17.73→30.24、事件 22.40→36.27;LoFTR 的事件 12.43→32.74;RoMa 的红外 35.99→40.94、事件 58.87→61.48。
- 素描和油画的增益最小,甚至为负。 LoFTR 的素描 54.82→53.54,RoMa 的油画 58.36→57.21。论文的解释是这两种艺术模态与 RGB 最接近,没有提供新的模态信息;这反过来支持了“收益来自模态差距”的假设。
- 排序大体不变,但有交叉。 RoMa 仍是三个底座里最强的,MINIMA 把每个底座都往上推;不过 LightGlue(稀疏)在红外、深度、法向、事件上都强于 LoFTR(半稠密),MINIMA-LG 的深度 32.53 也高于 MINIMA-LoFTR 的 28.81。底座本身的强弱,比“稀疏/半稠密/稠密”这个标签更能决定结果。
- GIM 的失败很典型。 GIM-LG 在 RGB-Depth 上是 0.00/0.00/0.12(@5/10/20),ReDFeat 在 RGB-Event 上是 0/0/0;在 RGB 视频上做过大规模预训练,并不自动带来跨模态能力。
3.2 真实跨模态基准:19 个 case
真实数据的结果更适合做成浏览器。下面的部件把 METU-VisTIR(位姿 AUC)、DIODE(单应 AUC)、MMIM 零样本(医学/遥感/事件)、MegaDepth-1500(RGB-only 位姿)和 Aachen Day-Night(视觉定位召回)放在一起;选基准、再选指标,MINIMA 的行用主题色标出。默认是 METU-VisTIR 的 AUC@10°,MINIMA-RoMa 排在第一位。
下面把几个最值得说的点展开。
3.2.1 METU-VisTIR:稀疏模型第一次超过专用半稠密
METU-VisTIR 是真实 RGB-IR 数据集,2590 个图像对,带相机位姿。结果(AUC@5°/10°/20°):
- MINIMA-RoMa:37.45 / 60.70 / 78.00,全场最高;RoMa 底座是 25.61 / 48.12 / 68.37,@5° 提升 46%。
- MINIMA-LG:19.14 / 37.17 / 55.51;LightGlue 底座是 2.17 / 5.37 / 11.21,@5° 提升 8.8 倍(论文说“超过 400%”,按表算是 782%)。它也超过了专门为 RGB-IR 设计的 XoFTR(18.47 / 34.64 / 51.50),只落后 MINIMA-RoMa。
- MINIMA-LoFTR:15.61 / 30.84 / 47.87,虽然比 LoFTR(2.88 / 6.94 / 14.95)高很多,但仍低于 XoFTR。论文把原因归结为 LoFTR 底座较老、半稠密相关在无纹理区域不稳定。
- 手工方法基本失效:RIFT 0.05/0.27/0.90,SRIT 0.00/0.08/0.37,LNIFT 0.02/0.09/0.43;运行时间却是 1.2k–13k ms。这不是同一个时代的方法,放在表里更多是说明“跨模态匹配已经进入数据驱动阶段”。
运行时间方面,MINIMA-LG 58.6 ms 对 LightGlue 57.7 ms,几乎不变;MINIMA-RoMa 633.3 ms 对 RoMa 639.1 ms,也在噪声范围内;MINIMA-LoFTR 71.6 ms 对 LoFTR 61.6 ms,慢约 16%。精度提升没有以吞吐为代价,这是稀疏/稠密两条线的卖点。
3.2.2 DIODE:深度上 RoMa 赢,LoFTR 输给 XoFTR
DIODE 是真实 RGB-Depth 数据集,27858 个对齐对;评测时人为加单应形变,再估计单应,指标是角点误差 AUC@3/5/10px。
- MINIMA-RoMa 28.98 / 50.88 / 72.54,RoMa 9.21 / 24.64 / 49.31;@3px 提升 3.1 倍,@10px 提升 1.5 倍。
- MINIMA-LG 8.71 / 26.80 / 55.97,LightGlue 0.79 / 3.30 / 11.26;@5px 提升 8.1 倍。
- MINIMA-LoFTR 5.35 / 18.65 / 44.85,XoFTR 11.03 / 27.24 / 51.60;三个阈值全输。论文承认这一点:深度数据更难,LoFTR 是“有代表性但老”的模型,没有花哨设计;它把 LoFTR 从 4.20 提到 18.65(@5px),已经是不小的提升,但不足以追上 XoFTR。
这个结果说明“数据引擎”不是万能的:它能补外观分布,但补不了底座架构的天花板。深度图的边缘稀疏、纹理弱,LoFTR 的粗粒度相关在这种输入上吃亏;RoMa 的 DINOv2 特征和稠密回归更适合。选择底座比选择模态更重要。
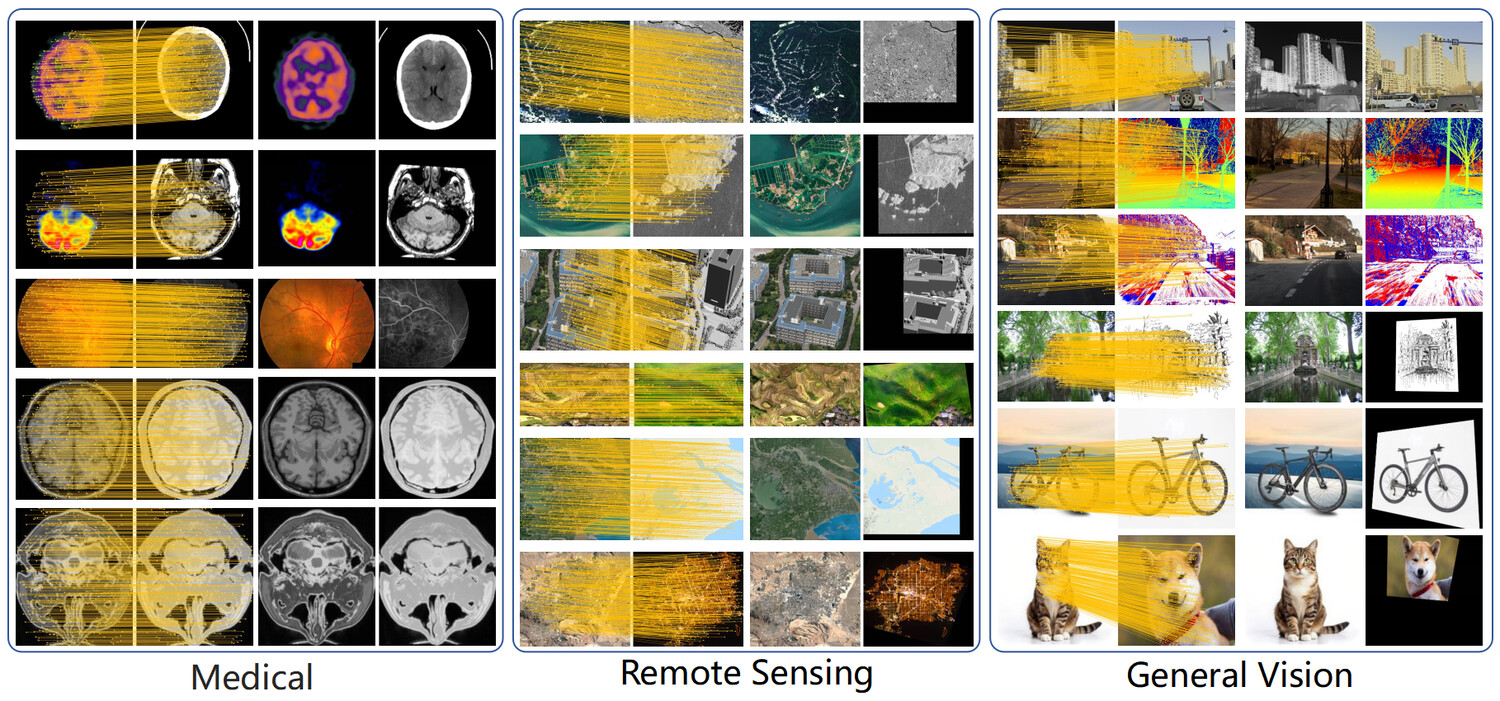
3.2.3 零样本:遥感有效,医学饱和,事件仍然很难
零样本测试用的是训练时完全没见过的模态:MMIM 的 6 个医学 case、7 个遥感 case,以及 DSEC 的 RGB-Event。[23, 22]
- 医学:大多数方法 @5px 都落在 42–46,差距很小,SuperGlue(36.18)和 GIM-LG(27.88)是例外。MINIMA-RoMa 的 @10px 是 57.55,RoMa 53.75;MINIMA-LG 52.50,XoFTR 52.32。论文的解释是医学数据要么太简单、要么太难,AUC 已经饱和,提升空间有限。换句话说,这里的“赢”更多是统计波动,不能过度解读。
- 遥感:这是零样本里最有说服力的部分。MINIMA-RoMa 32.55 / 44.68 / 64.38,RoMa 29.24 / 40.50 / 57.84;MINIMA-LG 23.53 / 38.40 / 58.74,LightGlue 16.22 / 27.51 / 44.62。@10px 上 MINIMA-LG 58.74 甚至略高于 XoFTR 56.63,但 @3/@5px 仍低于 XoFTR(27.35/39.58)。稀疏模型在遥感上的优势主要在宽容差端。
- RGB-Event:绝对值非常低。MINIMA-RoMa 在 @5/@10px 上最好(3.51 / 17.07),但最严格的 @3px 只有 0.54,还低于 RoMa 的 0.85;RoMa 三项是 0.85 / 1.69 / 10.71,MINIMA-LG 0.52 / 2.27 / 12.82,LightGlue 0.00 / 0.67 / 7.02,XoFTR 0.00 / 1.37 / 12.64。17% 的 @10px 离可用还很远。事件相机的极性、噪声、运动模糊与模拟器差距很大,这是零样本里最薄弱的一环。
3.3 RGB-only 与视觉定位:有没有把老本行弄丢
跨模态微调最直接的风险是“灾难性遗忘”:模型学会了红外/深度,却忘了 RGB。论文在 MegaDepth-1500 上做了回归测试(表 A5),并在 Aachen Day-Night 上做了视觉定位(表 A6)。[28]
| 模型 | MegaDepth-1500 AUC@5° / 10° / 20° | 变化 |
|---|---|---|
| LightGlue | 49.9 / 67.0 / 80.1 | — |
| MINIMA-LG | 47.3 / 65.0 / 78.6 | −2.6 / −2.0 / −1.5 |
| LoFTR | 53.6 / 69.9 / 82.0 | — |
| MINIMA-LoFTR | 29.9 / 45.3 / 59.5 | −23.7 / −24.6 / −22.5 |
| RoMa | 62.6 / 76.7 / 86.3 | — |
| MINIMA-RoMa | 61.7 / 76.5 / 86.4 | −0.9 / −0.2 / +0.1 |
结论是高度依赖底座:
- RoMa 基本无损:三个阈值几乎相同,@20° 甚至高 0.1。这是最理想的情况——跨模态能力是“白送”的。
- LightGlue 小幅下降:2 分左右,通常可以接受;如果 RGB 是主业务、跨模态是附加需求,这个代价不算大。
- LoFTR 灾难性回退:从 53.6 掉到 29.9(@5°),几乎腰斩。论文在正文里只说“except for LoFTR”,没有展开;但从表 A5 看,这是 MINIMA 家族最严重的失败模式。可能的原因是 LoFTR 的粗粒度相关层在跨模态分布上被大幅改写,而它本身容量/预训练数据又不如 RoMa,结果两边都没学好。
Aachen Day-Night 的结果则比较温和:MINIMA-LG 在白天 88.3/94.7/98.3、夜晚 85.7/92.9/100.0,LightGlue 是 88.0/93.8/97.5、84.7/91.8/99.0,白天和夜晚都略好。这说明跨模态训练带来的鲁棒性可以迁移到光照变化下的定位,至少对稀疏模型是这样。
3.4 消融:哪些设计真的有用
除了表 6 的训练策略消融,论文还在表 A2 里系统比较了不同模态组合。指标是五个真实跨模态 case(Rel-IR、Rel-Depth、Rel-Event、RS、Medical)的平均 AUC(Rel-IR 用位姿 @10°,其余用单应 @10px):
| 模型 | 原始 | 仅 IR | 仅 Depth | 仅 Normal | 仅 Event | IR+Depth+Normal | 全部六种 |
|---|---|---|---|---|---|---|---|
| MINIMA-LG | 23.55 | 40.81 | 40.86 | 40.47 | 35.75 | 43.44 | 43.17 |
| MINIMA-LoFTR | 25.79 | 36.08 | 32.51 | 36.09 | 31.24 | 39.33 | 39.01 |
| MINIMA-RoMa | 43.95 | 48.54 | 52.74 | 52.45 | 52.40 | 53.96 | 53.79 |
这张表有几个值得细看的地方:
- 单模态就能大幅提升。 LightGlue 只用 IR 微调,平均分从 23.55 到 40.81;只用 Depth 到 40.86;只用 Normal 到 40.47。三种物理模态各自都能把模型拉到一个新台阶,说明它们共享大量几何监督。
- 组合通常更好,但不是单调的。 LightGlue 的 IR+Depth+Normal(43.44)比单模态高,但“全部六种”(43.17)反而略低;LoFTR 的 IR+Depth+Normal(39.33)甚至低于 IR+Depth+Normal+Event(39.93,论文表 A2 有这一行,本文的表未列),全部六种只有 39.01;RoMa 的 IRDN(53.96)是三个模型里最高的,全部六种(53.79)略低。论文的结论“IR/Depth/Normal 组合最好,所以选它作为最终模型”对 LightGlue 和 RoMa 成立,对 LoFTR 只是近似(IR+D+N+Event 更高)。作者仍然统一发布 IRDN 版本,我猜是为了部署一致性;论文没有解释 LoFTR 的这个例外。
- 艺术模态的收益最小。 Paint/Sketch 与 RGB 太接近,提供的新信息有限;这也解释了表 2 里素描/油画指标提升小甚至为负。
另一个消融是“数据规模 vs 真实数据”。表 6 的 (2) 和 (3) 已经说明,用 10K 级真实 IR 对微调,效果远不如用 480M 级合成 IR;但要注意,这不是“合成一定优于真实”的普适结论,而是“在这个任务上,数据规模比数据真实性更重要”。如果真实数据足够大、覆盖足够广,真实数据的上限会更高。
3.5 定性结果
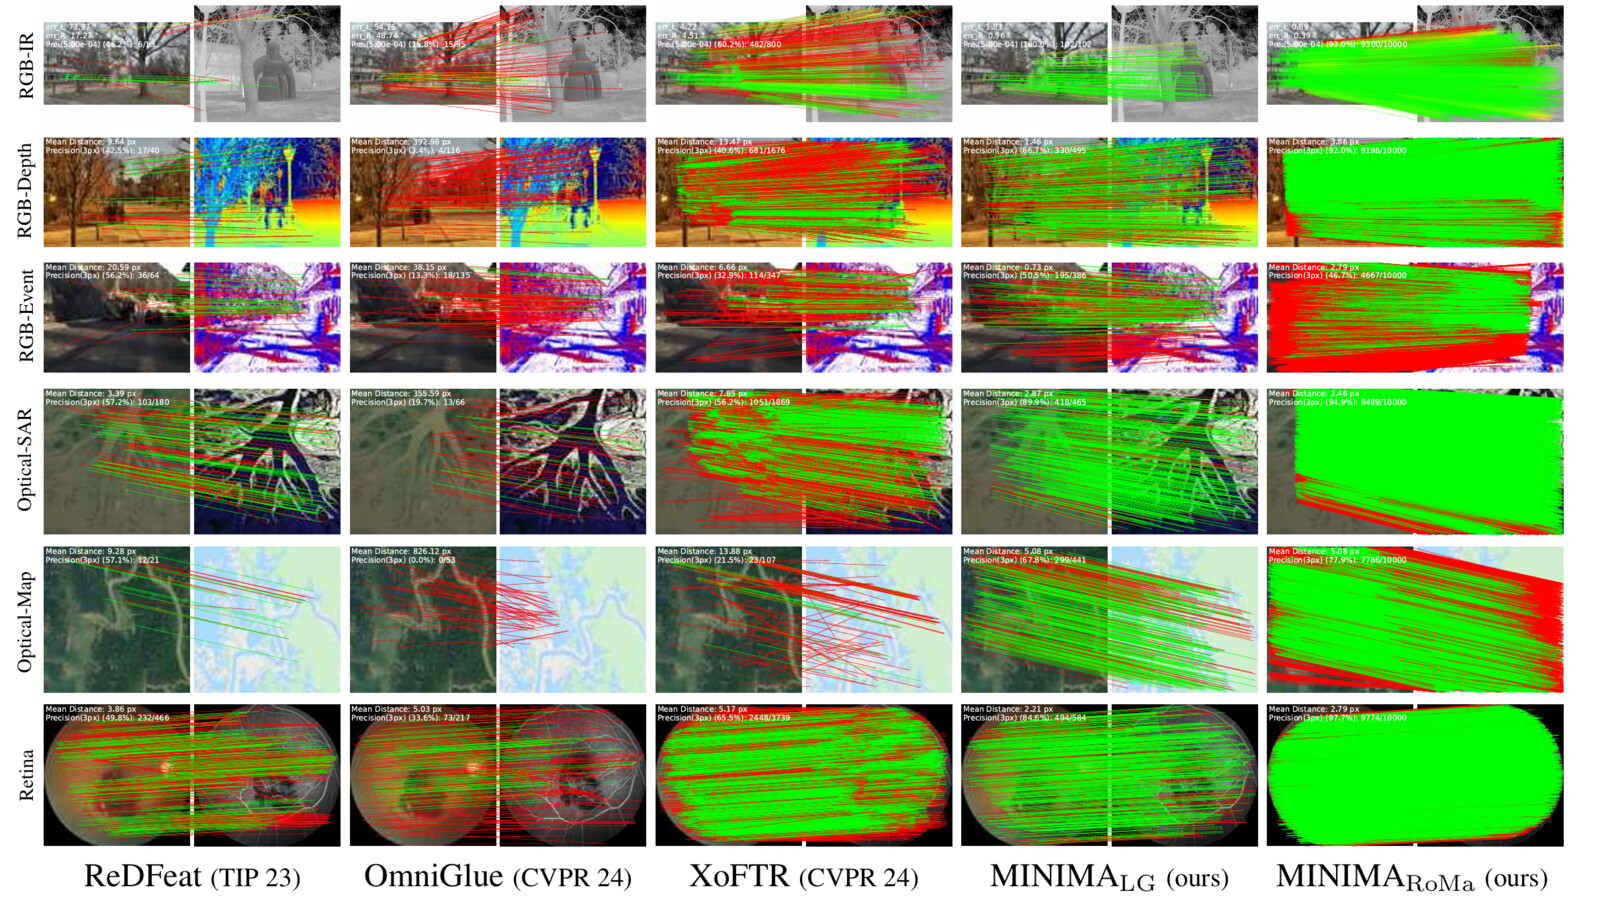
图 8 里最值得注意的是“稠密 vs 稀疏”的差异:MINIMA-RoMa 在每个模态上都能给出成千上万个对应点,绿色线条覆盖了建筑、道路、树木、血管等结构;MINIMA-LG 只给 2048 个关键点的匹配,数量少,但在纹理清晰的区域正确率很高。这不是说稠密一定更好:稠密匹配的离群点也更密集,RANSAC 的压力更大;但在跨模态这种“纹理可能消失”的场景里,稠密对应提供的冗余确实能救回一些稀疏检测器漏掉的结构。
四、局限性
4.1 论文承认的两点
论文在第 5.6 节列了两条可能的局限:
- 真实模态与伪模态之间的差距:生成图再像,也不是真实传感器输出;热成像的物理特性、事件的噪声模型、深度的传感器误差都没有被精确建模。
- 生成过程中的虚假信息:扩散模型可能“编”出原图没有的结构,深度/法向模型也可能在弱纹理处产生平滑的错误。
论文的回应是:多模态图像本来就在像素强度分布上差异巨大(图 5),这种差异正是训练通用匹配器所需要的;虚假信息可以看作一种数据增强,例如“红外里可见、RGB 里不可见”的目标,反而能提高鲁棒性。这个论证有道理,但它更多是“不会更糟”的定性辩护,缺少对虚假信息数量和影响的定量分析。
4.2 我自己再补几条
第一,模态覆盖被标题高估了。 论文的标题是“Modality Invariant”,结论说“for any cross-modal cases”,但数据引擎实际只生成 IR、Depth、Normal、Event、Paint、Sketch 六种;医学和遥感是零样本评测,不是生成/训练模态。SAR、CT/PET/SPECT、光学地图这些模态没有被合成,也没有被训练。零样本结果里医学基本饱和、事件绝对值很低,说明“任意模态”目前还是一个外推,而不是已验证的结论。
第二,场景覆盖仍然是 196 个户外场景。 480M 对来自 MegaDepth 的 196 个室外场景,数据引擎没有专门采集室内、驾驶或夜间数据(Aachen 只用于定位评测)。真实部署如果在室内、医学、遥感,几何结构和光照都不同;论文的零样本结果只能说明“有一定迁移”,不能说明“可以直接用”。
第三,480M 的“规模”要打折看。 它是 40M × 6 × 2 的配对数,同一个 RGB 对的 12 个变体共享几何,相关性极高;独立场景数没有变,独立图像数也远小于 480M。数据引擎扩的是模态,不是场景。存储 129 GB、红外生成 210k 步扩散、训练 4×3090,这些成本也不低;“cheap”是相对于“野外采集多传感器数据”而言的,不是零成本。
第四,模型相关性被正文轻描淡写。 MINIMA-LoFTR 在 MegaDepth-1500 上从 53.6 崩到 29.9,这不是小回退,而是灾难性遗忘。论文正文只说“except for LoFTR”,没有解释原因,也没有给缓解方案。实践上,如果你既要做跨模态又要保留 RGB 性能,应该优先选 RoMa 或 LightGlue,而不是 LoFTR。
第五,事件模拟器的像素偏移没有被量化。 代码用 1–3 px 的随机位移计算亮度差,所以伪事件图与 RGB 不是严格逐像素对齐;论文把它当作“轻微运动”,但没有说明这对标签继承和多模态配准的影响。对于 640 分辨率、3 px 的误差大约相当于 0.5% 的图像宽度,可能不大,但在高精度匹配里不能忽略。
第六,评测的统计强度有限。 METU-VisTIR 只有 2590 对、6 个场景;DSEC 只选了 3 个序列、100 对;医学/遥感是 MMIM 的小规模 case;论文没有报告多次运行的方差或置信区间。AUC 小数点后两位的差异,很多可能在噪声范围内。特别是医学,作者自己也说“数据集要么太简单要么太难”。
第七,基线停留在 2024 年。 论文没有和 MASt3R、UFM、RoMa v2 这些更新的匹配器比较;当然,这些工作有的是同期或后续,不能强求。但如果今天要选型,应该把 MINIMA 的微调 recipe 应用到更新的底座上,而不是只看论文里的 LoFTR/RoMa 数字。
第八,许可需要逐个确认。 代码仓库是 Apache-2.0,但 MINIMA_LG 使用的 SuperPoint 是“学术/非商业”限制性许可;MD-syn 在 Hugging Face 上标的是 Apache-2.0,但它由 MegaDepth 图像生成,MegaDepth 原始数据的条款可能仍然适用;METU-VisTIR、DIODE、DSEC、MMIM 也各有自己的许可。商用前要逐项确认,不能只看仓库根目录的 LICENSE。
五、结论与展望
MINIMA 的故事线很清楚:当网络架构已经足够好时,数据是更便宜的杠杆。 它没有提出新的注意力、新的损失或新的匹配头,而是把“模态”当成一种可以生成的数据增强:保留 RGB 的几何和标签,用生成模型替换外观,再用这些配对去微调现成的匹配器。这个思路的可迁移性很强——任何有 RGB 匹配数据、又有目标模态生成器的场景,都可以套用。
给实践者的几条建议:
- 先试微调,不要从零训练。 论文的曲线和消融都说明,RGB 预训练 + 小学习率微调 > 从零训练;从零训练需要更多数据、更多迭代,还不一定更好。
- 底座选择比模态选择更重要。 RoMa 在跨模态和 RGB-only 上都稳;LightGlue 快、代价小;LoFTR 在 RGB-only 上会崩,除非你确定不需要保留 RGB 能力,否则不要选。
- 合成数据是“预训练/冷启动”,不是“真实数据替代品”。 先在合成数据上微调,再用少量真实目标模态数据做验证/二阶段微调,通常比只用合成数据稳。
- 不要相信“任意模态”。 先确认你的目标模态是否在生成器覆盖范围内;如果不在(SAR、医学、事件),零样本结果只能作为参考,必须用真实数据验证。
- 算清数据账。 480M 对不是 480M 个独立样本;存储、生成、训练都有成本。如果目标只是某一个模态,生成一种模态(2×40M=80M 对)可能就够了,不必上全部六种。
未来的方向也很自然:更物理的生成器(SAR、医学、事件噪声模型)、几何一致的生成(深度/法向/事件与 RGB 的像素级一致性)、更强的底座(MASt3R/UFM/RoMa v2)、以及把“模态不变性”从数据分布变成显式的训练信号。如果这些方向能补齐,MINIMA 的“数据引擎”就不只是一种工程 trick,而会成为跨模态匹配的标准基础设施。
六、上手
官方仓库提供了完整的数据引擎、训练代码、评测脚本和五个模型的权重。下面只列最小可用路径;更细的说明见 data_engine/README.md 和 train_orders/README.md。
6.1 安装
README 的 clone 命令少了一个 clone(原文是 git https://github.com/LSXI7/MINIMA.git),照抄会报错;下面补上。RoMa 子模块还需要一行 typing.Tuple 的兼容补丁,这是 README 明确要求的。
安装命令(Python 3.8 + CUDA 11.7)
git clone https://github.com/LSXI7/MINIMA.git
cd MINIMA
conda env create -f environment.yaml
conda activate minima

git submodule update --init --recursive
git submodule update --recursive --remote
sed -i '1s/^/from typing import Tuple as tuple\n/' third_party/RoMa_minima/romatch/models/model_zoo/__init__.py
下载权重(五个模型,放到 weights/)
bash weights/download.sh6.2 最小示例
demo.py 接收两张图,用 --method 选择 sp_lg、loftr、roma 等,输出匹配可视化。
单对图像推理
python demo.py --method sp_lg --fig1 demo/vis_test.png --fig2 demo/depth_test.png --save_dir ./demo参数和论文概念的对应:--method sp_lg 对应 MINIMA-LG(SuperPoint + LightGlue),loftr 对应 MINIMA-LoFTR,roma 对应 MINIMA-RoMa;--ckpt 可以换自定义权重,默认从 weights/ 读取。输入图像不需要预先对齐,demo 会做缩放和预处理;如果要复现论文的跨模态评测,应该用下面的评测脚本,而不是 demo。
6.3 评测
真实数据和 MD-syn 的评测脚本是分开的。METU-VisTIR 用位姿指标,DIODE/事件/MMIM 用单应指标,MD-syn 用位姿指标。--method 可取 sp_lg、loftr、roma、xoftr(最后一个是 XoFTR 基线);--ckpt 不填时用 load_model.py 里的默认权重路径(如 ./weights/minima_lightglue.pth),MMIM 的 --choose_model 0/1 对应医学/遥感。
真实跨模态评测(RGB-IR / Depth / Event / MMIM)
python test_relative_pose_infrared.py --method <method> --ckpt <model_path> --save_figs --save_dir <save_dir>
python test_relative_homo_depth.py    --method <method> --ckpt <model_path> --save_figs --save_dir <save_dir>
python test_relative_homo_event.py    --method <method> --ckpt <model_path> --save_figs --save_dir <save_dir>
python test_relative_homo_mmim.py     --method <method> --ckpt <model_path> --choose_model 0/1 --save_figs --save_dir <save_dir>
MD-syn 与原始 MegaDepth-1500 评测
python test_relative_pose_mega_1500_syn.py --method <method> --ckpt <ckpt> --multi_model <modality>
python test_relative_pose_mega_1500.py     --method <method> --ckpt <model_path>
# --multi_model 可选:infrared, depth, event, normal, sketch, paint数据准备的关键是目录结构:data/METU-VisTIR/、data/DIODE/val/、data/DSEC/、data/Multi-modality-image-matching-database-metrics-methods/,以及 data/megadepth/train/[modality]/Undistorted_SfM/ 和 data/megadepth/test/Undistorted_SfM/。MegaDepth-1500 需要原版测试集,MD-syn 的伪模态从 OpenXLab 或 Hugging Face 下载;两个来源都提供了完整脚本。
6.4 训练
训练代码按三个底座分开维护,环境和索引格式各不相同。以 LightGlue 为例:先准备 MegaDepth 的 scene_info 索引,再把 data/megadepth/train/* 软链到 third_party/glue_factory_minima/data/megadepth/,最后跑脚本。
LightGlue 版训练(索引 + 软链 + 启动)
# 索引
tar xf scene_info.tar.gz -C ./third_party/glue_factory_minima/data/megadepth/
python train_orders/lightglue_index_preparation.py

# 软链(路径按你的数据位置改)
ln -s /path/to/MINIMA/data/megadepth/train/* ./third_party/glue_factory_minima/data/megadepth/

# 训练
bash train_orders/minima_lightglue.sh
LoFTR 和 RoMa 的流程类似,但索引文件不同:LoFTR 用 Google Drive 上的 megadepth_indices.tar,RoMA 用 prep_scene_info.tar。README 里 RoMA 的索引脚本写成了 train_order/roma_index_preparation.py(少了一个 s),实际文件是 train_orders/roma_index_preparation.py。
LoFTR / RoMA 版训练(命令汇总)
# LoFTR
tar xf megadepth_indices.tar -C tmp_unpack
mv tmp_unpack/megadepth_indices/* ./third_party/LoFTR_minima/data/megadepth/
python train_orders/loftr_index_preparation.py
bash train_orders/minima_loftr.sh

# RoMA
tar xf prep_scene_info.tar -C ./third_party/roma_minima/data/megadepth/
python train_orders/roma_index_preparation.py
bash train_orders/minima_roma.sh
6.5 权重协议与许可
- 权重:
minima_lightglue.pth、minima_loftr.ckpt、minima_roma.pth、minima_eloftr.ckpt、minima_xoftr.ckpt,可从 Google Drive 或 GitHub Releases 下载,weights/download.sh会自动拉取。 - 代码:Apache-2.0。
- SuperPoint:
MINIMA_LG用它做关键点检测,SuperPoint 的许可只允许学术/非商业用途;商用要替换检测器或单独谈许可。 - 数据集:MD-syn 在 Hugging Face 上标 Apache-2.0、约 129 GB、4,836 行;但它由 MegaDepth 图像生成,MegaDepth 原始条款、以及 METU-VisTIR/DIODE/DSEC/MMIM 的条款都需要单独确认。
参考
- Ren, Jiang, Li, Liang, Zhou, Bai. MINIMA: Modality Invariant Image Matching. CVPR 2025, pp. 23059–23068. arXiv · 代码
- Li, Hu, Ai. RIFT: Multi-Modal Image Matching Based on Radiation-Variation Insensitive Feature Transform. IEEE Transactions on Image Processing, 29:3296–3310, 2020. DOI
- Deng, Ma. ReDFeat: Recoupling Detection and Description for Multimodal Feature Learning. IEEE Transactions on Image Processing, 2023. arXiv
- Tuzcuoğlu, Köksal, Sofu, Kalkan, Alatan. XoFTR: Cross-modal Feature Matching Transformer. CVPR Workshops 2024. arXiv · 代码
- Li, Snavely. MegaDepth: Learning Single-View Depth Prediction from Internet Photos. CVPR 2018. arXiv · 代码
- Dai, Chang, Savva, Halber, Funkhouser, Nießner. ScanNet: Richly-Annotated 3D Reconstructions of Indoor Scenes. CVPR 2017. arXiv · 代码
- Sarlin, DeTone, Malisiewicz, Rabinovich. SuperGlue: Learning Feature Matching with Graph Neural Networks. CVPR 2020. arXiv · 代码
- Lindenberger, Sarlin, Pollefeys. LightGlue: Local Feature Matching at Light Speed. ICCV 2023. arXiv · 代码
- Sun, Shen, Wang, Bao, Zhou. LoFTR: Detector-Free Local Feature Matching with Transformers. CVPR 2021. arXiv · 代码
- Edstedt, Athanasiadis, Wadenbäck, Felsberg. DKM: Dense Kernelized Feature Matching for Geometry Estimation. CVPR 2023. arXiv · 代码
- Edstedt, Sun, Bökman, Wadenbäck, Felsberg. RoMa: Robust Dense Feature Matching. CVPR 2024. arXiv · 代码
- Han, Mao, Jiang, Pan, Zhang. StyleBooth: Image Style Editing with Multimodal Instruction. ICCV Workshops 2025. arXiv
- Hu, Shen, Wallis, Allen-Zhu, Li, Wang, Wang, Chen. LoRA: Low-Rank Adaptation of Large Language Models. ICLR 2022. arXiv · 代码
- Yang, Kang, Huang, Zhao, Xu, Feng, Zhao. Depth Anything V2. NeurIPS 2024. arXiv · 代码
- Bae, Davison. Rethinking Inductive Biases for Surface Normal Estimation. CVPR 2024. arXiv · 代码
- Liu, Lin, He, Li, Deng, Li, Ding, Wang. Paint Transformer: Feed Forward Neural Painting with Stroke Prediction. ICCV 2021. arXiv · 代码
- Xiang, Liu, Yang, Zhu, Shen, Allebach. Anime2Sketch: A Sketch Extractor for Anime Arts with Deep Networks. GitHub project, 2021. 代码
- Jia, Zhu, Li, Tang, Liu, Zhou. LLVIP: A Visible-Infrared Paired Dataset for Low-Light Vision. ICCV Workshops 2021. arXiv · 代码
- Liu, Fan, Huang, Wu, Liu, Zhong, Luo. Target-Aware Dual Adversarial Learning and a Multi-Scenario Multi-Modality Benchmark to Fuse Infrared and Visible for Object Detection. CVPR 2022. arXiv · 代码
- Wang, Liu, Fan, Liu. Unsupervised Misaligned Infrared and Visible Image Fusion via Cross-Modality Image Generation and Registration. IJCAI 2022, pp. 3508–3515. arXiv · 代码
- Vasiljevic, Kolkin, Zhang, Luo, Wang, Dai, Daniele, Mostajabi, Basart, Walter, Shakhnarovich. DIODE: A Dense Indoor and Outdoor DEpth Dataset. arXiv 2019. arXiv
- Gehrig, Aarents, Gehrig, Scaramuzza. DSEC: A Stereo Event Camera Dataset for Driving Scenarios. IEEE Robotics and Automation Letters, 2021. arXiv · 代码
- Jiang, Ma, Xiao, Shao, Guo. A Review of Multimodal Image Matching: Methods and Applications. Information Fusion, 73:22–71, 2021. DOI
- Jiang, Karpur, Cao, Huang, Araujo. OmniGlue: Generalizable Feature Matching with Foundation Model Guidance. CVPR 2024. arXiv · 代码
- Shen, Cai, Yin, Müller, Li, Wang, Chen, Wang. GIM: Learning Generalizable Image Matcher From Internet Videos. ICLR 2024. arXiv · 代码
- Wang, He, Peng, Tan, Zhou. Efficient LoFTR: Semi-Dense Local Feature Matching with Sparse-Like Speed. CVPR 2024. arXiv · 代码
- DeTone, Malisiewicz, Rabinovich. SuperPoint: Self-Supervised Interest Point Detection and Description. CVPR Workshops 2018. arXiv · 代码
- Sattler, Maddern, Toft, Torii, Hammarstrand, Stenborg, Safari, Okutomi, Pollefeys, Sivic, Kahl, Pajdla. Benchmarking 6DOF Outdoor Visual Localization in Changing Conditions. CVPR 2018, pp. 8601–8610. CVF