· 97 min read
论文解读:OpenWAM,世界-动作模型预训练的设计空间与开源配方
TL;DR OpenWAM 是一套「研究栈」而不是单个模型[1]:它把世界-动作模型(World-Action Model,WAM)从生成骨干、视觉表征、架构、跨模态信息流、推理调度到数据配比,全部拆成可组合、可替换的模块,用控制变量法在 RoboTwin2.0 上回答三个问题——该继承什么世界知识、世界与动作怎么协同、协同怎么跨域扩展。三条结论分别是:足够强的视频生成骨干加上紧凑而信息丰富的 latent 最有效;协同需要专门的 action 容量、训练时显式的 world→action 信息流、以及推理时的同步联合去噪;具身预训练主要涨的是分布外(OOD)泛化,人类第一视角视频拓宽视觉覆盖、机器人轨迹提供可执行的动作锚定,一阶段 co-train 最省事。按这个配方预训练的 OpenWAM-α 用了 518.5M 帧(约 6,369 小时)人类自我中心视频和机器人数据,在 8 个仿真基准、5 类本体上整体处于第一梯队:LIBERO 99.3、EBench 49.4(比第二名高约 4 分)、RoboTwin2.0-Full 93.60,真机单臂平均成功率 82.5%、RoboDojo 真机榜第一、没见过的灵巧手平台上也全面超过 π0.5。代码 Apache-2.0 开源,权重与清洗后的机器人数据都在 Hugging Face 上。
- 论文:OpenWAM: An Open, Modular Exploration Towards Systematic World-Action Model Pretraining,Yuran Wang、Siqiao Huang、Mingleyang Li 等,NUS / 清华 / 北大 / 港大 / 浙大 / 港中文 / 上交,2026 年 9 月 7 日。
- 代码:github.com/OpenWAM-Official/OpenWAM,Apache-2.0;权重和清洗后的机器人数据在 huggingface.co/OpenWAM;项目页。
- 前作 / 预备知识:本文假定读者知道 Transformer、扩散 / 流匹配(flow matching)和 VLA 的基本概念。站内可以先看 Transformer 交互解读;VLA 一侧的代表作是 π0 / π0.5[2, 3]。
一、动机:WAM 的承诺,被「单体系统」挡住了
「知是行之始,行是知之成。」论文开篇引了王阳明。放在具身智能的语境里,这句话说的是一种数据上的不对称:描述世界如何变化的视频遍地都是,带有可执行动作标签的机器人轨迹却很稀缺。ACT、Diffusion Policy 这类方法只在机器人演示里同时学视觉规律和控制[4];VLA 模型(RT-2、OpenVLA、π0)从预训练的视觉-语言模型里继承语义和语言知识[5, 6, 2];WAM 走的则是第三条路:从视频生成预训练里继承关于视觉动力学的生成先验,再用具身经验把它改造成能输出动作的策略[7, 8]。
WAM 的核心假设并不是「给视频模型接一个 action head」,而是世界预测和动作生成可以互相成就:世界建模提供关于状态、动力学和可能未来的结构化知识来指导动作,动作学习反过来把模型注意力聚焦到对控制真正重要的变化上。问题在于,这个假设在现有系统里很难被验证。理由是单体(monolithic):生成骨干、视觉表征、模型架构、信息流、推理过程和训练数据配比被绑死在一起,改一个地方,其他地方的效应会混进来,于是没人说得清「到底是哪个设计在起作用、为什么起作用」。
论文因此提出三个问题:
- Q1:WAM 应该继承什么世界知识,怎么继承?
- Q2:继承来的世界知识和动作学习如何产生协同?
- Q3:这种协同如何跨域、跨本体地扩展?
对应地,论文的贡献也是三件套:
- OpenWAM-Infra:把 WAM 拆成可组合模块(视觉编码器、流骨干、可见性注意力掩码),配一套训练、部署和评测基础设施,让「换一个设计变量」变成改一行配置;
- OpenWAM-Study:在这套基础设施上做受控实验,回答 Q1–Q3,得到一份可带走的预训练配方;
- OpenWAM-α:把配方放大到 518.5M 帧人类与机器人数据上,验证它在仿真和真机上是否依然成立。
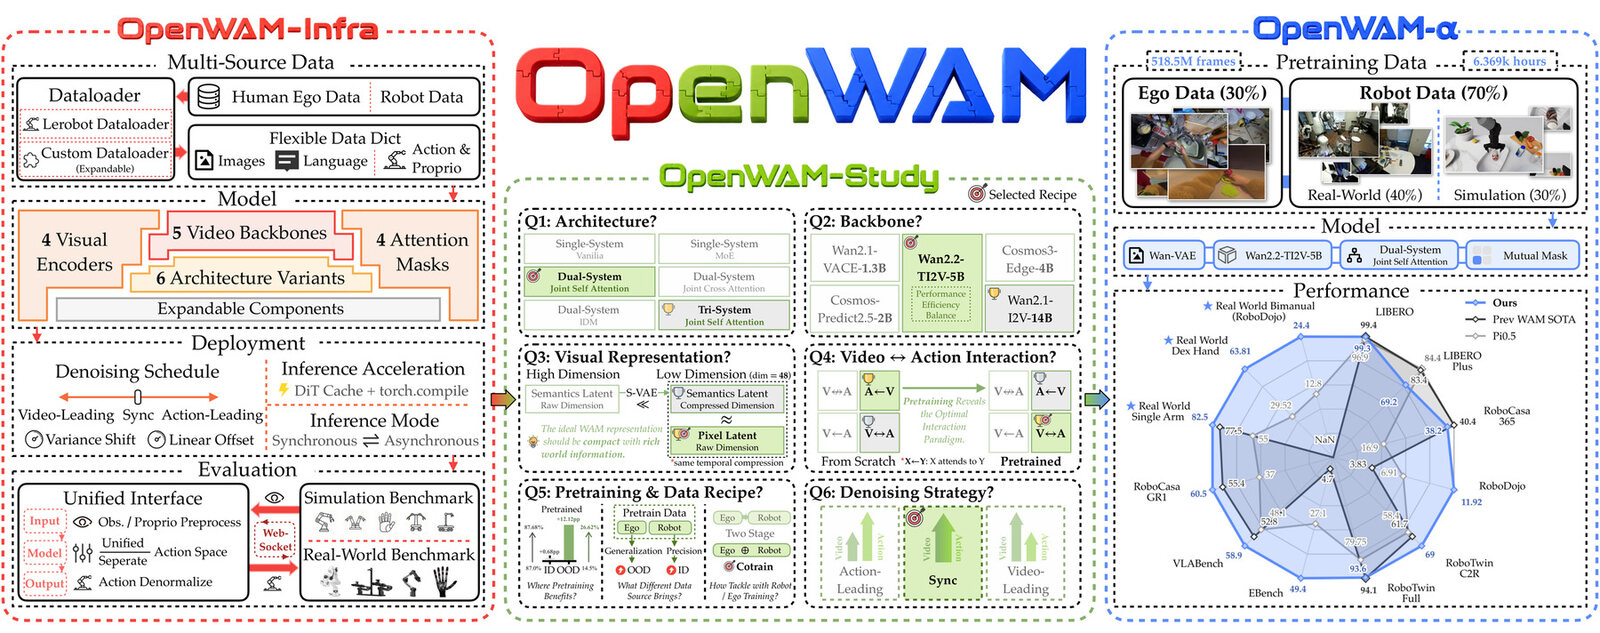
读这篇论文要调整一下预期:它更像一份实验报告而不是一篇方法论文。方法本身(dual-system + 联合流匹配 + 统一动作空间)在 2026 年的 WAM 文献里不算惊世骇俗,真正有价值的是「怎么把设计空间拆开、每个变量单独测、最后把结论组合起来」这套方法论。
二、核心方法
2.1 OpenWAM-Infra:把 WAM 写成
OpenWAM-Infra 的第一个观察是:现有的 WAM 实现虽然都叫「视频生成模型 + 动作生成」,但模块边界千差万别,导致代码难以复用,也让不同论文的结论互相不可比。它给出的抽象是把一个 WAM 写成三元组
其中 是组合规则, 是视觉编码器, 是流骨干, 是可见性注意力掩码。组合规则本身不含参数,所有学到的容量都在骨干里——这一点是后面「控制变量」能成立的前提。
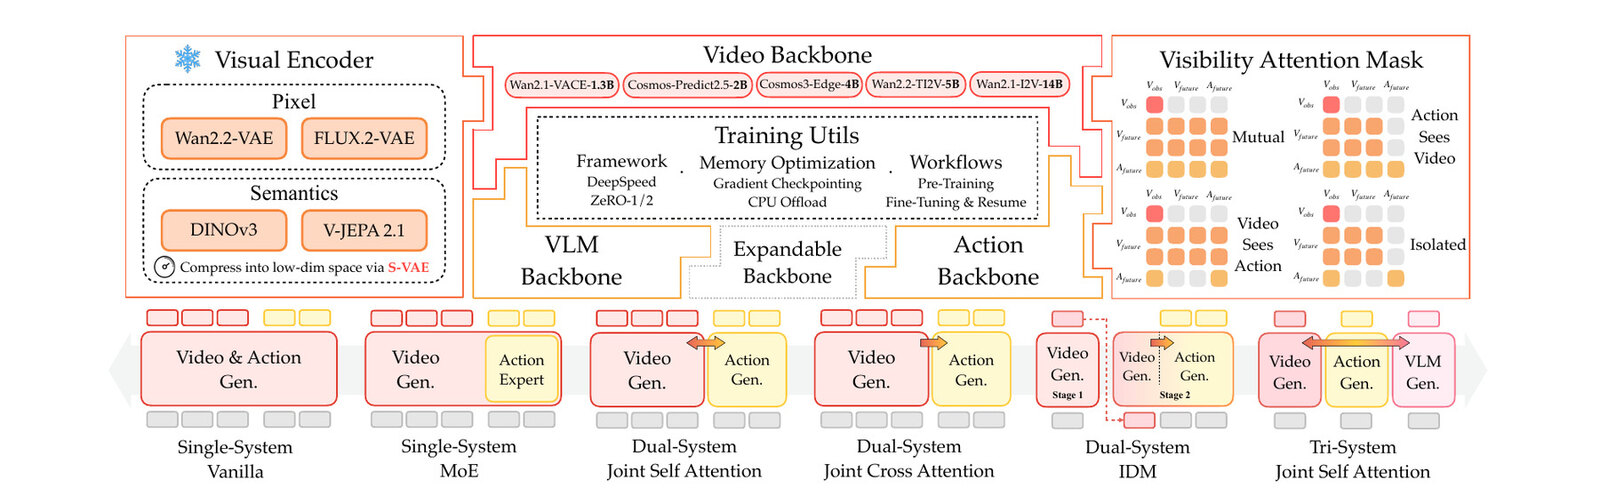
视觉编码器 。它把观测映射成 world stream 要预测的 latent 序列,训练全程冻结。Infra 提供两类:重建类(Wan2.2-VAE、FLUX.2-VAE)和表征类(DINOv3、V-JEPA 2.1),后者还可以接一个 S-VAE 把高维特征压到 48 维[9, 10, 11]。默认情况下编码器与视频骨干原生匹配,直接复用预训练 DiT 的权重;换编码器时也可以重新初始化 DiT[12],以排除预训练参数的干扰。
流骨干 。world stream 预测未来视觉状态,action stream 预测动作 chunk[4],可选的 VLM stream 提供语义理解。视频骨干支持 5 个预训练模型:Wan2.1-VACE-1.3B、Cosmos-Predict2.5-2B、Cosmos3-Edge-4B、Wan2.2-TI2V-5B、Wan2.1-I2V-14B[13, 14];VLM 骨干只支持 Qwen3-VL 系列[15];action 骨干可以是一套独立的 ActionDiT 参数,也可以与视频骨干共享。
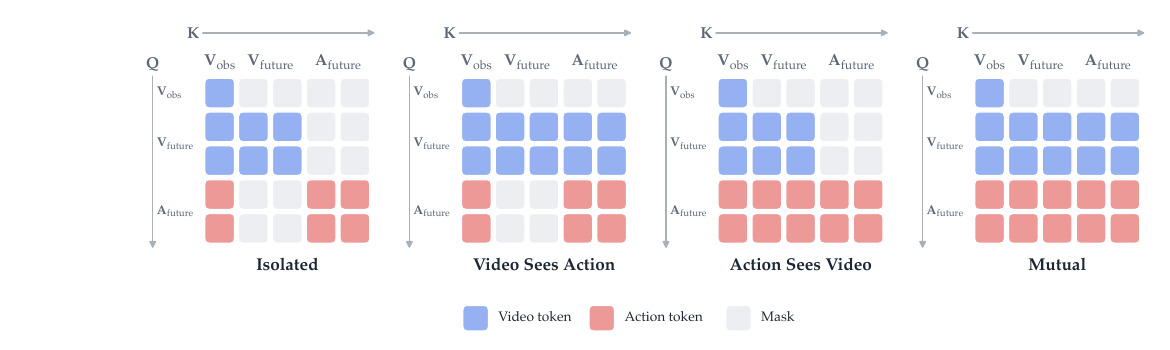
可见性注意力掩码 。它控制流与流之间、token 与 token 之间谁能看谁。在视频和动作两个模态上,掩码分解成四个块:
两个模态内块是固定的:视频采用「首帧因果」注意力,带噪帧可以看彼此和干净的首帧,而干净首帧只看得见自己,从而保护条件帧不被噪声污染;动作 chunk 内部用双向注意力,让同一 chunk 里的动作互相约束。两个跨模态块组合出四种模式,也就是后面 Q2 要比较的四个变量:mutual(互相可见)、action-sees-video(动作看世界)、video-sees-action(世界看动作)、isolated(互不可见)。
在这三个模块类之上, 把骨干的 prepare → 逐层 block → finalize 串起来,需要跨流交互时把 block 拆成注意力前后两半、替换注意力计算本身,而不改骨干内部。由此组合出 6 种架构变体、3 个家族:
- 单系统(Single-System):只有一个视频骨干,动作 token 直接拼进视频序列,大部分参数共享。Vanilla 不做模态区分;MoE 把动作 token 硬路由到专门的 FFN 专家,加一点模态专属容量但仍不拆流。代表系统是 Cosmos Policy、DreamZero[8]。
- 双系统(Dual-System):视频骨干和独立的 ActionDiT 各有一套参数,通过注意力桥接。Joint self-attention 在桥接层把两路 hidden state 合成一条联合序列,做 token 级双向交互;Joint cross-attention 让动作流通过 cross-attention 查询视频特征(可以端到端回传梯度,也可以在视频特征处 detach);IDM 把动作模块当成以视频特征为条件的逆动力学模型,先出视频轨迹再出动作,推理分两阶段。代表系统是 Fast-WAM、LingBot-VA[16, 17]。
- 三系统(Tri-System):在双系统基础上加一个冻结的 VLM 骨干和一条可训练的 understanding stream,三路 token 一起做联合自注意力;understanding stream 是只读的尾巴,别人能看它、它只看自己。代表系统是 Motus。
训练运行时。所有架构共用一个 trainer、一套样本契约、一个联合流匹配(flow matching)目标[18]。一个样本是 :语言指令、视频窗口、动作 chunk、可选的本体状态、逐维有效性掩码。编码器把观测编码成 latent ,语言(和本体状态)变成上下文 。两路分别加噪到各自的时间步 ,得到插值 、( 纯噪声, 干净数据),一次联合前向同时预测两路速度,损失是
其中 是时间步加权, 把动作项限制在本体真正占用的维度上。关键设计是 和 独立采样:训练覆盖整个 噪声平面,于是任何推理调度(同步去噪,或者一路领先的异步去噪)都落在这张平面的某条路径上,都属于训练分布内。这个设计在后面 Q2 的推理调度实验里会反复出现。
训练工具层提供 DeepSpeed ZeRO(stage 1/2)、bf16、梯度累积、梯度检查点、CPU offload,以及预训练 / 微调 / 精确恢复三种工作流。自包含 checkpoint 是另一个容易被忽略但很实用的设计:每个 checkpoint 包含权重、完全解析的配置(含每个模块的重建规格和 tokenizer 等产物)以及动作归一化统计。微调、恢复和部署都从这份记录重建架构再加载参数;部署时缺归一化统计是硬错误。这样评测就不会悄悄换掉编码器、动作布局或者数值尺度。
部署运行时。一个策略服务器服务所有 checkpoint,把「什么时候推理」和「两路怎么去噪」这两个选择正交开。
- 推理模式:同步推理(synchronous)在动作缓冲区空了就阻塞等下一次推理,执行会停顿;异步推理(asynchronous)设 chunk 长度 、推理视野 、提前量 (默认 ),缓冲区只剩 个动作时后台预取下一个 chunk,新 chunk 依次切成「已执行过的延迟前缀」「接下来 个动作的执行窗口」「被丢弃的尾巴」。两种模式对客户端不可区分:每次请求都是「一个观测进、一个动作出」。
- 去噪调度:同步调度沿对角线走,每一步一次联合前向加耦合 Euler 更新;异步调度让一路领先,用两组可组合的曲线:
其中 是全局进度。方差平移 把领先的那一路抬到对角线之上(),让它更早到达干净数据;线性偏移 把落后的一路按在纯噪声上,直到进度超过 。领先的是 world stream 还是 action stream,就得到 video-lead 和 action-lead 两种模式; 精确退化为同步对角线——也就是说同步只是异步的特例,而不是另一条代码路径。
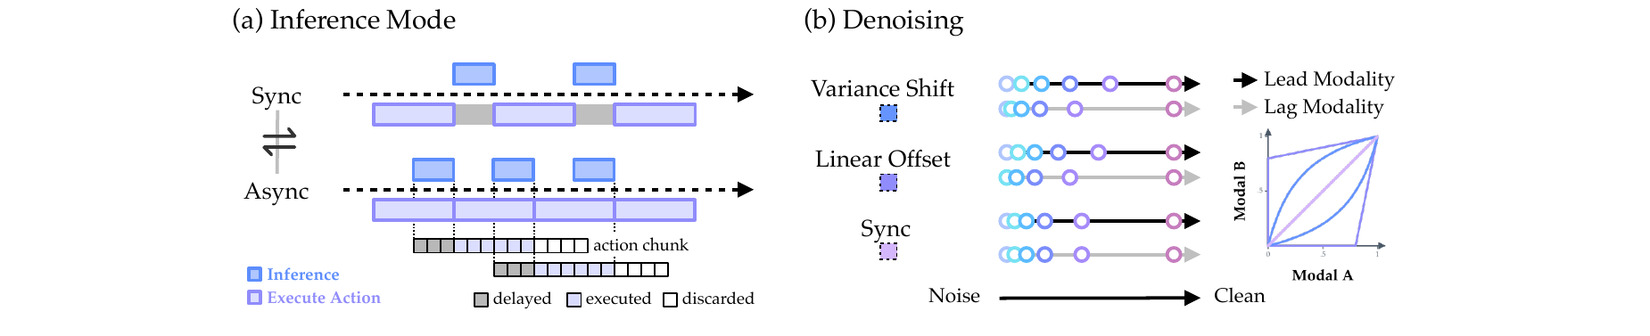
加速方面有四个可独立开关的组件:prompt embedding 缓存、视频解码跳过(控制只用动作,不需要像素)、torch.compile + CUDA graph 的固定形状图、以及 DiT velocity cache(最近几步两路速度的余弦相似度足够稳定时跳过一次联合前向,有连续跳步上限)。以 Wan2.2-TI2V-5B 为视频骨干,不同架构在 RTX 5090 上的 chunk 推理延迟是 149 到 251 ms,加速 2.0 到 3.6 倍(论文图 4)。α 的部署里 N=10 步去噪约 170 ms 一个 chunk。
评测协议。所有基准都作为瘦客户端通过一条持久 WebSocket 连到策略服务器:客户端发 (最多三路相机,头相机必选、腕相机可选;语言指令;可选原始机器人状态),服务器做图像裁剪 / 缩放 / 拼成训练时的 canonical 布局、缺相机填黑帧、归一化本体状态并映射到模型侧动作表示,推理得到动作 chunk 后再反归一化回原生物理单位。归一化值永远到不了机器人,重置请求清掉每个 episode 的执行器状态。八个仿真基准(LIBERO、LIBERO-Plus、VLABench、RoboTwin2.0、RoboDojo、RoboCasa365、RoboCasa-GR1、EBench)[19, 20, 21, 22, 23, 24, 25, 26] 都是通过这套接口接入的,真机平台也一样;换一个基准只需要写一个 adapter,模型和两个运行时都不用动。
80 维统一动作空间。单基准训练时用各基准的原生动作空间最省事(例如 LIBERO 是 10 维末端执行器空间,RoboTwin2.0 是 14 维关节空间或 20 维双臂末端执行器空间)。但要一个模型跨本体训练,就必须把所有本体映射到同一个动作头。OpenWAM 定义
结构是两个镜像的 34 维手臂块 + 12 个保留槽:每个手臂块含末端位置(3)、6D 旋转(6)、夹爪(1)、灵巧手(24);保留槽给移动底座等本体专属通道。槽位语义固定,所以不同本体共享的结构会落在相同的坐标上;每个数据集声明自己的索引映射 ,归一化在 scatter 前做、在 gather 后逆操作,本体状态也沿同一张映射表走。损失里的有效性掩码 恰好标出被映射到的槽位,没映射到的坐标训练时没有梯度、推理时停在解析噪声路径上。
下面这个部件把 80 个槽位画出来。点不同本体,看哪些维度被激活、哪些被 mask 掉:
这个设计最直接的好处是一个动作头服务所有本体,不同宽度的动作空间在同一组坐标上共享语义;代价是每个数据集都要写一张映射表,而且「没激活的坐标在推理时停在解析噪声路径上」意味着模型必须学会区分「这里是 0」和「这里不存在」。论文在表 4 里统计了 21 个机器人和人类本体,实际映射由各数据集声明,附录没有逐一列出所有 ,复现时要自己补。
2.3 Q1:继承什么世界知识?
世界知识有两条继承通道:生成式世界先验(视频生成骨干里关于视觉和动力学的知识)和视觉表征先验(视觉编码器诱导出的表示空间)。论文两条都测了。
2.3.1 生成式先验:骨干越大越好,但 5B 是性价比拐点
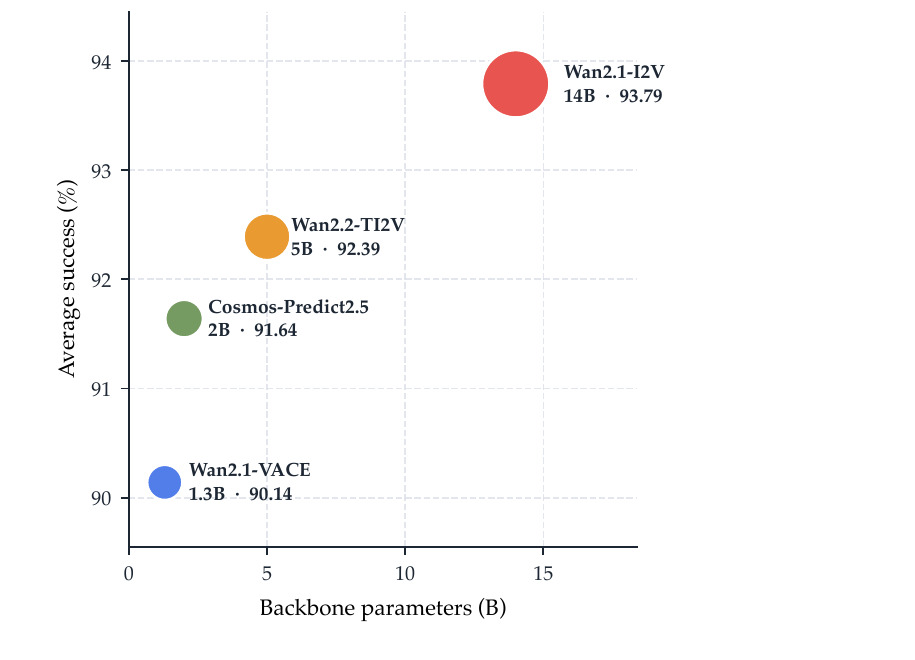
实验固定双系统架构(视频模块 + 动作模块,joint self-attention 桥接),只换视频生成骨干,在 RoboTwin2.0-Full 上评测。四个骨干的结果是:
| 视频生成骨干 | 参数量 | 平均成功率 |
|---|---|---|
| Wan2.1-VACE | 1.3B | 90.14 |
| Cosmos-Predict2.5 | 2B | 91.64 |
| Wan2.2-TI2V | 5B | 92.39 |
| Wan2.1-I2V | 14B | 93.79 |
性能随骨干容量单调上升,14B 最好,但 5B 只落后 1.40 分,参数量却只有前者的约 1/3。作者据此把 5B 作为后续所有受控实验的默认骨干——既能拿住大部分收益,又让动作侧的消融跑得起。需要强调这个比较不能直接读成「参数越多越好」:四个骨干在架构、预训练数据、训练目标上都不同,所以论文的结论只到「骨干选择是一个重要设计变量」,没有把增益全部归因于参数量。
2.3.2 视觉表征先验:重建 encoder 不是唯一答案
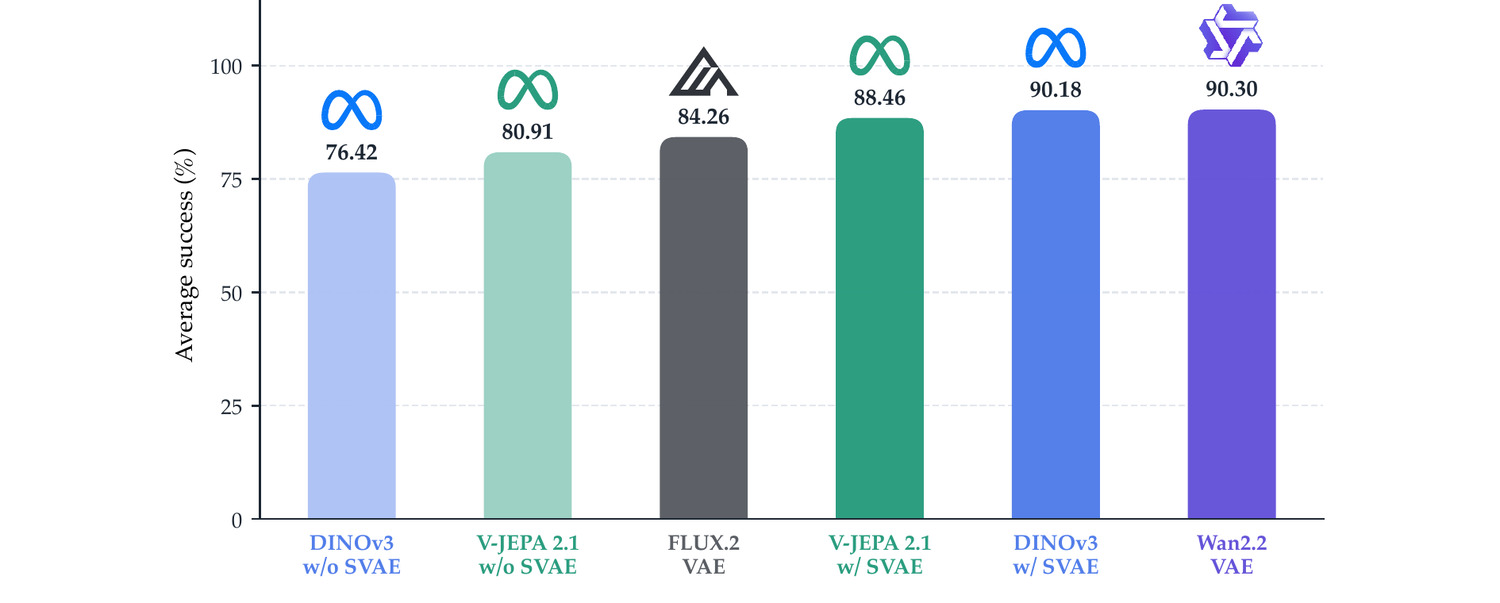
另一条通道是 latent 空间。编码器分两类:重建类(为像素重建训练,比如 Wan2.2-VAE 和 FLUX.2-VAE[27])与表征类(自监督或多模态表征学习,比如 DINOv3 和 V-JEPA 2.1)。为了只比较表征本身,这组实验固定 Wan2.2-TI2V-5B 的架构但随机初始化权重,把编码器换成候选,再给所有候选统一施加 4 倍时间压缩(把连续 4 帧特征平均)。
结果很有意思:
| 视觉编码器 | 维度 | 平均成功率 |
|---|---|---|
| DINOv3 w/o S-VAE | 768 | 76.42 |
| V-JEPA 2.1 w/o S-VAE | 1024 | 80.91 |
| FLUX.2-VAE | 48 | 84.26 |
| V-JEPA 2.1 w/ S-VAE | 48 | 88.46 |
| DINOv3 w/ S-VAE | 48 | 90.18 |
| Wan2.2-VAE | 48 | 90.30 |
直接拿表征 encoder 的高维 latent 喂 DiT 会明显变差(DINOv3 76.42、V-JEPA 80.91,都低于 FLUX.2-VAE 的 84.26):DiT 是为重建 encoder 的低维 latent 优化的,维度不匹配会让训练变难[11]。但加上 S-VAE 把特征压到 48 维之后,两个表征 encoder 反超 FLUX.2-VAE,DINOv3 甚至几乎追平 Wan2.2-VAE(90.18 对 90.30,差 0.12)。作者把剩下这点差距归因于 Wan2.2-VAE 的两个天然优势:它是为这个视频骨干配套的重建编码器,且时间压缩是编码器自己学出来的,而不是靠帧平均硬压。
发现 1:WAM 继承上游世界知识最有效的路径,是一个足够强的生成骨干 + 一个紧凑、信息量大的视觉 latent 空间。重建 encoder 不是唯一选择,表征 encoder 加上维度压缩同样能打。
这个结论的实践含义是:判断 latent 好坏的标准是「紧凑度 × 信息量」,而不是「重建 loss 低不低」。论文也顺手给了一个方向:如果表征 encoder 能原生做时间压缩,而不是靠帧平均,理论上还能再往上走。
2.4 Q2:世界与动作如何协同?
继承到好的先验只是起点。要产生协同,需要在三个层面做决策:动作专属容量放在哪、训练时允许哪些跨模态信息路径、以及推理时是否保持训练时的噪声状态关系。
2.4.1 架构容量:单系统差 7 分,三系统只多 0.24 分
作者把六个架构家族变体(joint cross-attention 再拆成端到端和 detach 两种)全部跑了一遍,结果非常干净:
| 家族 | 变体 | Clean | Randomized | 平均 |
|---|---|---|---|---|
| 单系统 | Vanilla | 85.20 | 85.80 | 85.50 |
| 单系统 | MoE | 86.22 | 83.04 | 84.63 |
| 双系统 | Joint Self-Attention | 92.34 | 92.38 | 92.36 |
| 双系统 | Joint Cross-Attention | 87.86 | 88.64 | 88.25 |
| 双系统 | Detached Cross-Attention | 92.06 | 91.64 | 91.85 |
| 双系统 | IDM | 87.76 | 88.14 | 87.95 |
| 三系统 | Joint Self-Attention | 92.84 | 92.36 | 92.60 |
两个现象值得注意。第一,单系统比双系统整体低约 7 分(85 对 92 量级):把动作 token 塞进视频序列共享注意力,和给动作单独一套参数再桥接,差别是实质性的。动作学习需要专门的容量,这和「动作分布比视觉分布窄得多、需要的表征粒度不同」的直觉一致。第二,双系统里桥接方式比容量更重要:joint self-attention(92.36)远好于 joint cross-attention(88.25),而 detach 掉视频特征的梯度后回到 91.85,几乎追平 joint self-attention——说明关节式注意力的收益主要来自「动作能读到视频特征」,而不是「动作梯度能改写视频骨干」。IDM 的两阶段形式(先出视频、再从视频推动作)只有 87.95,和 cross-attention 一个量级。
三系统的 92.60 是全场最高,但只比双系统 joint self-attention 高 0.24。作者因此选择双系统 joint self-attention 作为后续默认:一来把架构复杂度压住,二来把「VLM 语义理解特征」这个混杂因素隔离掉,让后续结论反映的是世界-动作交互本身。
2.4.2 训练时信息流:world→action 是刚需,反向是锦上添花
固定 joint self-attention,用注意力掩码控制跨模态信息流,四种模式的结果是:
| 掩码 | Clean | Randomized | 平均 |
|---|---|---|---|
| Isolated(互不可见) | 88.08 | 86.74 | 87.41 |
| Video Sees Action(世界看动作) | 87.92 | 87.34 | 87.63 |
| Action Sees Video(动作看世界) | 92.98 | 91.80 | 92.39 |
| Mutual(互相可见) | 92.50 | 91.80 | 92.15 |
结论按「动作流能不能看到世界特征」一刀切开:看不到的两种(isolated、video-sees-action)都在 87 分附近,比能看到低约 5 分;而 action-sees-video 和 mutual 都在 92 分以上。也就是说,世界→动作这条信息路径是必需项,动作→世界是可选加项——后者在从零训练时甚至让平均分掉了 0.24(92.15 对 92.39)。这个「从零训练时 mutual 略亏」的细节在后面 Q3 会翻转,是全文最值得记住的伏笔之一。
2.4.3 推理时信息流:同步去噪最好,异步不涨点
训练时用硬掩码控制信息流,推理时还可以用软门控:两路各自走到不同的噪声水平,等价于部分屏蔽。作者固定 mutual、独立采样两路噪声训练,然后测试第 2.1 节说的方差平移和线性偏移两类调度,两个领先方向各扫四个参数(,)。
结果有点反直觉:同步去噪(93.0)最好,没有任何异步调度能超过它。方差平移里最好的是 video-lead 的 91.9 或 action-lead 的 91.0;线性偏移里 video-lead 最好到 92.3,仍差 0.7 分。更有意思的是两个家族的领先方向正好相反:方差平移下 video-lead 普遍好于 action-lead,线性偏移下反过来。作者的解释是:训练时显式的 video→action 信息流是必要的,但通过推理调度去「强制」一个先规划后执行的顺序并不会带来收益,这更支持「世界-动作联合表征学习」的假设(Fast-WAM 的观点[16]),而不是「推理时先想象未来再反推动作」的隐式 planning-then-IDM 假设(DreamZero 的观点[8])。
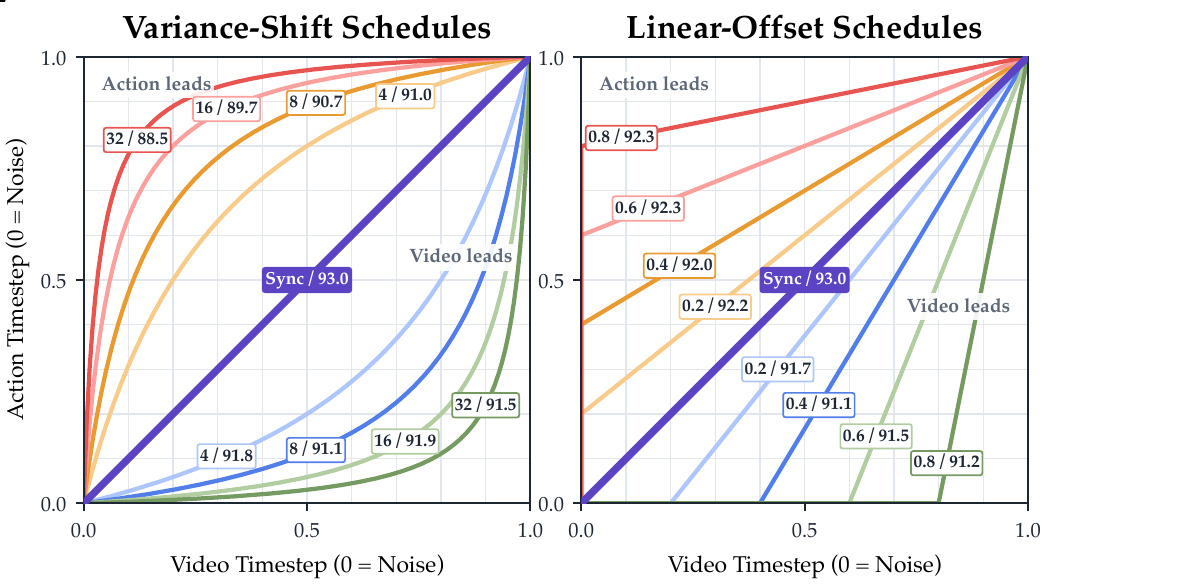
下面这个部件把这张图做成可交互的:切换调度家族和领先模态,拖动参数,看路径怎么偏离对角线、对应的实测成功率怎么变。
注意这个部件里的分数是论文图 9 上的实测点,不是拟合曲线;移动滑块时只在四个离散参数间跳,看的是「趋势 + 实测值」。一个容易误读的地方:异步调度在推理时把一路推得更干净,看起来像「先想象未来再动作」的 planning,但实验说明这种显式排序并不带来收益——训练时让动作看到世界特征,比推理时强迫世界先于动作更有效。
发现 2:世界-动作协同需要三件事:足够的动作专属容量、训练时显式的 world→action 信息流、推理时的同步联合去噪。论文把这些作为默认设置,把「单向可见 vs mutual」的选择留到了预训练之后。
2.5 Q3:协同如何跨域扩展?
到这里,单个域内的设计已经选完。但「单域表现好」不等于「学到了可迁移的世界-动作知识」——模型可能只是拟合了目标任务的视觉和动作分布。跨域预训练正好把这件事放大:机器人轨迹提供可执行的动作监督但视觉覆盖有限,人类自我中心视频视觉多样但没有机器人动作标签。论文要回答的是:预训练的增益从哪来、两种数据怎么组合、从零训练选出的信息流在预训练之后是否仍然成立。
2.5.1 受控迁移协议
所有 run 固定骨干、优化预算和推理过程,只改「是否预训练、怎么预训练」:
- RoboTwin2.0-Clean2Random:在 clean 数据上微调,clean 上评 in-domain(ID),randomized 上评 out-of-domain(OOD),专门暴露迁移能力;
- RoboTwin2.0-Full:在完整训练集上微调,报两个条件的平均。
预训练预算统一 600 小时:人类自我中心视频来自 EgoDex[28],机器人轨迹来自 RoboCOIN[29]。四个变体是:从零训练;robot-only(600 小时全给机器人);ego→robot(350 小时人类 + 250 小时机器人,两阶段);ego+robot co-train(同样的 350 + 250,一阶段联合)。
2.5.2 预训练主要涨 OOD,两种数据补不同的短板
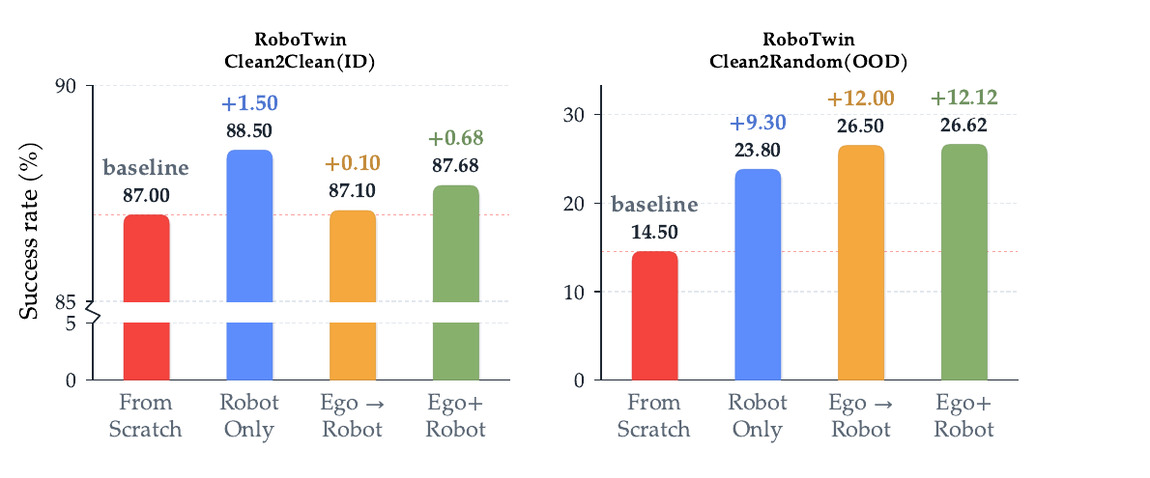
数字很直观:
| 预训练策略 | ID(Clean) | OOD(Randomized) |
|---|---|---|
| 从零训练 | 87.00 | 14.50 |
| Robot only(600h) | 88.50(+1.50) | 23.80(+9.30) |
| Ego → Robot(350h + 250h) | 87.10(+0.10) | 26.50(+12.00) |
| Ego + Robot co-train(350h + 250h) | 87.68(+0.68) | 26.62(+12.12) |
三个结论:
- 预训练主要买 OOD 泛化。ID 上从零训练已经 87 分,预训练最多 +1.5;OOD 上从零训练基本不会,预训练能拉到 26 分以上。用作者的话说,预训练提供的是「超出下游训练分布的知识」,而不是「把已经饱和的 ID benchmark 拟合得更好」。
- 两种数据贡献不同。robot-only 的 ID 最好(88.50),因为它把全部预算花在可执行动作上;但含 ego 的两个变体 OOD 明显更好,因为人类视频拓宽了视觉和交互分布。这正好对上「机器人轨迹强化动作锚定、第一视角视频拓宽视觉覆盖」的直觉。
- 顺序不如组合重要。两阶段 ego→robot 和一阶段 co-train 在 ID / OOD 上都只差零点几,co-train 略强且省掉一次课程切换,所以被选为默认。
2.5.3 预训练会改变偏好的信息流
Q2 里从零训练时 action-sees-video 略优于 mutual(92.39 对 92.15),这个差距小到当时无法定论。预训练之后重测同一组对比,结论翻转了:
- 从零训练、RoboTwin-Full:action-sees-video 92.39,mutual 92.15(−0.24);
- 预训练、RoboTwin-Full:action-sees-video 92.34,mutual 92.50(+0.16);
- 预训练、Clean2Random ID:86.98 → 87.68(+0.70);
- 预训练、Clean2Random OOD:25.70 → 26.42(+0.72)。
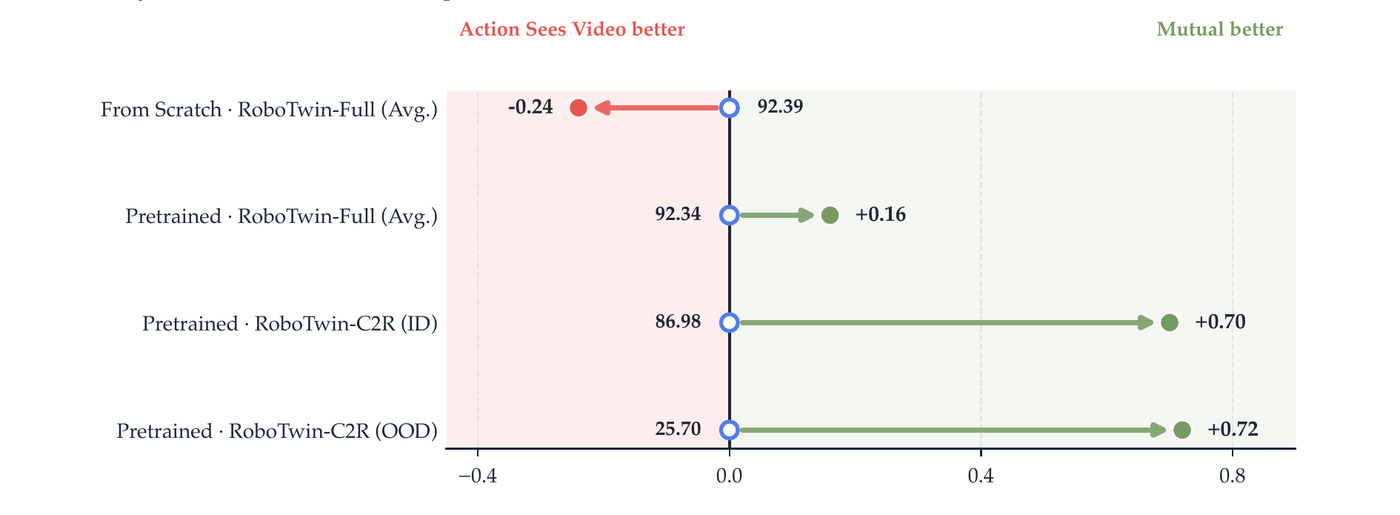
作者的解释是数据量:从零训练时数据稀缺,两路很难可靠地建立起「预测的未来帧」和「预测的动作」之间的对应关系,所以反向路径学不到东西;预训练数据多得多,这个对应关系被建立起来,mutual 就真正变成双向交换——预测的未来帧给动作提供视觉引导,预测的动作反过来告诉模型机械臂在画面里该怎么动。于是最终配方采用 mutual。
发现 3:具身预训练主要扩展 OOD 泛化。机器人轨迹保住动作锚定,第一视角视频拓宽迁移,一阶段 co-train 能有效整合两者;到了预训练规模,mutual 的世界-动作可见性一致更优。
2.5.4 配方
三个问题的答案被整理成一张表,每一项都是有消融数字支撑的默认选择:
| 阶段 | 结论 | 带入 OpenWAM-α 的默认值 |
|---|---|---|
| 继承(Inherit) | 有能力的视频骨干 + 紧凑表征 latent 迁移效果最好 | Wan2.2-TI2V-5B;紧凑 latent |
| 交互(Interact) | 专门的 action 容量和 world→action 可见性是必需的;同步去噪最好 | 双系统 joint self-attention;同步去噪 |
| 整合(Consolidate) | 具身预训练主要提升 OOD,且一致偏好 mutual 可见性 | 一阶段 ego + robot co-train;mutual 可见性 |
这张表是全文的枢纽:它不是一堆单独最优的超参数,而是一条有顺序的决策链——每个决策都在前一个决策造成的条件下被检验。下一节就是把这条链表组装成 OpenWAM-α,看它在全尺寸异构预训练下是否还成立。
2.6 OpenWAM-α:把配方放大
OpenWAM-α 就是表 3 那条链的实例化。架构上取 :冻结的 Wan2.2-VAE 做视觉编码器;预训练的 Wan2.2-TI2V-5B DiT 跑 world stream,一个独立的 1B 参数 ActionDiT 跑 action stream,两者通过 joint self-attention 耦合;可见性掩码取 mutual,视频内部用首帧因果注意力。
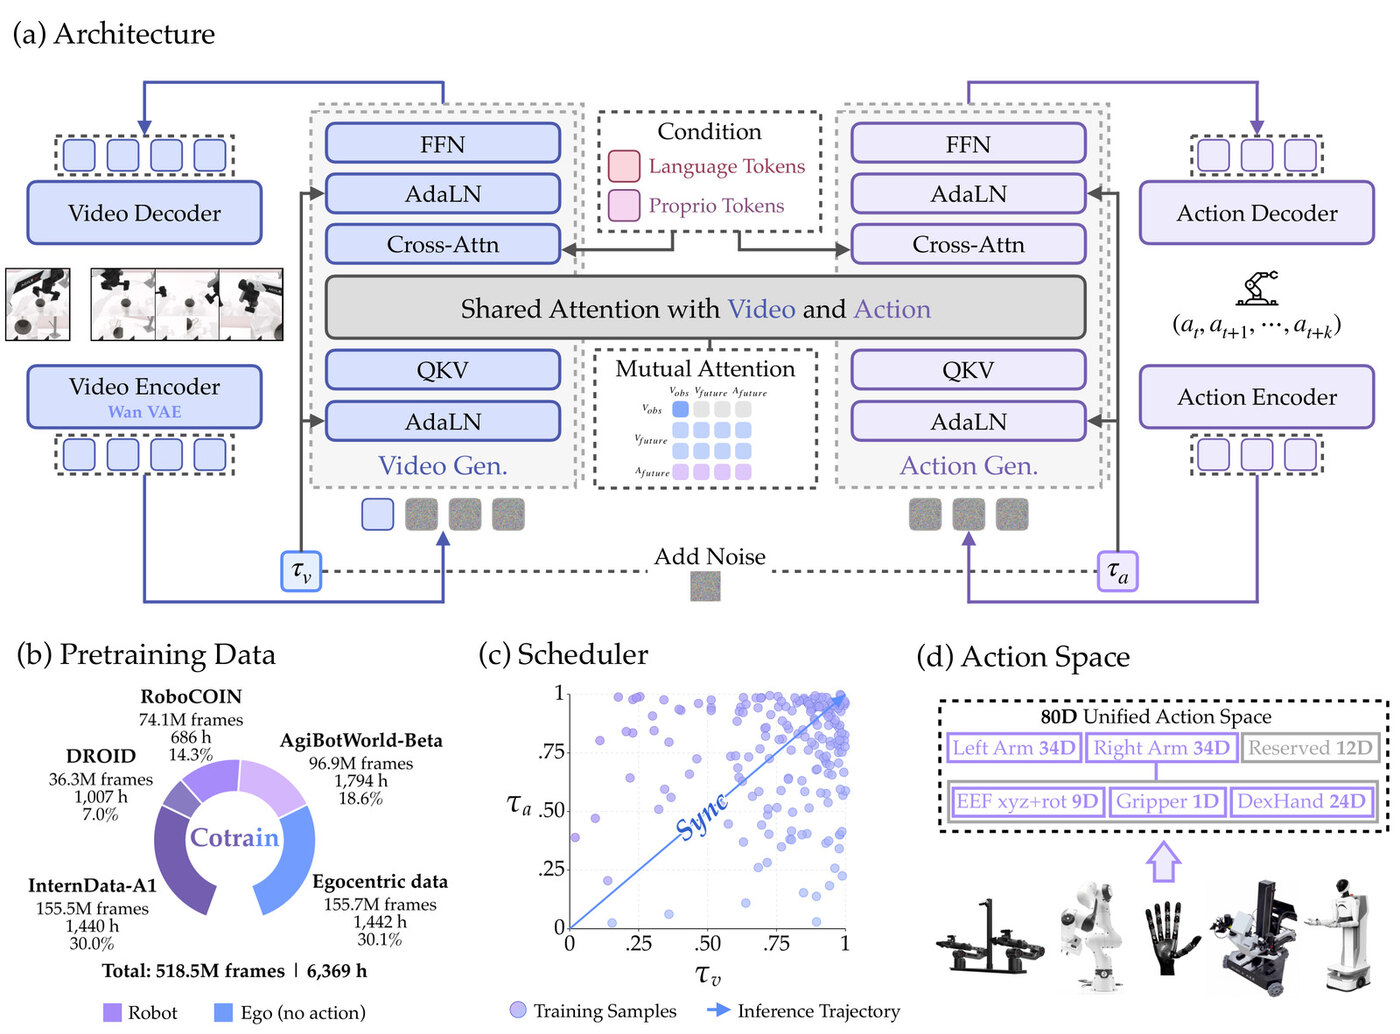
Tokenization 与上下文。冻结的 Wan2.2-VAE 因果编码 帧——首帧单独编码,之后每 4 帧一组——得到 个 latent 帧,首帧仍是「当下」的干净锚点。 的 patch embedding 把 latent 视频拉成宽度 3072 的 world token,带 3D RoPE(帧、高、宽); 个带噪动作步各线性嵌入成一个宽度 1024 的 action token,带 chunk 索引上的一维 RoPE。冻结的 umT5 把语言映射到 4096 维上下文,再线性投影追加一个本体 token,两路各用自己的 per-block cross-attention 读同一个上下文。
桥接与预测。两个骨干的 30 层配对层全部作为桥接层:各自的投影把两种残差宽度映射到 24 头 × 128 维的共享注意力空间,在 mutual 掩码下两路自由互读;干净的首帧行既不 attend 带噪未来帧也不 attend 动作。AdaLN 注入各自的时间步(world 侧按 token 注入、首帧 token 钉在干净端点 ),线性头把两路最终状态解码成速度。
训练。一阶段端到端:视频 DiT 从预训练 Wan2.2-TI2V-5B 初始化,ActionDiT 和本体编码器一起更新,只有 umT5 文本编码器和 Wan2.2-VAE 冻结。动作监督走 80 维统一空间,损失就是 (2) 式,, 是峰值在中间噪声水平的钟形权重;两个时间步独立采样 、, 用 的 warp 把采样偏向高噪声。
数据。这是全文工程量最大的部分。原始池子有 1.33B 帧(约 14,300 小时),经过清洗和按源下采样得到 518.5M 帧(约 6,369 小时),五个来源、三种数据类型:
| 来源 | 类型 | #本体 | FPS | 原始帧 (M) | 原始 h | 清洗后帧 (M) | h | 占比 |
|---|---|---|---|---|---|---|---|---|
| Egocentric(自建) | 人类视频 | 1 | 30 | 744.9 | 6,897 | 155.7 | 1,442 | 30.1% |
| AgiBotWorld-Beta[30] | 真机 | 1 | 15 | 124.5 | 2,306 | 96.9 | 1,794 | 18.6% |
| RoboCOIN[29] | 真机 | 15 | 30 | 104.5 | 956 | 74.1 | 686 | 14.3% |
| DROID[31] | 真机 | 1 | 10 | 46.3 | 1,285 | 36.3 | 1,007 | 7.0% |
| InternData-A1[32] | 仿真 | 4 | 30 | 313.7 | 2,904 | 155.5 | 1,440 | 30.0% |
| 合计 | 21 个本体 | 1,333.9 | 14,348 | 518.5 | 6,369 | 100% |
人类数据自建了 71.6K 段长视频(每段 0.25 到 6 分钟),覆盖 3,006 个日常操作任务;它没有机器人动作标签,所以动作和本体通道全部被 mask,只监督 world stream。真机数据来自 AgiBotWorld-Beta、RoboCOIN(17 个物理平台)和 DROID,给动作流提供可执行轨迹;仿真数据来自 InternData-A1,进一步拓宽单臂和双臂技能与环境变化。
采样预算按帧数分配:ego 和仿真各占 30%,剩下 40% 按清洗后有效帧数分给三个真机源,保证不同原生帧率的源按「模型实际消费的数据量」平衡;源内按小时预算 water-fill,整 episode 用固定种子下采样,训练按实际样本数比例采样,每个保留样本恰好每个 epoch 访问一次。
数据清洗分两级。视觉级对所有源统一做:解码失败、冻结 / 重复帧、纯黑纯白纯色帧、过曝欠曝和曝光闪烁、模糊、视觉跳变,全部剔除;ego 数据额外去掉「手离开视野」的片段和无效语言标注。信号级只对机器人数据做四步:① 信号完整性——末端状态跟不上指令(幅度比 ≥3 倍且逐轴相关 <0.5)或视频-信号错位超过 2% 帧的 episode 直接丢;② state-first 空闲检测——用逐机器人运动阈值(由单帧增量的 p99.5 标定)和「平均末端平移 < 2 cm/s、测地旋转 < 5°/s」确认静止,只裁头尾、绝不切中间的停顿(否则会拼接时间上不相邻的帧),抖动和尖峰用中位数–MAD 阈值筛;③ 视觉交叉检查——状态在动但所有相机画面静止,判为传感器抖动裁掉;状态不动但画面里机械臂在动,判为采集缺陷丢 episode;④ episode 级删除——丢帧超过 70% 或视频冻结 ≥90% 的整段删除。
部署。同步去噪, 步、,首帧 latent 每一步后重新钉回当前观测的编码,30 个桥接层每步都做一次联合前向,动作 chunk 在越来越干净的世界特征上被反复精化。整个 N 步循环在 RTX 5090 上约 170 ms 一个 chunk。
三、实验结果
3.1 八个仿真基准
从预训练 base 出发,在每个基准上做监督微调。八个基准覆盖五类本体:单臂(LIBERO、LIBERO-Plus、VLABench)、双臂(RoboTwin2.0、RoboDojo)、移动单臂(RoboCasa365)、移动双臂(EBench)、灵巧手(RoboCasa-GR1)。RoboTwin2.0 评测两个版本:Full 在 clean + randomized 混合上微调、两个条件都评,看 ID 能力;Clean2Random 只在 clean 上微调、randomized 上评,看 OOD 泛化。SFT 的配置见论文表 10,各基准的 batch size / epoch / 增强策略不完全相同,比较时要注意。
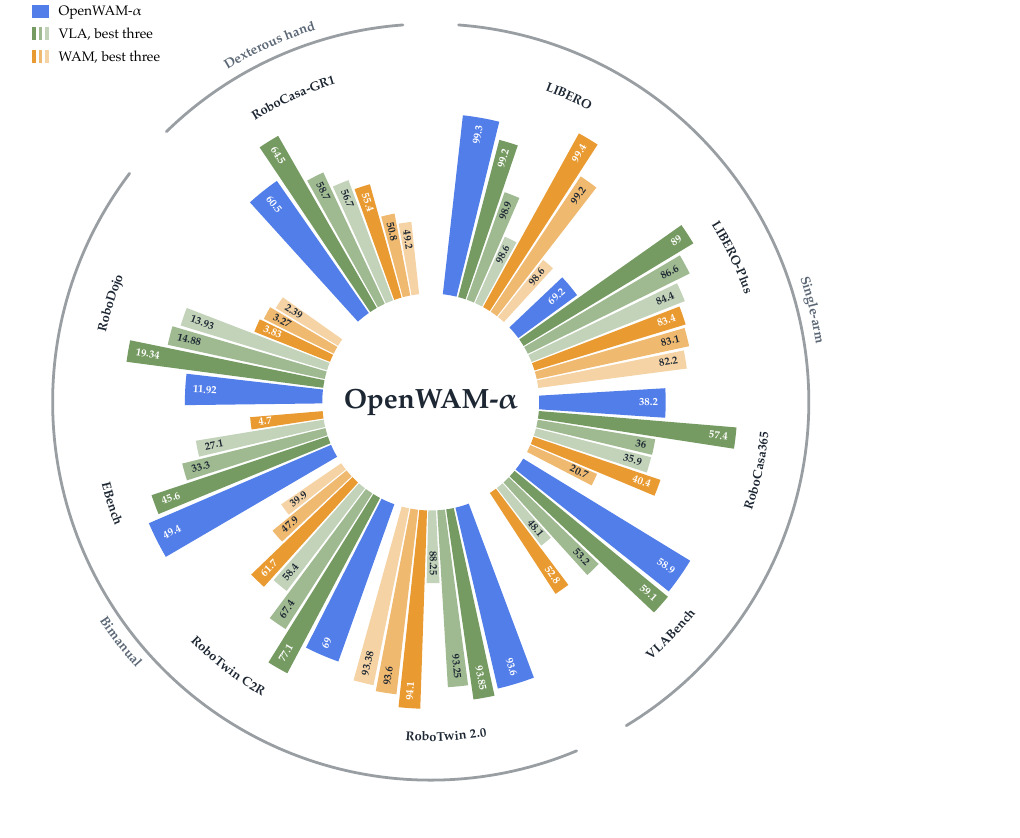
下面这个部件把论文附录 D 的逐基准表格做成可切换的条形图。选基准、看排序,OpenWAM-α 用主色标出:
把所有基准放在一起看,取论文图 13/14 和附录表的结论:
- 贴着榜首:LIBERO 99.3(差榜首 0.1)、VLABench 58.9(差 0.2)、RoboTwin2.0-Full 93.60(差 0.5)基本和最强模型打平(VLABench 上最强的是 VLA Xiaomi-Robotics-1[33]);第一梯队:RoboCasa-GR1 60.5 只比总榜榜首低 4 分,RoboCasa365 38.2 比 WAM 榜首低 2.2 分,但比 VLA 榜首低近 20 分(移动操作数据不足的直接体现);
- WAM 里的第一:RoboTwin2.0-Clean2Random(69.0)、RoboDojo(11.92 SR)、RoboCasa-GR1(60.5)、EBench(49.4,且是全场 SOTA);
- 例外:LIBERO-Plus 69.2,明显低于它在其他基准上的位置。
3.1.1 为什么偏偏 LIBERO-Plus 掉队?
LIBERO-Plus 是 LIBERO 的扰动鲁棒性版本,每个子项扰动一个因素:相机、机器人本体、语言、光照、背景、噪声、布局;这里的 VLA 标杆是 Qwen-RobotManip[34]。前三行是 VLA、后四行是 WAM;语言和光照扰动对所有方法都不算难,为省版面略去这两列。OpenWAM-α 的分项是:
| 方法 | Camera | Robot | Background | Noise | Layout | 平均 |
|---|---|---|---|---|---|---|
| Qwen-RobotManip | 87.2 | 75.5 | 97.7 | 97.7 | 87.3 | 89.0 |
| ACoT-VLA | 72.6 | 82.6 | 96.5 | 87.8 | 88.1 | 86.6 |
| π0.5 | 78.4 | 73.6 | 94.1 | 89.0 | 84.5 | 84.4 |
| ABot-M0.5 | 70.5 | 87.4 | 89.7 | 75.5 | 85.2 | 83.4 |
| ImageWAM | 80.8 | 50.3 | 85.5 | 93.8 | 80.5 | 83.1 |
| Being-H0.7 | 82.0 | 59.0 | 90.0 | 93.5 | 88.5 | 82.1 |
| OpenWAM-α | 33.8 | 76.1 | 87.1 | 39.8 | 77.5 | 69.2 |
损失集中在相机(33.8)和噪声(39.8)这两个扰动上,背景和布局也偏低。作者从两个轴去解释:
数据轴。单臂部分只有两个来源:DROID(固定单臂平台、固定相机视角)和 InternData-A1 的单臂部分。论文图 15 把 OpenWAM-α 的单臂预训练数据量和两个强 WAM 基线放在一起:ABot-M0.5[35] 有 8000+ 小时,Being-H0.7[36] 有 5700+ 小时,OpenWAM-α 只有 1100+ 小时。单臂覆盖不足,模型在 LIBERO-Plus 的 OOD 扰动上自然吃亏;反过来,OpenWAM-α 的预训练里自我中心、双臂、灵巧手数据很丰富,它在双臂和灵巧手基准上就强。
架构轴。Fast-WAM、ABot-M0.5 和 OpenWAM-α 共享同一个核心预测目标——用 Wan2.2-VAE 的重建 latent 预测一段像素级未来视频——三者在 LIBERO-Plus 上有同一个签名:相机和噪声扰动下的分数明显低于其他扰动。像素级信息对相机和噪声天生敏感。两个反例支持这个解释:ImageWAM[37] 不做预训练但依然强,因为它只预测当前观测的单帧未来,更像编辑而不是 rollout,误差不跨帧累积;Being-H0.7 用 V-JEPA 2.1 编码,中间 latent 仍然是时序的,但是语义特征而非像素重建,所以对相机和噪声鲁棒得多。
Takeaway 1:一个具身模型在某个基准上泛化得好不好,最终取决于它的预训练混合里有没有「本体和环境都接近该基准测试条件」的数据。具身基础模型最关键的原料仍然是大规模、多样、场景丰富的机器人操作数据。
Takeaway 2:在像素 latent 空间预测未来的 WAM 可以靠数据把性能堆得很高,但对视觉扰动的鲁棒性有内在上限;要再往上推,需要一个对环境变化鲁棒、信息丰富且足够紧凑的表征。
3.2 VLA 与 WAM:谁更强?
这是这篇论文最容易被引用的一张图。结论先说:没有哪个范式整体更强,但两者各有一个优势区。
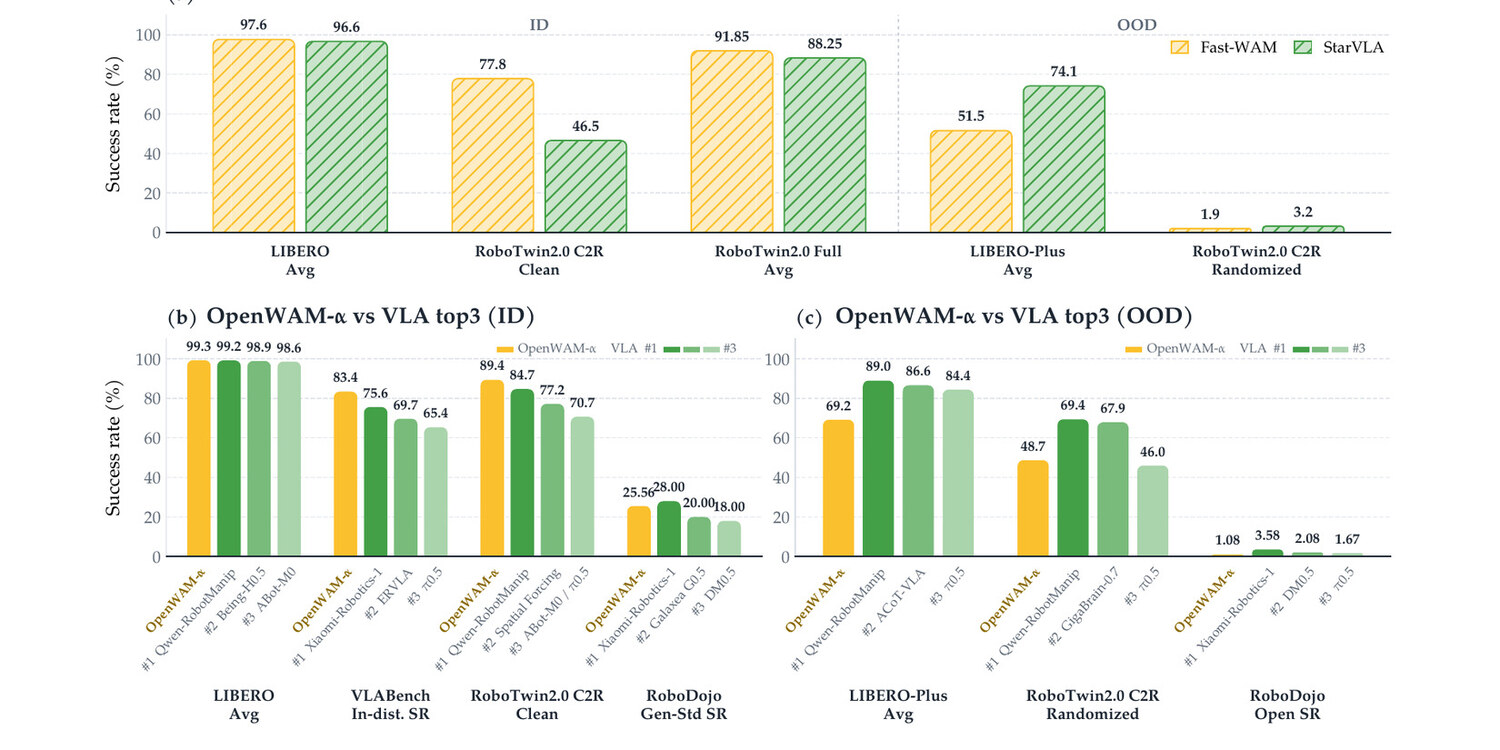
分布内,WAM 拟合得更好。 最干净的对比是 StarVLA[38] vs Fast-WAM(两者都没有具身预训练):LIBERO 上 97.6 vs 96.6,RoboTwin2.0-Clean2Random 的 Clean 划分 77.8 vs 46.5,RoboTwin2.0-Full 91.85 vs 88.25。预训练模型从两个方向讲同一个故事:OpenWAM-α 在 LIBERO、VLABench 的 In-dist 划分、C2R 的 Clean 划分上领先三个最强 VLA,在 RoboDojo 的 Gen-Std 划分上也只差一点——尽管这些 VLA 的预训练数据比它多。机制解释是:VLA 只被动作监督优化,没有中间 latent 目标;WAM 的视频 latent 项给参数优化注入了额外信息源,所以能把训练分布拟合得更紧。
分布外,VLA 泛化得更好。 同一组对比在 OOD 下反转:LIBERO-Plus 上 VLA 大幅领先(74.1 vs 51.5),C2R 的 Randomized 划分上两个模型都崩了但排序仍偏向 VLA(3.2 vs 1.9)。预训练模型也镜像反转:LIBERO-Plus、C2R-Randomized、RoboDojo 的 Open 划分上,OpenWAM-α 落后 SOTA VLA 明显。机制是 ID 优势的背面:长程未来预测在分布内是额外的监督信号,但在分布偏移下,同样的长程意味着更重的误差累积——这是只做动作的 VLA 不用背的包袱。
Takeaway 3:没有哪个范式全面胜出。视频 latent 监督让 WAM 在分布内拟合上占优,VLA 在分布外泛化上更好;两种缺陷都可以被足够大而多样的预训练数据弥补。把两个端到端范式的互补优势结合起来,是把能力边界继续往前推的可行路线。
作者还补了一句大实话:ID 拟合缺陷和 OOD 泛化缺陷最终都是数据问题——只要预训练数据覆盖足够复杂的环境变化、带精确动作标注,任何一个范式都能同时拿到强拟合和强泛化。「数据仍然是模型开发的第一优先级。」这句话值得所有做具身基础模型的人抄下来。
3.3 真机实验
仿真之外,论文在三种本体上做了真机评测:
- 单臂:Franka-Research-3 平台,六个桌面任务(堆叠、悬挂、抽屉),覆盖基础与精细操作;
- 双臂:RoboDojo 官方真机平台,三种本体(ARX X5、Piper、Piper X),按 RoboDojo 任务分类覆盖泛化、精度、长程、记忆和开放任务,共 18 个任务;
- 灵巧手:Wuji 灵巧手 + Tianji 机械臂,四个任务(堆玩具塔、收集羽毛球、拧瓶盖、收衣服),ID + 多组单因素 OOD(物体、布局、光照、背景)。
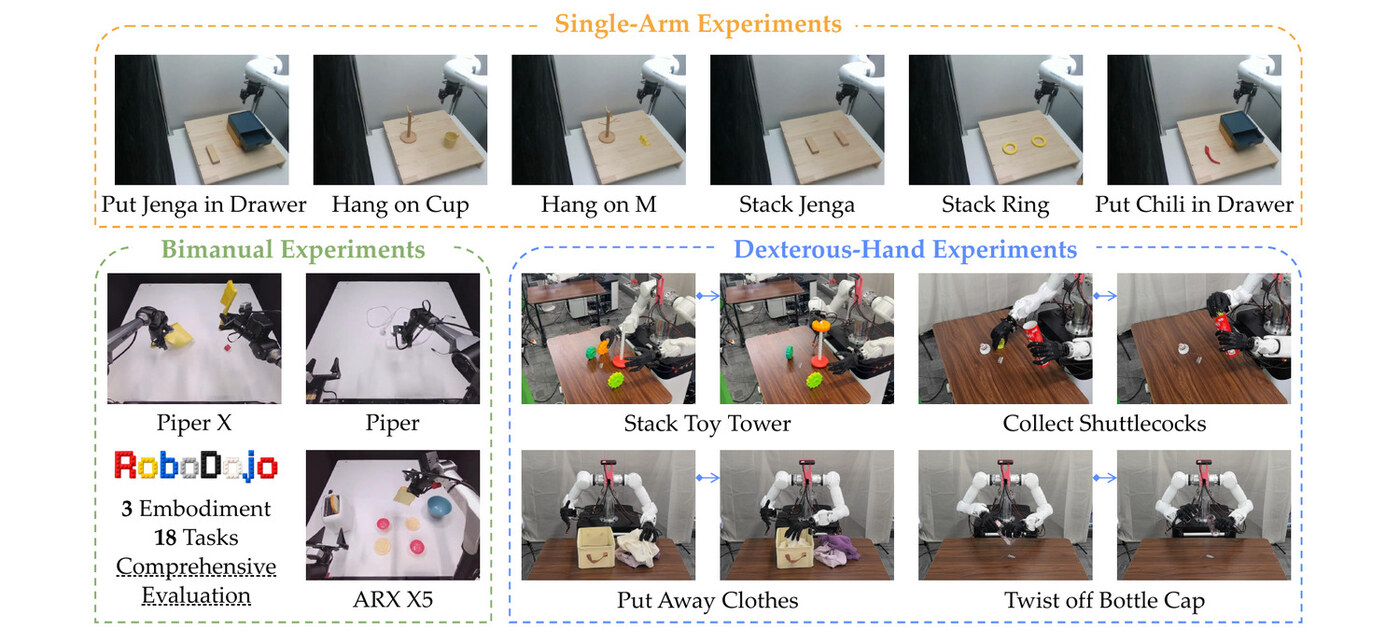
单臂。每个任务用 100 条任务专属真机演示微调,评 20 次。OpenWAM-α 平均 99/120(82.5%),LingBot-VA 93/120(77.5%),π0.5 66/120(55.0%)。两个抽屉任务(放辣椒、放 Jenga 再推上抽屉)OpenWAM-α 都是 20/20,说明长程精细操作没有掉链子。
| 方法 | Stack Jenga | Stack Ring | Put Chili | Put Jenga | Hang on M | Hang on Cup | 平均 |
|---|---|---|---|---|---|---|---|
| π0.5 | 13/20 | 7/20 | 14/20 | 15/20 | 7/20 | 10/20 | 55.0% |
| LingBot-VA | 16/20 | 15/20 | 17/20 | 17/20 | 13/20 | 15/20 | 77.5% |
| OpenWAM-α | 17/20 | 12/20 | 20/20 | 20/20 | 13/20 | 17/20 | 82.5% |
双臂真机。在 RoboDojo 官方真机榜上,OpenWAM-α 在大多数任务上达到 SOTA,总体 37.6 Score / 24.4 SR,明显高于 π0.5 的 22.9 / 12.8、InternVLA-A1 的 12.0 / 7.2、GalaxeaVLA 的 9.0 / 4.4、X-VLA 的 7.6 / 3.3 和小米 Robotics-0 的 7.9 / 3.9。论文按本体取了平均:ARX X5 上 39.0 / 23.3,Piper 上 46.7 / 36.7,Piper X 上 27.2 / 13.3(数字是 Score / SR)。
灵巧手。这是最能说明「泛化到没见过的本体」的一组实验:9 维末端位姿 + 21 维手部自由度的动作空间、Wuji 手 + Tianji 臂的硬件组合,都完全没在预训练里出现过。OpenWAM-α 在所有任务、所有设置上都超过 π0.5,而且差距不小:
| 任务 | 指标 | π0.5 ID | OpenWAM-α ID | π0.5 OOD | OpenWAM-α OOD |
|---|---|---|---|---|---|
| Stack Toy Tower | Score / SR | 53.3 / 10% | 70.0 / 40% | 40.0 / 10% | 56.7 / 30% |
| Collect Shuttlecocks | Score / SR | 31.4 / 20% | 82.9 / 60% | 31.5 / 20% | 52.6 / 26.7% |
| Put Away Clothes | Score / SR | 86.7 / 60% | 100 / 100% | 75.0 / 45% | 91.7 / 85% |
| Twist off Bottle Cap | Score / SR | 80.0 / 30% | 100 / 70% | 65.0 / 30% | 90.0 / 80% |
三组真机实验合起来给出一个明确的信号:这套配方学到的是可以迁移到新本体、新动作空间的能力,而不是在训练过的平台上过拟合的招式。 当然,真机数字也有它的局限:每个任务只有 20 次或几十次试验,统计噪声不小;单臂只用 100 条演示微调;灵巧手的 OOD 是单因素扰动,离真实世界的组合偏移还有距离。
四、局限性
作者在附录 A 里列了四条,态度挺坦诚:
- 只覆盖了预训练阶段。论文主要研究具身预训练,后训练与适配(例如强化学习、在线微调)对具身基础模型的提升可能很大,但这部分的方法和机制还是开放问题。
- 架构探索不完整。六个架构变体主要用跨模态注意力和硬路由 MoE 做模态融合;作者自己说,借鉴统一多模态模型(UMM)社区的经验,tokenization 阶段的早期融合、软路由 MoE 都值得试。
- 预训练数据有缺口。没有加入 UMI 风格的数据(UMI、DexUMI 这类手持夹具采集)[39]。理论上 UMI 数据能提供接近人类视频的任务和场景多样性,同时带机器人可执行动作,是提升 OOD 泛化、又比真机采数据便宜得多的路子。作者也看好仿真继续放大数据量。
- 视觉编码器不是最优解。选 Wan2.2-VAE 是在时间压缩和 token 压缩之间权衡后的「当前最好」,但实验显示这类像素重建编码器对视角、噪声、场景变化不够鲁棒;一个既紧凑又携带足够环境信息的 latent 仍然缺位。
我自己再补几条:
- 受控研究基本押在 RoboTwin2.0 上。 Q1–Q3 的结论(尤其是「同步去噪最好」「预训练后 mutual 更优」)是在一个双臂桌面操作基准上得到的,换成移动操作、灵巧手或长程任务是否成立,论文只用 α 的最终成绩间接验证,没有重复整套受控实验。读结论时要把「在这个基准和这个数据预算下」补在心里。
- 自建的自我中心数据没有开源。 论文放出了清洗后的机器人数据(AgiBotWorld-Beta、RoboCOIN、DROID、InternData-A1),但占 30% 的自建人类视频(71.6K 段、3,006 个任务)不在 Hugging Face 的发布列表里。这意味着 α 的配方可以复现训练流程,但数据配比里的 30% 难以原样复现。
- 清洗规则是工程选择,没有消融。 「丢帧超过 70% 整段删除」「视频冻结 ≥90% 删除」「末端平移 < 2 cm/s 算静止」这些阈值直接影响最终数据量和数据分布,论文没有给出「换一组阈值会怎样」的实验。对准备复用这套 pipeline 的人来说,这是最需要自己试的部分。
- 同步推理的延迟没有被认真评估。 论文所有评测都用同步推理(缓冲区空了就停下来等),RTX 5090 上 170 ms 一个 chunk 对桌面操作够用,但对高动态任务、或者要跑在更低算力平台上的场景,停顿可能不可接受。论文说异步调度不涨点,但那是精度视角;延迟、吞吐、抖动这些部署指标没有在真机上系统比较。
- 「VLA vs WAM」的结论依赖基线选择。 Fast-WAM 和 StarVLA 都没有具身预训练,这个对比很干净;但预训练模型之间的对比里,各家的数据量、数据质量、SFT 预算都不同,OpenWAM-α 的「第一梯队」和「落后」都要结合数据量一起读——作者自己也是这么解释 LIBERO-Plus 的。
- 训练成本很高。 128 张 H200 跑 7 天,加上 518M 帧数据的清洗和存储,这不是一个学术实验室能轻松复现的规模。好消息是论文把 5B 骨干、单机 8 卡可训的调试路径和所有 SFT 配置都放出来了,小规模验证配方是可行的。
五、结论与展望
把这篇论文的故事线压缩成一句话:WAM 的瓶颈不是「视频模型 + 动作头」这个结构,而是设计空间被耦合在一起、无法归因;OpenWAM 用一套可组合的基础设施把设计空间拆开,用控制变量实验筛出配方,再用 518M 帧数据证明配方在规模上依然成立。
我认为它对领域最实在的三个贡献是:
- 一套可复用的实验基础设施。 六个架构 × 五个视频骨干 × 四个编码器 × 四种注意力掩码,全部由配置组合;训练、部署、评测三套 runtime 与架构解耦。以后比较 WAM 的设计选择,终于不用各写各的代码了。
- 几条有数字支撑、可以直接抄的结论。 视频骨干要够强但 5B 是性价比拐点;表征 encoder 加维度压缩可以替代重建 encoder;动作需要专属容量;训练时必须有 world→action 信息流;推理时同步去噪最好;预训练主要买 OOD;一阶段 ego + robot co-train 最省事;预训练后 mutual 更优。每一条背后都有消融表,这在 2026 年的 WAM 论文里是稀缺品。
- 一个诚实的强基线。 OpenWAM-α 在 8 个仿真基准里大多数处于第一梯队、在 EBench 上 SOTA、在真机三种本体上能打,同时公开了代码、权重、清洗后的数据,以及 LIBERO-Plus 这种「翻车」案例的归因分析。对后来者来说,这比一个只报喜的 SOTA 有用得多。
对准备上手 WAM 的实践者,我的建议是:
- 先定动作空间,再定架构。 80 维统一空间这套设计让跨本体训练成为可能,但每个数据集都要写 映射,这个工程量要提前算进去。
- 视频骨干选「够用 + 训得起」的档位。 5B 左右是当前甜点;更大的骨干收益递减,推理成本却是线性涨的。
- 动作容量不能省。 单系统省下的参数会在成功率上还回来(约 7 分);双系统 joint self-attention 是当前最稳的默认。
- 训练时一定要让动作看到世界特征,这是全文最硬的一条消融(+5 分);推理时不要折腾异步调度,同步就够好。
- 预训练数据里,机器人数据保底、人类视频拓宽;如果数据量不大,先从 robot-only 起步,等数据上量再切 co-train + mutual。
- latent 空间要盯紧鲁棒性。 如果目标场景有相机抖动、噪声、光照变化,像素重建 latent 是已知短板,优先考虑表征 encoder + 压缩。
往后看,论文点出的几个方向都挺自然:带原生时间压缩、对环境变化鲁棒的表征 encoder(这是 LIBERO-Plus 翻车的根因,也是作者自己列的第一优先级);后训练与强化学习(预训练只解决了「知道世界怎么变」,没解决「怎么把事做对」);UMI 风格的低成本数据和仿真数据放大;以及把 VLA 的泛化优势和 WAM 的拟合优势缝起来的端到端设计。把模型设计当实证科学来做这条路线本身也在成型——Cambrian-1、Beyond Language Modeling、Towards Physics of Multimodal Pretraining 这一系列工作[40, 41, 42],加上 WAM 侧的 DiT4DiT、X-WAM、4D-WAM、GigaWorld-Policy、AHA-WAM[43, 44, 45, 46, 47],正在把「拍脑袋改结构」变成「提出假设、控制变量、量化归因」。OpenWAM 是这条路线在 WAM 上的一次比较完整的示范。
六、上手
代码在 OpenWAM-Official/OpenWAM,Apache-2.0。环境要求 Python ≥ 3.10,推荐 PyTorch 2.7.1 + CUDA 12.8;官方建议 8 张 80 GB 显卡做训练(Wan2.2-5B 或更小的骨干),部署在单张 RTX 5090 上就能跑出 170 ms/chunk 的实时性。
安装 OpenWAM(Python 3.10 + PyTorch 2.7.1)
git clone https://github.com/OpenWAM-Official/OpenWAM.git
cd OpenWAM
conda create -n openwam python=3.10 && conda activate openwam
pip install torch==2.7.1 torchvision==0.22.1 torchaudio==2.7.1 \
  --index-url https://download.pytorch.org/whl/cu128
pip install -e .
资源用交互式脚本下载:视频骨干、基准数据、可选的 VLM 骨干和视觉编码器、以及官方发布的 checkpoint。最短的端到端路径是「LIBERO + Wan2.2-TI2V-5B + 双系统 joint self-attention + mutual 掩码」:
下载资源、debug 训练与部署测试
# 1. 下载 LIBERO 数据和 Wan2.2-TI2V-5B 权重(交互式菜单选择)
python scripts/download_assets/download_benchmark_data.py
python scripts/download_assets/download_video_backbone.py

# 2. 20 步 debug 训练,确认环境和显存没问题
bash scripts/train.sh \
  dataloader=libero \
  model=dual_system \
  model/video_backbone=wan22_ti2v_5b \
  model.architecture.variant=joint_self_attn \
  model.architecture.attention_mask_mode=mutual \
  training.debug=true

# 3. 部署刚训出来的 checkpoint,另一个终端跑单次和连续推理测试
bash scripts/deploy.sh <debug_ckpt_dir_path>
python scripts/inference_test/inference_single_test.py \
  --server ws://127.0.0.1:8848 --test --state-dim 10
python scripts/inference_test/inference_continuous_test.py \
  --server ws://127.0.0.1:8848 --test --state-dim 10
论文概念到配置项的对应关系大致是:
| 论文里的概念 | 配置项 |
|---|---|
| 架构家族与变体(6 种) | model=dual_system 加 model.architecture.variant(joint_self_attn / joint_cross_attn / idm …) |
| 视频骨干(5 种) | model/video_backbone(默认 wan22_ti2v_5b) |
| 视觉编码器(VAE / DINOv3 / V-JEPA 2.1) | model/video_backbone 的 encoder 组,或接外部 encoder 配置 |
| 可见性掩码(4 种) | model.architecture.attention_mask_mode(mutual / action_sees_video / video_sees_action / isolated) |
| 统一动作空间(80 维) | 各 dataloader 自带 native → 80 维的 Scatter/Gather 映射 |
| 帧数与动作视野 | num_frames=33、video_stride=4(例如 configs/dataloader/libero.yaml) |
| 从预训练权重微调 | training.finetune_ckpt_path=<foundation_ckpt_dir> |
官方发布的 checkpoint 分两类:OpenWAM-α 的基础模型和各个基准微调后的策略;每个 checkpoint 目录都带自己的自包含配置,scripts/deploy.sh 可以直接起服务。清洗后的四个机器人数据集(AgiBotWorld-Beta、RoboCOIN、InternData-A1、DROID)在 Hugging Face 上;注意视频骨干、DINOv3、Qwen3-VL 这些上游权重各有自己的许可证,商用前要分别确认。仓库还维护了 Docker / 离线部署、训练与微调、架构扩展、基准接入、α 微调五份使用文档,比 README 更适合当手册用。
参考
- Wang, Huang, Li, Zhang, et al.. OpenWAM: An Open, Modular Exploration Towards Systematic World-Action Model Pretraining. arXiv 2609.07398, 2026. arXiv · 代码
- Black, Brown, Driess, et al.. π0: A Vision-Language-Action Flow Model for General Robot Control. arXiv 2410.24164, 2024. arXiv
- Physical Intelligence, Black, Brown, et al.. π0.5: A Vision-Language-Action Model with Open-World Generalization. arXiv 2504.16054, 2025. arXiv
- Zhao, Kumar, Levine, Finn. Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware. RSS 2023. arXiv
- Brohan, Brown, Carbajal, et al.. RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control. CoRL 2023. arXiv
- Kim, Pertsch, Karamcheti, et al.. OpenVLA: An Open-Source Vision-Language-Action Model. CoRL 2024. arXiv · 代码
- Pai, Achenbach, Montesinos, et al.. mimic-video: Video-Action Models for Generalizable Robot Control Beyond VLAs. arXiv 2512.15692, 2025. arXiv
- Ye, Ge, Zheng, et al.. World Action Models are Zero-shot Policies. arXiv 2602.15922, 2026. arXiv
- Siméoni, Vo, Seitzer, et al.. DINOv3. arXiv 2508.10104, 2025. arXiv · 代码
- Mur-Labadia, Muckley, Bar, et al.. V-JEPA 2.1: Unlocking Dense Features in Video Self-Supervised Learning. arXiv 2603.14482, 2026. arXiv
- Zhang, Zhang, Zhang, et al.. Both Semantics and Reconstruction Matter: Making Representation Encoders Ready for Text-to-Image Generation and Editing. arXiv 2512.17909, 2025. arXiv
- Peebles, Xie. Scalable Diffusion Models with Transformers. ICCV 2023. arXiv
- Wan, Wang, Ai, et al.. Wan: Open and Advanced Large-Scale Video Generative Models. arXiv 2503.20314, 2025. arXiv
- Ali, Bai, Bala, et al.. World Simulation with Video Foundation Models for Physical AI. arXiv 2511.00062, 2025. arXiv
- Bai, Cai, Chen, et al.. Qwen3-VL Technical Report. arXiv 2511.21631, 2025. arXiv
- Yuan, Dong, Liu, Zhao. Fast-WAM: Do World Action Models Need Test-time Future Imagination?. arXiv 2603.16666, 2026. arXiv
- Li, Zhang, Luo, et al.. Causal World Modeling for Robot Control. arXiv 2601.21998, 2026. arXiv
- Lipman, Chen, Ben-Hamu, Nickel, Le. Flow Matching for Generative Modeling. ICLR 2023. arXiv
- Liu, Zhu, Gao, et al.. LIBERO: Benchmarking Knowledge Transfer for Lifelong Robot Learning. NeurIPS 2023. arXiv · 代码
- Fei, Wang, Shi, et al.. LIBERO-Plus: In-depth Robustness Analysis of Vision-Language-Action Models. arXiv 2510.13626, 2025. arXiv
- Zhang, Xu, Liu, et al.. VLABench: A Large-Scale Benchmark for Language-Conditioned Robotics Manipulation with Long-Horizon Reasoning Tasks. arXiv 2412.18194, 2024. arXiv
- Chen, Chen, Chen, et al.. RoboTwin 2.0: A Scalable Data Generator and Benchmark with Strong Domain Randomization for Robust Bimanual Robotic Manipulation. arXiv 2506.18088, 2025. arXiv · 代码
- Chen, Chen, Li, et al.. RoboDojo: A Unified Sim-and-Real Benchmark for Comprehensive Evaluation of Generalist Robot Manipulation Policies. arXiv 2607.04434, 2026. arXiv · 项目页
- Nasiriany, Maddukuri, Zhu. RoboCasa365: A Large-Scale Simulation Framework for Training and Benchmarking Generalist Robots. ICLR 2026. 项目页
- NVIDIA, Bjorck, Castañeda, et al.. GR00T N1: An Open Foundation Model for Generalist Humanoid Robots. arXiv 2503.14734, 2025. arXiv
- Gao, Zheng, Gao, et al.. EBench: Elemental Diagnosis of Generalist Mobile Manipulation Policies. arXiv 2606.18239, 2026. arXiv
- Black Forest Labs. FLUX.2: Analyzing and Enhancing the Latent Space of FLUX. Technical blog, 2025. 博客
- Hoque, Huang, Yoon, Sivapurapu, Zhang. EgoDex: Learning Dexterous Manipulation from Large-Scale Egocentric Video. arXiv 2505.11709, 2025. arXiv
- Wu, Liu, Xie, et al.. RoboCOIN: An Open-Sourced Bimanual Robotic Data Collection for Integrated Manipulation. arXiv 2511.17441, 2025. arXiv
- Bu, Cai, Chen, et al.. AgiBot World Colosseo: A Large-Scale Manipulation Platform for Scalable and Intelligent Embodied Systems. arXiv 2503.06669, 2025. arXiv
- Khazatsky, Pertsch, Nair, et al.. DROID: A Large-Scale In-The-Wild Robot Manipulation Dataset. RSS 2024. arXiv · 项目页
- Tian, Yang, Xie, et al.. InternData-A1: Pioneering High-Fidelity Synthetic Data for Pre-training Generalist Policy. arXiv 2511.16651, 2025. arXiv
- Xiaomi Robotics Team, Guo, Jin, et al.. Xiaomi-Robotics-1: Scaling Vision-Language-Action Models with over 100K Hours of Real-World Trajectories. arXiv 2607.15330, 2026. arXiv
- Yuan, Liang, Chen, et al.. Qwen-RobotManip Technical Report: Alignment Unlocks Scale for Robotic Manipulation Foundation Models. arXiv 2606.17846, 2026. arXiv
- Chen, Yang, Tang, et al.. ABot-M0.5: Unified Mobility-and-Manipulation World Action Model. arXiv 2607.00678, 2026. arXiv
- Luo, Zhang, Feng, et al.. Being-H0.7: A Latent World-Action Model from Egocentric Videos. arXiv 2605.00078, 2026. arXiv
- Zhang, Zhang, Qi, et al.. ImageWAM: Do World Action Models Really Need Video Generation, or Just Image Editing?. arXiv 2606.19531, 2026. arXiv
- StarVLA Community. StarVLA: A Lego-like Codebase for Vision-Language-Action Model Developing. arXiv 2604.05014, 2026. arXiv
- Chi, Xu, Pan, et al.. Universal Manipulation Interface: In-The-Wild Robot Teaching Without In-The-Wild Robots. RSS 2024. arXiv
- Tong, Brown, Wu, et al.. Cambrian-1: A Fully Open, Vision-Centric Exploration of Multimodal LLMs. NeurIPS 2024. arXiv
- Tong, Fan, Nguyen, et al.. Beyond Language Modeling: An Exploration of Multimodal Pretraining. arXiv 2603.03276, 2026. arXiv
- Han, Tong, Fan, et al.. Towards Physics of Multimodal Pretraining: Knowledge Flow, Modality Synergy, Early Unification, and Recipes. arXiv 2608.05000, 2026. arXiv
- Ma, Zheng, Wang, et al.. DiT4DiT: Jointly Modeling Video Dynamics and Actions for Generalizable Robot Control. arXiv 2603.10448, 2026. arXiv
- Guo, Li, Li, et al.. Unified 4D World Action Modeling from Video Priors with Asynchronous Denoising. arXiv 2604.26694, 2026. arXiv
- Yang, Song, Wang, et al.. 4D-WAM: Infusing Spatiotemporal Awareness into World Action Models through Trajectory Fields. arXiv 2608.08023, 2026. arXiv
- Ye, Wang, Ni, et al.. GigaWorld-Policy: An Efficient Action-Centered World-Action Model. arXiv 2603.17240, 2026. arXiv
- Cai, Ling, Chu, et al.. AHA-WAM: Asynchronous Horizon-Adaptive World-Action Modeling with Observation-Guided Context Routing. arXiv 2606.09811, 2026. arXiv