· 76 min read
论文解读:Qwen3-VL,六款模型、256K 上下文与三个架构升级
TL;DR Qwen3-VL 是 Qwen 系列目前最强的视觉-语言模型家族[1]:稠密端有 2B/4B/8B/32B 四档,MoE 端有 30B-A3B 和 235B-A22B 两档,全部开源(Apache-2.0)。它有三个核心卖点:第一,纯文本能力没有被视觉训练拖垮,235B-A22B 的 Instruct 版在 AIME-25、HMMT-25、LiveCodeBench 等文本推理上甚至高于自家纯文本版;第二,原生 256K 交错上下文(文本、图像、视频可以任意穿插),配合 YaRN 可外推到约 1M token;第三,多模态推理和 Agent 能力大幅增强——MMMU 80.6(Thinking)、MathVista 85.8、MathVision 74.6、DocVQA 96.5、OCRBench 875/920、OSWorld 38.1、AndroidWorld 62.0(旗舰 Thinking)。架构上是三个改动:interleaved MRoPE(把 t/h/w 的旋转频率均匀交错,修正长视频的位置编码偏差)、DeepStack(把 ViT 三个层级的多级视觉 token 用残差注入 LLM 前三层)、文本时间戳(用
<3.0 seconds>这类文本 token 代替基于绝对时间的位置编码)。评测里最亮眼的是长视频 needle-in-a-haystack:30 分钟内 100%,外推到 1M token(约 2 小时)仍有 99.5%。不过报告也有值得注意的口径问题:OSWorld 并非第一(Claude-Opus-4 44.4 高于 38.1)、视频基准落后 Gemini/GPT-5、纯文本基线对比存在版本差异,而且报告没有单独的局限/安全章节。
- 论文:Qwen3-VL Technical Report,Qwen Team(Shuai Bai、Yuxuan Cai、Ruizhe Chen 等),2025 年 11 月 26 日(v2 11 月 27 日)。
- 代码与权重:github.com/QwenLM/Qwen3-VL(Apache-2.0);Hugging Face 模型合集;ModelScope;Demo;Qwen Chat。
- 前作 / 预备知识:Qwen2.5-VL[2]、Qwen2-VL 的 MRoPE[3]、Qwen3 纯文本骨干[4];站内可以对照看 Transformer 交互解读。
读前 3 分钟:小白名词表(可跳过)
这篇报告术语密度很高。下面按「模型结构 → 训练方法 → 任务评测 → 工程部署」分四组,每个词给一句人话 + 一个类比。第一次读可以先只记「先记住 5 个」,后面的遇到再回来查。
先记住 5 个
- Token(词元):模型读写的最小单位。文字 token 约等于一个词或半个词;视觉 token 是把图片切成小方格后压缩成的向量。模型眼里没有「图片」,只有一串 token。
- 视觉编码器(vision encoder):模型的「眼睛」,把图变成特征;Qwen3-VL 用的是 SigLIP-2。
- LLM(语言模型):模型的「大脑」,负责推理和生成;Qwen3-VL 的大脑是 Qwen3。
- Merger / projector(投影层):眼睛和大脑之间的「翻译官」,把视觉特征翻译成大脑能读的 token 维度。
- 上下文(context):模型一次能看的 token 上限,相当于「短期工作记忆」;Qwen3-VL 是 256K。
A. 模型结构
| 名词 | 一句话解释 | 类比 |
|---|---|---|
| B(Billion) | 十亿参数;2B = 20 亿参数,235B = 2350 亿 | 按「亿」数人头 |
| 稠密模型(Dense) | 每次推理所有参数都参与计算;2B/4B/8B/32B 都是稠密模型 | 全公司每天全员上班 |
| MoE(专家混合) | 总参数很多(很多专家),但每个 token 只激活一小部分;30B-A3B = 总 30B、激活 3B | 专家池,每次只叫相关几位开会 |
| 总参数 / 激活参数 | 仓库里存了多少 / 一次前向实际用了多少 | 员工总数 / 每次上班人数 |
| VLM(视觉-语言模型) | 能同时读文字和图像的模型 | 既能读字又能看图的大脑 |
| 视觉编码器 / ViT | 把图切 patch、编码成特征的网络;ViT = Vision Transformer | 眼睛 + 视网膜 |
| Patch(图块) | 图片被切成的小方块(常见 14×14 / 16×16 像素) | 把照片剪成邮票大小 |
| 视觉 token | patch 编码/2×2 合并后的向量,约 28×28 像素一个 | 每个小方块浓缩成一句话 |
| Merger / projector | 两层 MLP,把视觉特征投到 LLM 隐藏维度 | 翻译官 |
| LLM(大语言模型) | 负责理解、推理、生成文字的 Transformer 骨干 | 大脑 |
| DeepStack | 把 ViT 多个层级的特征注入 LLM 前三层,不增加上下文长度 | 给大脑同时看原图、草稿和总结 |
| RoPE / MRoPE | 给 token 加「位置坐标」的编码;MRoPE 把时间、水平、垂直三个轴都编码 | 给每个 token 发座位号,三维版 |
| Attention(注意力) | Transformer 里让 token 互相「看」的机制 | 开会时谁看谁、听谁的 |
| 上下文长度 | 一次能处理的 token 上限(256K ≈ 一本长书或几小时视频) | 短期工作记忆容量 |
B. 训练方法
| 名词 | 一句话解释 | 类比 |
|---|---|---|
| 预训练(pre-training) | 用海量数据先学通用能力(Qwen3-VL 分 S0–S3 四阶段) | 上学前先广泛阅读 |
| SFT(监督微调) | 用「问题 + 标准答案」教模型模仿 | 老师给标准答案,学生照着练 |
| Long-CoT(长链式思考) | 训练模型写详细解题步骤,而不是只给答案 | 数学题要求写过程 |
| 蒸馏(distillation) | 用强模型教弱模型(2B/4B/8B 用了强到弱蒸馏) | 学霸把思路教给学弟 |
| RL(强化学习) | 模型自己生成答案,答对给奖励、答错没奖励,逐步学出更好的策略 | 打游戏刷分 |
| Cold start(冷启动) | 正式 RL 前先用一批好数据让模型「上道」 | 先看教学视频再上场 |
| Instruct vs Thinking | 两套权重:Instruct 直接答;Thinking 先写长推理再答 | 抢答 vs 打草稿 |
| Judge / reward model | 用另一个模型给回答打分,作为训练信号 | 阅卷老师 |
C. 任务与评测
| 名词 | 一句话解释 | 类比 |
|---|---|---|
| VQA(视觉问答) | 看图回答问题 | 看图说话考试 |
| OCR(光学字符识别) | 从图片里读出文字(文档、截图、路牌) | 认字 |
| Grounding(视觉定位) | 把文字描述对应到图片中的位置/框 | 「指哪打哪」 |
| Agent(智能体) | 会自己调用工具、操作界面的模型;GUI Agent 操作电脑/手机 | 会自己动手的助手 |
| Benchmark(基准) | 统一考试,用来横向比较模型 | 高考 / 模拟考 |
| MMMU / MMMU-Pro | 大学级别多学科多模态推理考试 | 多学科综合卷 |
| MathVista / MathVision | 视觉数学推理基准 | 带图的数学题 |
| OCRBench / DocVQA | OCR 认字 / 文档问答基准 | 认字考试 / 阅读理解 |
| OSWorld / AndroidWorld | 真实电脑 / 安卓环境里的操作任务基准 | 电脑 / 手机操作考试 |
| NIAH(大海捞针) | 在长文本/长视频里找一条特定信息 | 大海捞针 |
| SOTA(State-of-the-Art) | 当前最好水平 | 排行榜第一 |
D. 工程与部署
| 名词 | 一句话解释 | 类比 |
|---|---|---|
| Token 预算 | 一次输入允许用多少 token;图片/视频要主动压 | 行李箱容量有限,得取舍 |
| 原生分辨率 | 图片按原尺寸切块,不强制缩放到固定大小 | 不压缩原图,细节多但更贵 |
| fps(帧率) | 视频每秒抽几帧;越高越细也越贵 | 视频「翻页」速度 |
| YaRN | 把上下文窗口拉长的位置编码外推方法(256K → 1M) | 给工作记忆扩容的插件 |
| BF16 / 量化 | 用 16 位浮点或更低精度存权重,省显存 | 压缩文件省空间 |
| vLLM / SGLang | 高性能推理服务器,负责批量、缓存、吞吐 | 餐厅的传菜系统 |
| 权重 / checkpoint | 训练好的参数文件;一个模型可能有多个 checkpoint | 游戏存档 |
| Apache-2.0 | 宽松开源许可证,允许商用/修改,需保留声明 | 开源协议的一种 |
怎么读这篇
- 只想懂结论:TL;DR → 6.1 旗舰对比 → 七、局限;
- 想懂原理:二、模型家族 → 三、架构(配交互部件)→ 四/五、训练;
- 想动手:直接跳到九、上手(代码都折叠了,点开即用)。
一、动机:VLM 的三条战线
Qwen2.5-VL 之后,视觉-语言模型(VLM)的竞争基本集中在三条战线上,Qwen3-VL 的报告也是按这三条来组织的:
- 纯文本能力不能退化。 多模态训练很容易「冲掉」语言模型的推理、代码、指令跟随能力;一个 VLM 如果只会看图,文本 benchmarks 掉一大截,实际产品里就不可用。报告把「强纯文本」列为核心支柱,并给出与 Qwen3 纯文本骨干的逐项对比。
- 上下文要长到能装下真实输入。 一本 PDF 教材、一份几十页的合同、两小时的长视频,不再是「截几张图」能解决的。Qwen3-VL 原生支持 256K token 的交错序列(文本 + 图像 + 视频任意穿插),并可通过 YaRN 外推到约 1M。
- 从「看懂」到「行动」。 除了 MMMU/MathVista 这类静态推理,报告花了很大篇幅在 GUI Agent(ScreenSpot、OSWorld、AndroidWorld)、视觉编程(Design2Code、ChartMimic)、工具调用(V*、HRBench)和 3D/具身空间理解上。
和前代相比,这代的关键词是家族化:从 2B 的端侧模型到 235B-A22B 的旗舰 MoE,六个尺寸共享同一套架构、数据管线和训练配方,只是宽度、深度和专家数不同。这比单发一个旗舰模型更考验工程一致性——后面评测里能看到,小模型并不是「旗舰的缩小版」,它们的强项分布有明显差异。
二、模型家族:六个尺寸,两种架构
Qwen3-VL 的完整家族是:
| 模型 | 架构 | 总参数 / 激活参数 | 定位 | 典型场景 |
|---|---|---|---|---|
| Qwen3-VL-2B | 稠密 | 2B / 2B | 端侧、最低延迟 | 边缘设备、简单 OCR/问答 |
| Qwen3-VL-4B | 稠密 | 4B / 4B | 端侧/轻量 | 移动端、嵌入式 |
| Qwen3-VL-8B | 稠密 | 8B / 8B | 单卡部署 | 本地服务、中等负载 |
| Qwen3-VL-32B | 稠密 | 32B / 32B | 单机多卡、能力/成本平衡 | 企业私有部署、复杂 Agent |
| Qwen3-VL-30B-A3B | MoE | 30B / 3B | 高吞吐、低激活成本 | 高并发服务 |
| Qwen3-VL-235B-A22B | MoE | 235B / 22B | 旗舰 | 最强推理、Agent、长文档/长视频 |
每个尺寸都有 Instruct 和 Thinking 两个版本:Instruct 直接回答,适合低延迟交互;Thinking 先生成长链推理再回答,适合数学、科学、复杂 Agent 任务。报告的一个反直觉发现是:不是所有任务都该开 Thinking——比如 RealWorldQA 上 32B-Instruct(79.0)反而高于 32B-Thinking(78.4),OSWorld 也是 32B 的 41.0 高于旗舰 Thinking 的 38.1(后面会细说)。
下面这个部件可以切换六个模型,看它们在三个代表性指标上的位置(数据来自报告表 2–4):
一个容易被忽略的细节:同一代模型里,OSWorld 最高的是 32B(41.0),不是 235B(38.1)。这说明 GUI Agent 能力对训练数据配比、RL 阶段、甚至推理步数都很敏感,不是简单堆参数就能线性提升的。报告也承认在线 Agent 评测的复现成本很高。
三、架构:三个升级
Qwen3-VL 沿用 Qwen2.5-VL 的三模块结构:视觉编码器 + MLP merger + Qwen3 语言模型,但在三个位置做了改动。先看整体:
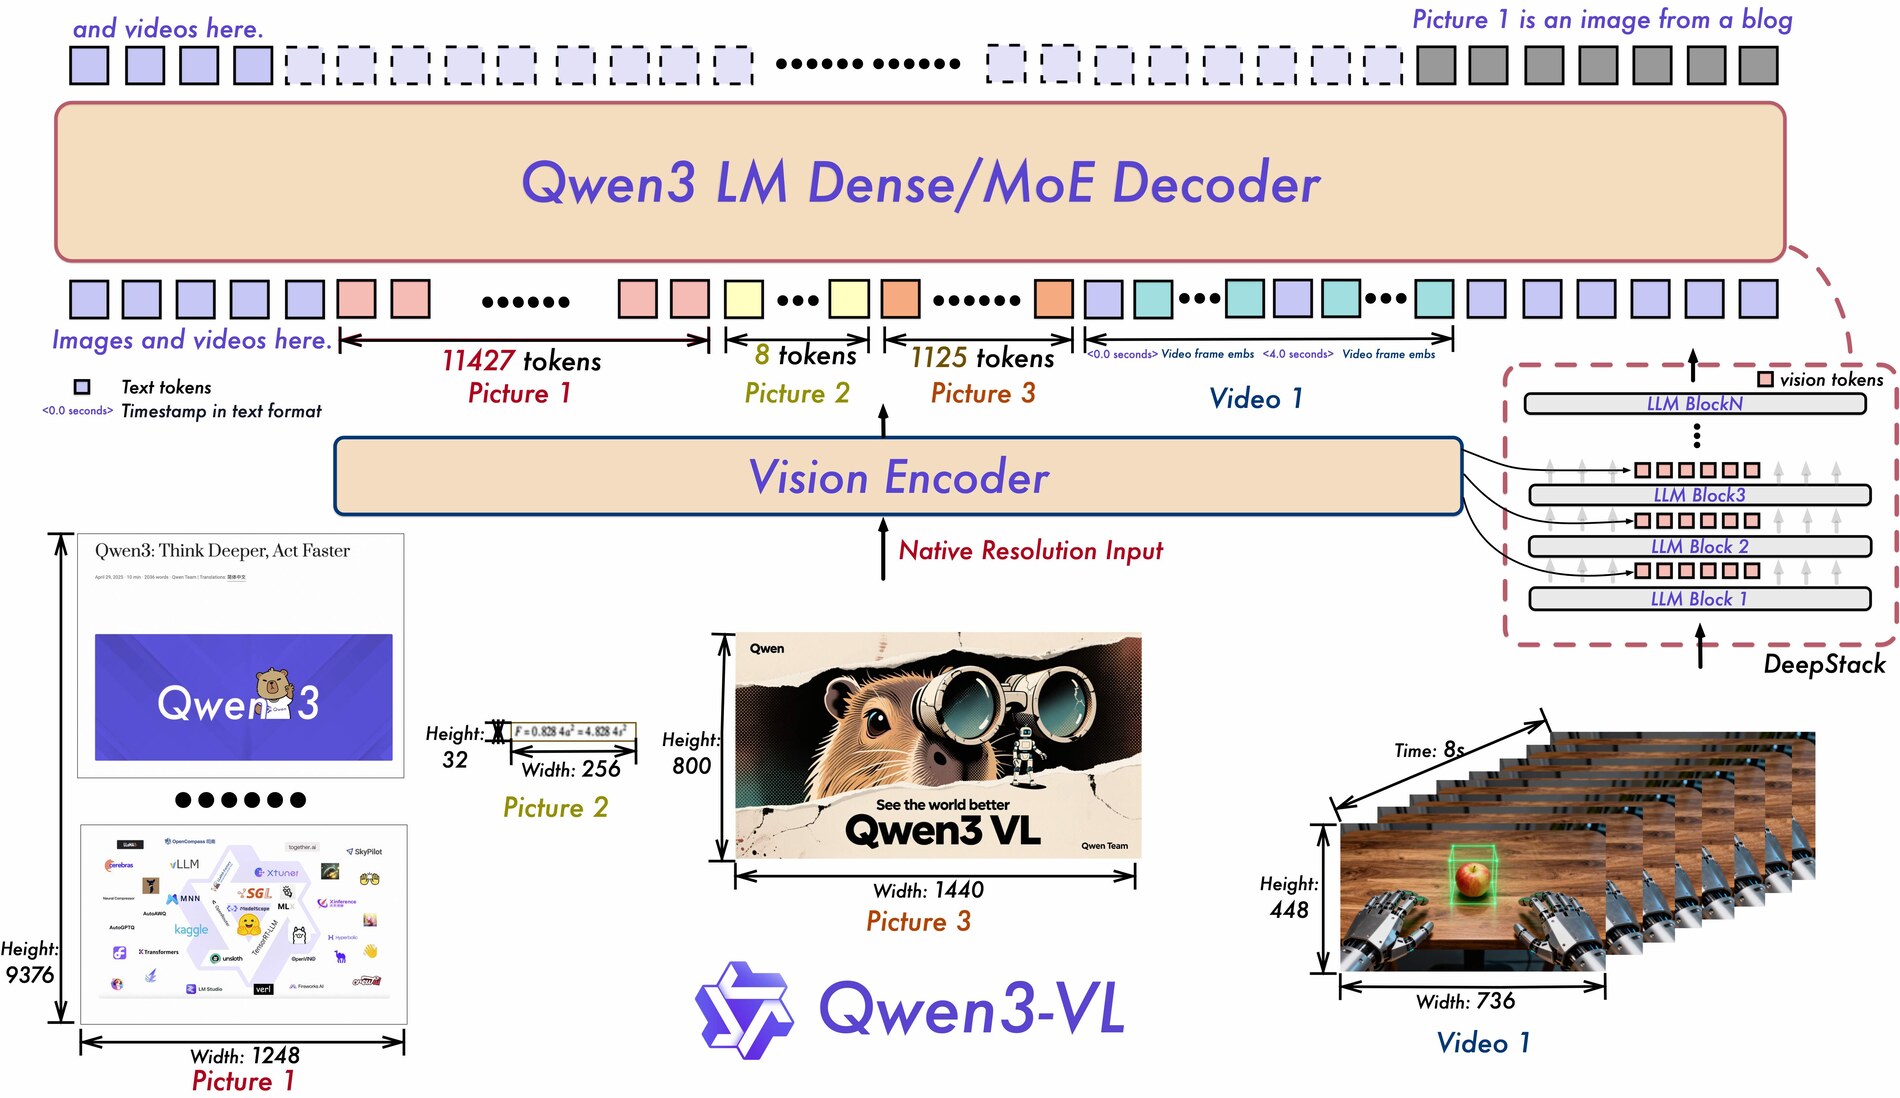
<0.0 seconds> 这类文本时间戳。图里的 token 数示例很直观:一张 1248×9376 的长图约 11427 个 token,一张小图 8 个 token,一张 800×1440 的图约 1125 个 token,8 秒视频(448×736)也约 1125 个 token。3.1 视觉编码器与 tokenizer
视觉编码器用 SigLIP-2 架构[5](默认 SigLIP2-SO-400M;2B/4B 小模型用 SigLIP2-Large 300M),从官方预训练权重出发继续训练,支持动态分辨率。为了在任意分辨率下保持位置编码合理,它用了 2D-RoPE 加按输入尺寸插值的绝对位置 embedding,思路跟 CoMP[6] 一致。视觉 token 的压缩方式和 Qwen2.5-VL 一样:2×2 的相邻 patch 经两层 MLP 压成一个 token,与 LLM 的 hidden 维度对齐;DeepStack 用的多级特征则走各自专用的 merger。
这里有两个工程上的取舍值得记:第一,原生分辨率意味着 token 数随图片尺寸增长,长图/高分辨率截图会非常贵(图 1 里 1248×9376 的图就要 11427 token),所以实际使用中要配合 max_pixels/total_pixels 限制;第二,2×2 merge 的压缩率是固定的,细粒度 OCR 和小字识别靠的是高分辨率输入 + 多级特征(DeepStack)来补,而不是靠更小的 patch。
3.2 Interleaved MRoPE:修正位置编码的频率偏差
Qwen2-VL 引入的 MRoPE 把 embedding 维度分成时间(t)、水平(h)、垂直(w)三组,各自分配不同的旋转频率[3]。问题是分组之后频率谱不平衡:某些轴集中了高频、某些轴集中了低频,长视频上会出现明显的谱偏差(spectral bias),影响长程位置建模。
Qwen3-VL 的做法是交错(interleaved)分配:把 t、h、w 三个分量交错地铺到 embedding 维度上,让每个时空轴在低频段和高频段都有均匀表示:
(这里是概念示意,实际是按频率段交错分配,不是简单的逐维循环。)这样每个轴都能同时拿到低频(长程、全局)和高频(局部、细节)信息,长视频的位置外推更稳。这个改动本身很小,但它属于那种「不改架构、只改位置编码」的高杠杆修改。
3.3 DeepStack:把多级视觉特征注入 LLM 前三层
DeepStack[7] 的思想是:不要只把 ViT 最后一层的特征喂给 LLM,而是把多个层级的视觉特征都送进去。原始 DeepStack 用的是多尺度输入;Qwen3-VL 把它改成从 ViT 的中间层取特征:
- 从视觉编码器的三个不同层级取特征(低层保留边缘/纹理,中层保留局部结构,高层保留语义);
- 每个层级用专门的 vision-language merger 投影成视觉 token;
- 这些 token 直接加到 LLM 前三层的 hidden state 上(残差式注入),不增加上下文长度。
这相当于在 LLM 的最前面几层就注入「多尺度的视觉细节」,让后面的语言层在早期就能同时看到细粒度纹理和高层语义。报告在内部 15B-A2B 模型上做了 200B token 的预训练消融:加 DeepStack 后平均分从 74.7 涨到 76.0,AI2D 81.8→83.2、OCRB 81.0→83.6、InfoVQA 71.9→74.2、ChartQA 81.5→83.3、DocVQA 89.5→91.1、MMMU 52.9→54.1、MMStar 55.5→57.7。收益最大的是文档/信息图/图表这类需要细粒度视觉的任务,符合「多级特征补细节」的直觉。
3.4 文本时间戳:用文本 token 代替绝对时间位置
Qwen2.5-VL 用「时间同步的 MRoPE」来给视频帧时间感:把时间位置 ID 直接绑到绝对时间。报告指出两个问题:一是长视频会产生过大且稀疏的时间位置 ID,反而损害长程理解;二是要让模型学会这种编码,需要在各种 fps 上做大量均匀采样,数据构造成本高。
Qwen3-VL 改用文本时间戳(借鉴 TimeMarker[8] 一类的做法):每个视频时间 patch 前面插入一个格式化的文本 token,例如 <3.0 seconds>;训练时同时生成「秒」和「HMS(时:分:秒)」两种格式,让模型学会读不同的时间码。代价是上下文长度略微增加,但好处是时间信息对模型来说变成「可直接读的 token」,而不是隐式的位置编码——这对视频 grounding、dense captioning 这类需要精确时间定位的任务更友好。
3.5 损失:平方根归一化的 per-token loss
报告还提到一个优化细节:从「按样本平均的 loss」改成按 token 平方根归一化的 per-token loss,以平衡文本和 multimodal 数据的贡献。这个改动不出现在架构图里,但对「视觉训练不冲垮文本能力」很关键——文本样本通常长、多模态样本 token 数差异大,按样本平均会让某一类数据主导梯度。
下面这个部件把三个架构升级做成交互式图解。点按钮切换,看每个改动到底改了什么:
三个改动各有分工:MRoPE 管位置、DeepStack 管细节、文本时间戳管时间,共同服务于「长视频 + 高分辨率 + 多图交错」这三个 Qwen3-VL 最想打的场景。再加上损失函数的平方根归一化,它们合起来解释了为什么这代模型能在长上下文和 OCR 上同时进步。
四、预训练:四阶段,从「对齐」到 256K
Qwen3-VL 的预训练分四个阶段,核心思路是先对齐、再扩上下文:
| 阶段 | 目标 | 可训练部分 | 预算 / 序列长度 |
|---|---|---|---|
| S0 | 视觉-语言对齐 | 只训 MLP merger(ViT 与 LLM 冻结) | 67B / 8,192 |
| S1 | 多模态预训练 | 全部参数 | ~1T / 8,192 |
| S2 | 长上下文预训练 | 全部参数 | ~1T / 32,768 |
| S3 | 超长上下文适配 | 全部参数 | 100B / 262,144 |
几个值得注意的设计:
- S0 只训 merger:用 67B 的高质量图文对、视觉知识和 OCR 数据把模态对齐做好,再解锁全参数训练。这是 Qwen2.5-VL 就验证过的配方,能避免早期视觉噪声破坏语言骨干。
- S1 的 1T token 里混了纯文本:报告明确说为了维持语言能力,数据混合包含 VL 数据 + text-only 数据。VL 部分包括交错图文文档、视觉 grounding、VQA、STEM 和少量视频。
- S2 把序列拉到 32K,并加大视频/Agent 数据:同时提高纯文本比例以支撑长文本理解。这一步是长上下文能力的真正来源。
- S3 只花 100B token 适配 262K:数据以长视频和长文档为主。也就是说,「256K 原生」不是从头用 256K 训练出来的,而是先短后长、最后专门适配。
数据侧,报告按能力维度组织了一个很大的体系:caption / 交错图文、知识、OCR / 文档解析 / 长文档、grounding / counting、空间与 3D 识别、视频、STEM、Agent。相对 Qwen2.5-VL 的升级点包括:更强的 caption 监督、更大的 omni-recognition / OCR 覆盖(39 种语言)、带 3D/空间推理的归一化 grounding、代码与长文档语料、带时间戳的视频语料,以及高质量的 GUI Agent 交互轨迹。
一个常被忽略的细节是纯文本数据的角色:多模态预训练如果只喂图文,语言能力会退化的。Qwen3-VL 在 S1/S2/S3 都保留 text-only 数据,并且在 SFT 阶段把 1/3 的样本留给纯文本。这条「不冲掉语言能力」的工程纪律,是它能在文本 benchmarks 上和 Qwen3 打平甚至反超的前提。
五、后训练:SFT、蒸馏、RL、Thinking with Images
后训练分三块:监督微调、强到弱蒸馏、强化学习;在此之上还有一个专门的 Thinking with Images 训练阶段。
Cold-start SFT。 约 120 万条样本,1/3 纯文本、2/3 图文/视频对,覆盖单图、多图、交错图文、多轮对话、工具增强的图像搜索等。长上下文用两阶段课程:先 32K 训一个 epoch,再用完整 256K 训第二个 epoch,混入长文档、整本教材和最长两小时的视频。数据清洗走「Query Filtering + Response Filtering」两阶段,其中 response 过滤同时用规则和 Qwen2.5-VL 奖励模型。
Long-CoT cold start。 Thinking 模型的冷启动数据要求「难」且「真的需要视觉」:只保留 baseline 通过率低或回答更长的题;对视觉数学题,先用 Qwen3-30B-nothink 在去掉图像的情况下做一遍,能做对的题直接丢掉——确保留下来的题非看图不可。纯文本与视觉样本约 1:1,视觉侧重点在 STEM 和 Agent。
Strong-to-Weak Distillation。 轻量模型(2B/4B/8B)通过从强模型蒸馏得到,报告说是 Qwen3 配方的一部分。这也解释了为什么 2B/4B 在 MMMU 上能到 61.4/70.8,远高于同尺寸的纯文本 VLM 基线。
强化学习。 分两条线:Reasoning RL 针对数学/科学/代码这类可验证任务;General RL 针对指令跟随、格式、语言混用等「行为问题」,用规则奖励(可验证格式/答案)+ 模型奖励(Qwen2.5-VL-72B 或 Qwen3 做 judge)的混合信号。报告特别提到,通用 RL 里会专门构造「容易诱发坏行为」的 prompt 集,做高频惩罚,比在通用数据里广撒网更有效。
Thinking with Images。 这是让模型「边看边想、边调用工具」的两阶段训练:第一阶段用约 10k 条 grounding 冷启动数据,在 Qwen2.5-VL-32B 上 SFT 出「思考 → 调工具 → 看反馈 → 回答」的视觉 Agent;再做多轮、工具集成的 RL。第二阶段把第一阶段的 Agent 蒸馏成约 120k 条多轮交互数据,用同样的冷启动 + RL 管线训练 Qwen3-VL。RL 用三个奖励:答案准确率、多轮推理质量(是否正确理解工具反馈)、工具调用次数(与专家估计的目标次数比较)。报告提到一个很实际的问题:模型会退化成「只调一次工具」来 hack 前两个奖励,所以必须加工具调用奖励。
基础设施。 预训练跑在阿里云 PAI-Lingjun 上,Megatron-LM 混合并行(TP + PP + CP + EP + ZeRO-1 DP),规模到 10,000 张 GPU;部署侧用 vLLM(PagedAttention)或 SGLang(结构化生成)。这意味着官方不是只发权重,也给了「怎么大规模服务」的工程参考。
六、评测:哪些赢了,哪些没赢
6.1 旗舰对比:不是全面 SOTA,但强项很突出
先看原文头图的雷达对比(左 Instruct、右 Thinking,对比 Gemini-2.5-Pro、GPT-5、Claude Opus 4.1 等):
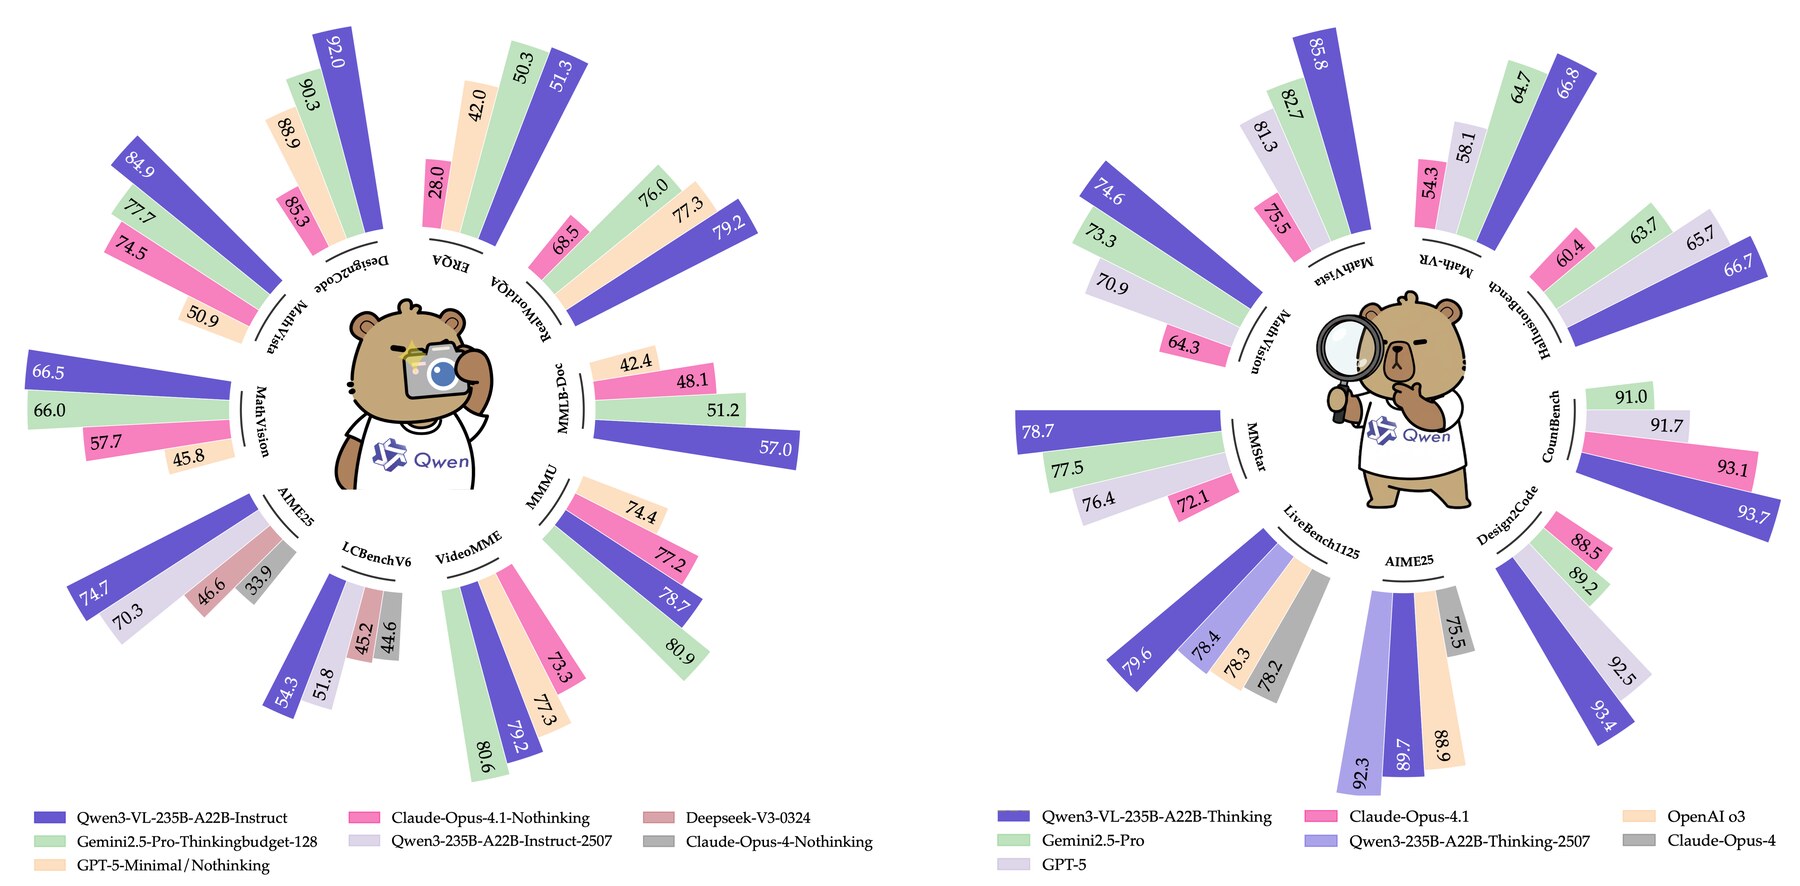 原文头图:左为 Instruct 模式,右为 Thinking 模式。Qwen3-VL-235B-A22B 在 MathVista、MathVision、MMStar、OCR、ChartQA 等轴上明显领先;在 MMMU、MMMU-Pro、Video-MME 等轴上略低于 GPT-5 或 Gemini-2.5-Pro。雷达图看趋势可以,精确排名还是要回表格。
评测覆盖 MMMU[9]、MMMU-Pro[10]、MathVista[11]、OCRBench[12]、DocVQA[13]、OSWorld[14]、AndroidWorld[15]、Video-MME[16] 等基准。
把关键数字摘出来(Instruct / Thinking,对比 GPT-5 high、Gemini-2.5-Pro Thinking、Claude Opus 4.1):
| 基准 | Qwen3-VL-I | Qwen3-VL-T | GPT-5 | Gemini 2.5 Pro | Claude 4.1 |
|---|---|---|---|---|---|
| MMMU | 78.7 | 80.6 | 84.2 | 81.7 | 78.4 |
| MMMU-Pro | 68.1 | 69.3 | 78.4 | 68.8 | 64.8 |
| MathVista | 84.9 | 85.8 | 81.3 | 82.7 | 75.5 |
| MathVision | 66.5 | 74.6 | 70.9 | 73.3 | 64.3 |
| DocVQA | 97.1 | 96.5 | 91.5 | 92.6 | 92.5 |
| OCRBench | 920 | 875 | 810 | 866 | 764 |
| MMLongBench-Doc | 57.0 | 56.2 | 51.5 | 55.6 | 54.5 |
| OSWorld | 31.6 | 38.1 | - | - | 44.4(no thinking) |
| AndroidWorld | 63.7 | 62.0 | - | - | - |
| Video-MME | 79.2 | 79.0 | 84.7 | 85.1 | 75.6 |
| MLVU | 84.3 | 83.8 | 86.2 | 85.6 | 73.5 |
| LVBench | 67.7 | 63.6 | - | 73.0 | - |
(表中 I = Instruct,T = Thinking;GPT-5 为 high,Gemini-2.5-Pro 与 Claude-Opus-4.1 为各自的 thinking / 推理设置。)
结论要分两面看:
- 赢的地方:数学(MathVista / MathVision)在开源/闭源里领先,OCR 和文档(DocVQA、OCRBench、CC-OCR、MMLongBench-Doc)大幅领先,MMStar / MMBench 这类通用 VQA 也很有竞争力,AndroidWorld / ScreenSpot Pro 这类 GUI 感知是强项。
- 没赢的地方:MMMU / MMMU-Pro 仍落后 GPT-5,视频基准落后 Gemini-2.5-Pro 和 GPT-5,OSWorld 落后 Claude-Opus-4(44.4 vs 38.1)。报告自己的措辞是「competitive and, in several cases, superior」——不是全面 SOTA,这个定性是准确的。
6.2 纯文本:报告里最值得推敲的一组数字
报告在摘要和引言里说 Qwen3-VL「在多数语言基准上超过纯文本版本」。我核对了表 5/6,结论要谨慎:Instruct 版对 Qwen3-235B-A22B-Instruct-2507 在大部分文本基准上是略低的,比如 MMLU-Pro 81.8 vs 83.0、GPQA 74.3 vs 77.5、MMLU-Redux 92.2 vs 93.1、Arena-Hard 77.4 vs 79.2;Thinking 版对 Thinking-2507 也是 MMLU-Pro 83.8 vs 84.4、GPQA 77.1 vs 81.1、AIME-25 89.7 vs 92.3、HMMT-25 77.4 vs 83.9 略低。确实有一些项反超:Instruct 的 AIME-25(74.7 vs 70.3)、HMMT-25(57.4 vs 55.4)、LiveCodeBench(54.3 vs 51.8),Thinking 的 LiveBench(79.6 vs 78.4)等。
所以更准确的说法是:视觉训练没有显著破坏文本能力,部分推理/代码项甚至更好,但整体仍略低于同代纯文本 2507 版本。报告引言的「majority」表述和表格数字对不上,可能是对比的基线版本不同(比如对原始 Qwen3-235B-A22B 而非 2507),也可能是写作时的口径问题。对做选型的人来说,这个差异值得注意:如果你只需要文本,Qwen3 纯文本版仍然是更强的选择;如果你需要多模态,Qwen3-VL 的文本代价大约在 1–3 分(因基准而异)。
6.3 家族缩放:小模型有多能打?
| 模型 | MMMU(T / I) | OCRBench(T / I) | OSWorld(T) |
|---|---|---|---|
| 2B | 61.4 / 53.4 | 792 / 858 | 19.0 |
| 4B | 70.8 / 67.4 | 808 / 881 | 31.4 |
| 8B | 74.1 / 69.6 | 819 / 896 | 33.9 |
| 32B | 78.1 / 76.0 | 855 / 895 | 41.0 |
| 30B-A3B | 76.0 / 74.2 | 839 / 903 | 30.6 |
| 235B-A22B | 80.6 / 78.7 | 875 / 920 | 38.1 |
(T = Thinking,I = Instruct。)
几个观察:
- 8B 是「小模型大能力」的甜点:MMMU 74.1 已经接近上一代 72B 级模型,OCRBench 896 甚至超过 32B Instruct;报告也提到 8B 在部分视频任务上能追平 Qwen2.5-VL-72B。
- 30B-A3B 的性价比很有意思:只激活 3B 参数,OCRBench 903 比 32B 还高,MMMU 76.0 也不差,但 OSWorld 只有 30.6——说明 MoE 的「知识/OCR」能力强,Agent 类的多步决策能力不一定跟着涨。
- 32B 是 Agent 性价比之王:OSWorld 41.0 是全家族最高,超过旗舰的 38.1;如果做 GUI Agent,32B 可能比 235B 更划算。
- 旗舰赢在长文档/长视频/复杂推理:235B 的 OCRBench 920、MMMU 80.6、MMLongBench-Doc 57.0 都是家族最高,但 OSWorld 不是。
6.4 OCR 与多语言文档
OCR 是这代最明显的长板之一。报告把支持语言从 Qwen2.5-VL 的 10 种扩到 39 种,自建测试集上 32/39 种语言准确率超过 70%(报告认为 70% 是「实际可用」的门槛):
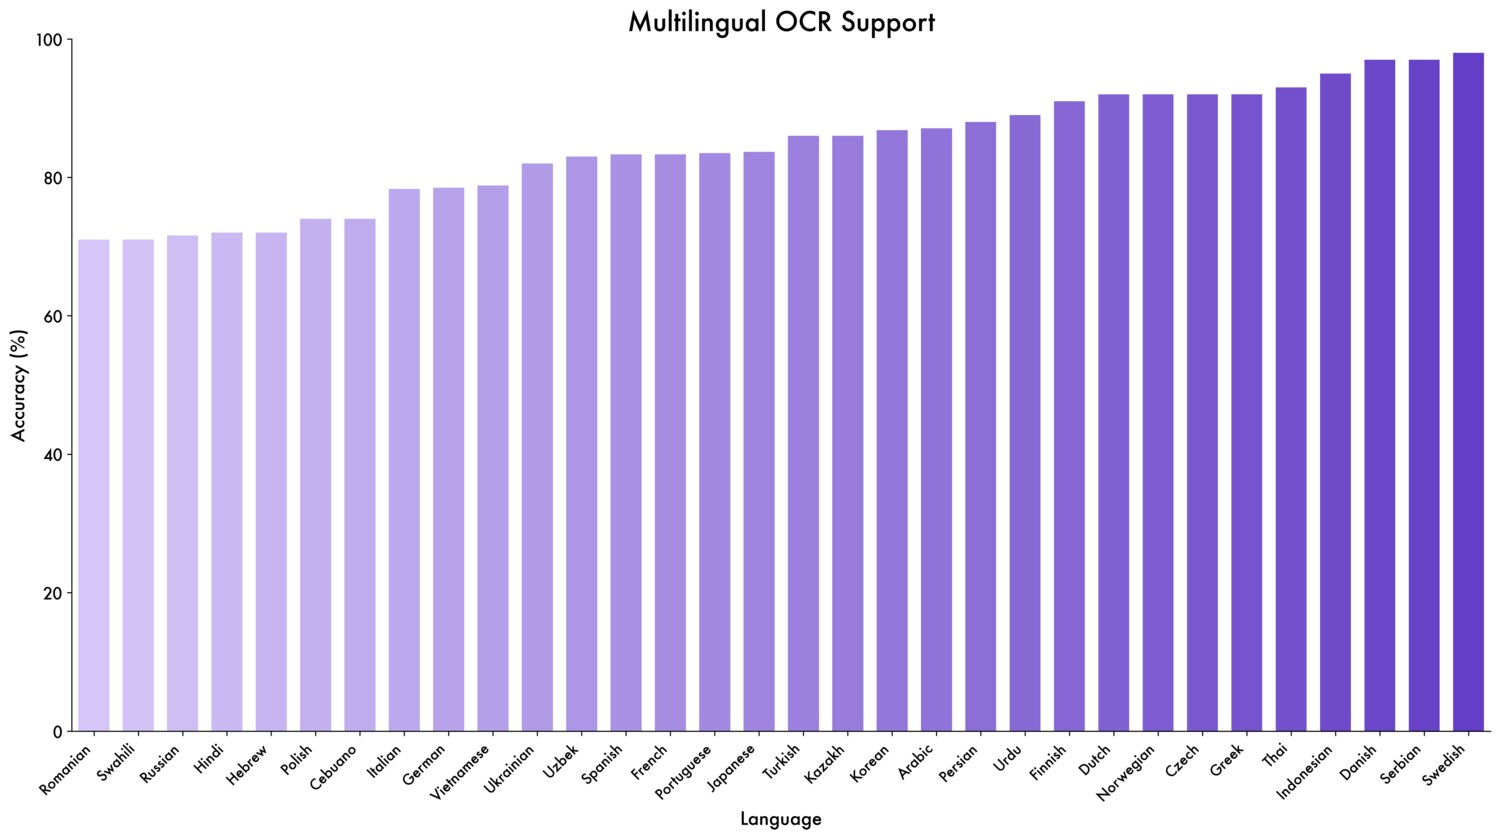 原文 Figure 2:39 种语言的自建 OCR 测试集准确率。罗马尼亚语、斯瓦希里语、俄语、印地语等 7 种语言在 70% 以下;意大利语、德语、越南语等在 75–85%;荷兰语、挪威语、捷克语、希腊语、泰语、印尼语、丹麦语、塞尔维亚语、瑞典语在 90% 以上。
这里有一个口径不一致值得记:报告说支持 39 种、32 种超过 70%;GitHub README 写的是「支持 32 种语言(从 10 种提升)」。 两个数字可能是「支持语言数」和「达到可用门槛的语言数」混用了,引用时最好写「报告测试 39 种、其中 32 种 >70%」,而不是笼统说「支持 32 种」。
文档解析的进步还包括长文档结构(表格、公式、多栏)和 MMLongBench-Doc 57.0(Instruct)/56.2(Thinking),在对比模型里是最高的。这背后是 S3 的 256K 长文档数据和 DeepStack 的多级视觉特征共同作用。
6.5 长上下文与长视频:100% 到 30 分钟,99.5% 到 1M token
长上下文是 Qwen3-VL 最想证明的能力。报告构造了一个视频版 needle-in-a-haystack:在一段长视频的随机位置插入一帧「针」,让模型定位并回答问题,视频按 1 FPS 采样、动态调整分辨率以保持恒定视觉 token 预算:
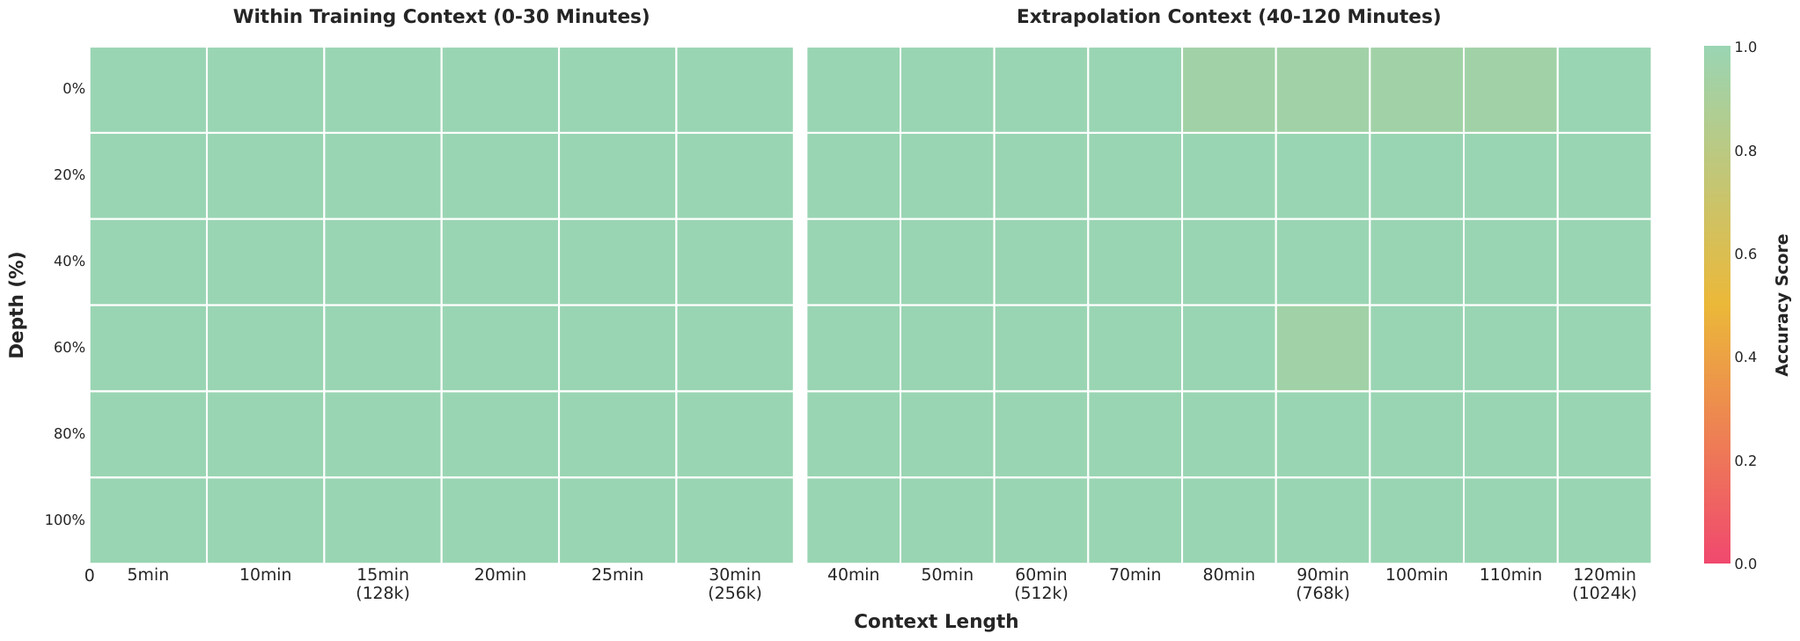 原文 Figure 3:横轴是视频时长(5 分钟到 120 分钟)对应的 token 数(128K→1024K),纵轴是「针」在视频中的深度(0%–100%)。左半部分是训练上下文内(0–30 分钟 / 256K),全部 100%;右半部分是用 YaRN 外推的 40–120 分钟(512K–1024K),仍保持很高准确率,只有 90 分钟、60% 深度附近有一个轻微下降的格子。
报告的结论是:30 分钟内(256K)100%,外推到 1M token(约 2 小时视频)仍有 99.5%。这个数字很漂亮,但要配套看三点:第一,NIAH 只测「找一帧 + 回答」,不等于长视频的复杂推理;第二,外推靠的是 YaRN[17] 位置扩展,不是原生训练;第三,实际部署时 1M token 的显存/延迟成本很高,报告中视频评测也把帧数上限定在 2,048 帧、总 token 不超过 224K。
下面这个滑块把「时长 → token → 准确率」的关系画出来,拖到 120 分钟看外推区:
6.6 Agent、视频与消融
Agent。 GUI 感知很强:ScreenSpot Pro 61.8(Thinking)/62.0(Instruct),OSWorldG 68.3/66.7;在线环境里 32B 的 OSWorld 41.0、AndroidWorld 63.7 是全家族最好。但旗舰的 OSWorld 38.1 低于 Claude-Opus-4 的 44.4,说明「最强多模态模型」不等于「最强电脑操作 Agent」——后者还依赖动作空间、记忆、错误恢复和 RL 环境。
视频。 Qwen3-VL 在 MVBench(75.2/76.5)、MLVU(83.8/84.3)、VideoMMMU(80.0/74.7)上有竞争力,但 Video-MME(79.0/79.2)和 LVBench(63.6/67.7)落后 Gemini-2.5-Pro(85.1 / 73.0)和 GPT-5(84.7)。报告自己也说,视频评测里给 Qwen3-VL 的上限是 2,048 帧,而 Gemini/GPT-5/Claude 分别只用了 512/256/100 帧(受 API 限制),这个对比并不完全公平——但反过来说,即使给更多帧,Qwen3-VL 也没能在这些基准上反超,说明长视频理解不只是「帧数」问题。
消融。 视觉编码器方面,Qwen3-ViT 对比 SigLIP-2:ImageNet-1K 84.6 vs 84.2、ObjectNet 81.0 vs 79.9、Omni 45.5 vs 36.9、OCRB 78.7 vs 77.2;但 ImageNet-S 74.5 vs 76.2 略低。VLM 阶段接同一个 1.7B Qwen3 后,Qwen3-ViT 在 OCRB(78.7 vs 77.2)、AI2D(76.2 vs 74.1)、InfoVQA(67.0 vs 65.3)、Omni(53.0 vs 50.1)上更好。DeepStack 的消融(15B-A2B、200B token 预训练)则是平均 74.7→76.0,文档/图表类收益最大(见 3.3 节)。两项消融都是小规模内部实验,旗舰上的增益没有单独给出,这是报告的一个空白。
七、局限与我的观察
报告本身没有单独的局限(Limitations)或安全/伦理章节,这在技术报告里不罕见,但意味着下面这些问题需要读者自己补:
作者在正文里承认的:
- 视频评测的对比不完全公平:Qwen3-VL 给 2,048 帧,Gemini/GPT-5/Claude 受 API 限制分别只给 512/256/100 帧;部分基线数字来自各自技术报告,不是同环境重跑。
- 在线 Agent 评测(OSWorld / AndroidWorld)复现成本高,受环境、工具、judge 影响大。
- NIAH 只验证「定位 + 回答」,不能代表复杂长视频推理。
- 「多数语言基准超过纯文本版」的表述与表 5/6 的实际数字存在出入(见 6.2)。
- 40–120 分钟的 1M token 能力依赖 YaRN 外推,不是原生训练。
我自己再补几条:
- 纯文本仍有代价。 对同代 Qwen3-2507,Qwen3-VL 在 MMLU-Pro、GPQA、AIME、HMMT 等核心文本基准上普遍低 1–4 分。报告引言的说法更像 marketing,选型时以表 5/6 为准。
- Agent 能力不随规模单调。 32B 的 OSWorld(41.0)高于 235B(38.1),30B-A3B(30.6)也低于 32B。做 GUI Agent 别默认「越大越好」,要在目标环境上实测。
- 评测口径需要统一。 除了视频帧数,OCR 语言数(39 vs README 的 32)、工具使用标记(+)、judge 模型、thinking 预算都不完全一致;跨表比较时要把这些条件带上。
- 长上下文的成本被低估。 一张 1248×9376 的长图就 11,427 token;2 小时视频按 1 FPS + 动态分辨率也能吃满 224K。256K 是「能力」,不是「默认值」;实际服务必须做 token 预算控制(README 的
total_pixels就是干这个的)。 - 数据与安全不透明。 报告没有给各数据类别的 token 数/来源/许可证,SFT 过滤用 Qwen2.5-VL 当 judge(存在 self-preference 风险);没有 red-teaming、越狱、偏见评测。开源权重是 Apache-2.0,但训练数据和完整配方没有开放。
- 消融规模偏小。 ViT 消融用 1.7B LM、DeepStack 用 15B-A2B/200B token,不能直接外推到 235B 旗舰;「Qwen3-ViT 比 SigLIP-2 好」在旗舰上是否成立,报告没有给全尺寸证据。
- 统一理解-生成还没做。 结论里把「unified understanding-generation」列为未来工作,这一代仍然只做理解(+ 视觉编程的输出是代码/HTML,不是图像生成)。
八、结论
Qwen3-VL 的定位很清晰:它不是「一个更强的 VLM」,而是一套覆盖端侧到云端的多模态基础模型家族,用三个架构改动(interleaved MRoPE、DeepStack、文本时间戳)解决长视频/高分辨率/时间定位,用四阶段预训练 + 三阶段后训练把「强文本 + 长上下文 + 多模态推理 + Agent」塞进同一套配方,再用六个尺寸覆盖不同部署预算。
如果只带走三件事:
- 选型看任务,不看参数。 端侧 2B/4B、单卡 8B、Agent 性价比 32B、高吞吐 30B-A3B、长文档/长视频旗舰 235B-A22B;Thinking 不是万能的(RealWorldQA、OSWorld 都有 Instruct 更好的例子)。
- 长上下文是「能力 + 成本」的组合。 256K 原生、1M 靠 YaRN;真实使用要做 token 预算,别默认把整本书/整段视频塞进去。
- 它的强项是 OCR/文档/数学/GUI 感知,弱项是 MMMU 级专家推理、长视频语义理解、电脑操作 Agent 的绝对 SOTA。 报告的数字支持「第一梯队」,不支持「全面最强」。
九、上手:给 VL 新手的 step-by-step
这一节按「先建立直觉、再跑通代码、最后会选型」的顺序写。你不需要先读完论文才能上手;下面的每一步都对应论文里的一个概念,跑完再回头看第三节(架构)会顺很多。
9.1 先建立三个直觉
直觉一:一张图 ≈ 一堆「视觉 token」。 VLM 不是把整张图塞进神经网络,而是把图切成小 patch,再压成 token,和文字 token 拼在同一条序列里。Qwen3-VL 的视觉 token 大约是 28×28 像素一个(ViT patch 经 2×2 merge;不同版本会有差异),所以一张图/一段视频的 token 数主要由分辨率决定:图 1 里 1248×9376 的长图约 11,427 个 token,一张 800×1440 的图约 1,125 个 token,一张小图只有 8 个 token。这就是为什么「原生分辨率」既强又贵。
直觉二:VLM = 视觉编码器 + 投影层(merger)+ 语言模型。 视觉编码器(Qwen3-VL 用 SigLIP-2)把图变成特征;merger 把特征投到语言模型的 hidden 维度;语言模型把「图像 token + 文字 token」当成一条序列来续写。Qwen3-VL 的 DeepStack 只是把「更多层的视觉特征」也送到语言模型前面几层,不改变你写代码的方式;interleaved MRoPE 和文本时间戳也都是内置在权重里的,没有需要你手动调的开关。
直觉三:Instruct 和 Thinking 是两套权重、两种推理方式。 同一尺寸有 -Instruct 和 -Thinking 两个模型:Instruct 直接回答,适合低延迟;Thinking 先生成长链推理再回答,适合数学/科学/复杂 Agent。Thinking 的「思考长度」由 max_new_tokens 控制(官方在 AIME/HMMT/LiveCodeBench 上给到 80K token 的思考空间)。它们不是同一个模型加个参数,要分别下载。
9.2 Step 0:环境准备
先估一下显存(BF16 推理,实际还会更高):
| 模型 | 大致显存 | 适合场景 |
|---|---|---|
| 2B / 4B | 6–12 GB | 笔记本/端侧、简单 OCR/问答 |
| 8B | 20–24 GB | 单卡 4090/5090、本地服务 |
| 32B | 70–80 GB(单机多卡) | 企业私有部署、复杂任务 |
| 30B-A3B | 70–80 GB | 高并发、MoE 推理 |
| 235B-A22B | 多机多卡 | 旗舰效果、长文档/长视频 |
安装命令(Python 3.10–3.12 + transformers 4.57)
# 建议用 Python 3.10–3.12 的干净环境
python -m venv .venv && source .venv/bin/activate
pip install -U pip
pip install "transformers>=4.57.0" qwen-vl-utils==0.0.14 accelerate
# 多图/视频/长上下文建议装 FlashAttention-2(可选,但很值)
pip install flash-attn --no-build-isolation
国内用户建议用 ModelScope 下载权重(snapshot_download),Hugging Face 也能直连;两个源的文件是一致的。
9.3 Step 1:跑通「一张图 + 一句话」
先用 8B-Instruct 跑最简单的一条链路,把每一步对应到论文概念:
最小示例:一张图 + 一句话(8B-Instruct)
import torch
from transformers import AutoModelForImageTextToText, AutoProcessor

model_id = "Qwen/Qwen3-VL-8B-Instruct"          # 8B 稠密 + SigLIP2 视觉塔
model = AutoModelForImageTextToText.from_pretrained(
    model_id, dtype=torch.bfloat16, device_map="auto"
)
processor = AutoProcessor.from_pretrained(model_id)  # 2×2 patch merge 在 processor 里

messages = [{
    "role": "user",
    "content": [
        # ① 图片:换成你自己的图片路径或 URL
        {"type": "image", "image": "demo.jpeg",
         "max_pixels": 1024 * 28 * 28},           # ② token 预算:限制最大分辨率
        # ③ 文字:和图片 token 拼成同一条 256K 序列
        {"type": "text", "text": "用中文描述这张图片,并指出画面里有哪些物体。"},
    ],
}]

inputs = processor.apply_chat_template(
    messages, tokenize=True, add_generation_prompt=True,
    return_dict=True, return_tensors="pt",
).to(model.device)

with torch.no_grad():
    out = model.generate(**inputs, max_new_tokens=256)

print(processor.batch_decode(out[:, inputs.input_ids.shape[1]:],
skip_special_tokens=True)[0])跑通之后观察两件事:输出是否正常、inputs.input_ids.shape 是多少(这个数字就是这张图 + 问题占用的 token 数)。把 max_pixels 改小(比如 512*28*28),token 数会降、细节 OCR 可能变差——这就是后面所有 trade-off 的起点。
9.4 Step 2:多图与交错上下文
VLM 的「交错」不是神秘功能,就是 content 列表里按顺序放多张图和多段文字:
多图 / 交错上下文示例
messages = [{
    "role": "user",
    "content": [
        {"type": "image", "image": "before.jpg", "max_pixels": 768 * 28 * 28},
        {"type": "text", "text": "这是改造前的厨房。"},
        {"type": "image", "image": "after.jpg", "max_pixels": 768 * 28 * 28},
        {"type": "text", "text": "这是改造后的厨房。请指出三处主要变化。"},
    ],
}]
图片顺序、文字位置都由你控制;模型看到的就是「图 A → 文字 → 图 B → 文字」这一条 token 序列。多图时总 token 会叠加,建议一开始把每张图的 max_pixels 调小,确认能跑通再逐步放大。
9.5 Step 3:视频(fps、帧数、时间戳)
视频本质上是「一串按时间排列的帧 + 时间戳」。Qwen3-VL 在内部用文本时间戳(<3.0 seconds>)标记帧组,你只需要控制采样率和总 token 预算:
视频输入示例(fps + token 预算)
messages = [{
    "role": "user",
    "content": [
        {"type": "video", "video": "file:///path/to/video.mp4",
         "fps": 1.0,                 # 每秒采 1 帧;越高越细,也越贵
         "max_pixels": 256 * 28 * 28,   # 每帧分辨率上限
         "total_pixels": 20480 * 28 * 28}, # 整段视频的 token 预算
        {"type": "text", "text": "视频里的人在做什么?请按时间顺序描述。"},
    ],
}]经验法则:先降 fps,再降分辨率,最后才加长上下文。2 小时视频 + 1 FPS + 高分辨率很容易吃满 224K token;官方评测也是把帧数上限定在 2,048 帧、总 token 不超过 224K。另外 qwen-vl-utils 里还有 process_vision_info 的写法可以更细粒度控制,但初学阶段用 content 里的参数就够了。
9.6 Step 4:长上下文(256K)与 1M 外推
默认权重就是 256K 上下文,不需要改代码;要跑满长上下文,部署时把长度设够:
启动 vLLM 服务(256K 上下文)
# vLLM 示例
vllm serve Qwen/Qwen3-VL-32B-Instruct --max-model-len 262144
要用到约 1M token 需要打开 YaRN 位置扩展(改 config.json 的 max_position_embeddings + rope_scaling;vLLM 用 --rope-scaling / --max-model-len)。注意报告里的「1M token 仍有 99.5%」是视频 NIAH(找一帧 + 回答)的结果,不等于「1M token 的复杂长视频推理」;真实任务里还是建议先压缩输入(降 fps、分块、检索)。
9.7 Step 5:Thinking 模式
把模型 ID 换成 -Thinking,并给足思考 token:
Thinking 模式调用示例
model_id = "Qwen/Qwen3-VL-32B-Thinking"
# ... 加载方式完全一样 ...
out = model.generate(**inputs, max_new_tokens=32768)  # 复杂题可到 80K
适合:数学/几何题、科学推理、需要多步检查的 Agent 任务。不适合:低延迟对话、简单 OCR、GUI 点击(这些先试 Instruct,报告里就有 Instruct 更好的例子)。
9.8 参数 ↔ 论文概念的对应关系
| 代码 / 参数 | 论文里的概念 | 怎么用 |
|---|---|---|
-Instruct / -Thinking 模型 ID | 两套后训练:SFT vs Long-CoT + RL | 按延迟/推理难度选,分别下载 |
content 里的 image / video / text 顺序 | 交错上下文(interleaved context) | 图片、视频、文字按任务顺序排 |
max_pixels / min_pixels | 原生分辨率 + 2×2 tokenizer | 控制单图/单帧分辨率与 token 数 |
total_pixels | 长上下文 token 预算 | 控制整段视频的总 token |
fps / sample_fps | 视频帧采样 + 文本时间戳 | 降 fps 是最便宜的省 token 手段 |
max_new_tokens | Thinking 的长 CoT 预算 | 数学/代码建议 32K–80K;普通任务 1K–4K |
max_position_embeddings + rope_scaling | 256K 原生 / YaRN 1M 外推 | 默认不用动;要 1M 才开 YaRN |
attn_implementation="flash_attention_2" | 长上下文/多图推理效率(工程项) | 长输入、多图、视频时建议开 |
| DeepStack / Interleaved MRoPE / 文本时间戳 | 三个架构升级 | 内置在权重里,没有用户开关;选对模型即可 |
9.9 权重、协议与选型
- 许可证:Qwen3-VL 权重与仓库为 Apache-2.0;视觉塔基于 SigLIP-2[5](其权重协议以官方模型卡为准),商用前请核对 HF 模型卡。
- 权重清单:六个尺寸 × Instruct/Thinking = 12 个 checkpoint,HF 合集 Qwen3-VL 与 ModelScope 同步;2B/4B 用 SigLIP2-Large 视觉塔,其余用 SigLIP2-SO-400M。
- 开放边界:官方开源的是推理代码、权重、评测和 cookbook;预训练/SFT/RL 的完整数据与训练代码没有开放(报告只给了配方和数据类别)。商用前请确认「权重许可」和「训练数据来源」是两件事。
- 引用:学术使用请引用技术报告[1](BibTeX 见原文);二次分发权重时保留模型卡与许可证。
9.10 新手常见坑
- 不设 token 预算就塞长图/长视频:一张 4K 长截图可能几万 token,直接 OOM 或截断。先用
max_pixels/total_pixels压到能跑,再逐步放大。 - 视频 fps 开太高:1 FPS 往往就够「描述发生了什么」;只有做精细时间定位才需要更高。
- 默认 Thinking:简单 OCR、GUI 点击、实时对话用 Instruct 更快更省;Thinking 留给需要多步推理的题。
- 以为 235B 在所有任务上都最好:Agent(OSWorld)上 32B 反而更高;端侧 4B/8B 的 OCR 已经很能打。
- 忘了
qwen-vl-utils的版本:apply_chat_template/process_vision_info的接口在 0.0.14 附近有变化,按 README 锁定版本最稳。 - 把「1M 上下文」当成默认值:256K 是原生能力,1M 是 YaRN 外推 + 高成本;真实产品要做输入压缩和检索。
参考
- Qwen Team. Qwen3-VL Technical Report. arXiv 2511.21631, 2025. arXiv · 代码
- Bai, Chen, Liu, et al. Qwen2.5-VL Technical Report. arXiv 2502.13923, 2025. arXiv
- Wang, Bai, et al. Qwen2-VL: Enhancing Vision-Language Model's Perception of the World at Any Resolution. arXiv 2409.12191, 2024. arXiv
- Yang, Li, et al. Qwen3 Technical Report. arXiv 2505.09388, 2025. arXiv
- Tschannen, Gritsenko, et al. SigLIP 2: Multilingual Vision-Language Encoders with Improved Semantic Understanding, Localization, and Dense Features. arXiv 2502.14786, 2025. arXiv
- Chen, Meng, Peng, et al. Enhancing Vision Foundation Models via Multimodal Continual Pre-Training. arXiv 2503.18931, 2025. arXiv
- Meng, Yang, Tian, et al. DeepStack: Deeply Stacking Visual Tokens is Surprisingly Simple and Effective for LMMs. NeurIPS 2024. arXiv
- Chen, Lan, Yuan, et al. TimeMarker: A Versatile Video-LLM for Long and Short Video Understanding with Superior Temporal Localization Ability. arXiv 2411.18211, 2024. arXiv
- Yue, Ni, et al. MMMU: A Massive Multi-discipline Multimodal Understanding and Reasoning Benchmark for Expert AGI. CVPR 2024. arXiv
- Yue, Zheng, et al. MMMU-Pro: A More Robust Multi-discipline Multimodal Understanding Benchmark. arXiv 2409.02813, 2024. arXiv
- Lu, Bansal, Xia, et al. MathVista: Evaluating Mathematical Reasoning of Foundation Models in Visual Contexts. ICLR 2024. arXiv
- Liu, Li, Huang, et al. OCRBench: On the Hidden Mystery of OCR in Large Multimodal Models. arXiv 2305.07895, 2023. arXiv
- Mathew, Karatzas, Jawahar. DocVQA: A Dataset for VQA on Document Images. WACV 2021. arXiv
- Xie, Zhang, et al. OSWorld: Benchmarking Multimodal Agents for Open-Ended Tasks in Real Computer Environments. NeurIPS 2024. arXiv
- Rawles, Clinckemaillie, et al. AndroidWorld: A Dynamic Benchmarking Environment for Autonomous Agents. ICLR 2025. arXiv
- Fu, Dai, Luo, et al. Video-MME: The First-Ever Comprehensive Evaluation Benchmark of Multi-modal LLMs in Video Analysis. arXiv 2405.21075, 2024. arXiv
- Peng, Quesnelle, Fan, et al. YaRN: Efficient Context Window Extension of Large Language Models. ICLR 2024. arXiv