· 96 min read
论文解读:RIPE,用「是否同一场景」的二元标签训练关键点
TL;DR RIPE 的核心主张是:训练关键点检测器不需要深度、位姿、单应,甚至不需要像素级对应,只需要告诉网络两张图是不是同一个场景[1]。它把检测建模成强化学习策略——热图分 8×8 格,每格对 64 个位置做 categorical 采样,再用选中 logit 的 sigmoid 接受门过滤;描述子取 VGG-19 四层特征的 hypercolumn;奖励是把两图描述子做 MNN、再用 RANSAC 基础矩阵筛出的极线内点,正对给 +1、负对给 -1,用 REINFORCE 回传。结果:MegaDepth-1500 AUC@5° 55.11(ALIKED 56.71,DeDoDe 55.02),HPatches AUC@1px 37.93(DeDoDe 39.88),Aachen 夜间 0.25m/2° 52.9(加入 Tokyo 24/7 后 60.2),Boreas 暴雪 3cm/3° 3.22 为表中最高;代价是单张 A100 训练 3 天、单图推理 0.47 s(DeDoDe 0.45 s)。代码与权重已开源,但协议仅限非商业学术用途。
- 论文:RIPE: Reinforcement Learning on Unlabeled Image Pairs for Robust Keypoint Extraction,Johannes Künzel、Anna Hilsmann、Peter Eisert,Fraunhofer Heinrich-Hertz-Institut / Humboldt University Berlin,ICCV 2025,pp. 4868–4877,DOI。
- 代码:github.com/fraunhoferhhi/RIPE,权重在首次运行时自动下载;另有项目页和 Hugging Face demo。
- 前作 / 预备知识:DISK(策略梯度关键点)、DaD(REINFORCE 检测器)、SuperPoint(单应自监督);RIPE 把监督进一步削到只剩图像对标签。
一、动机:关键点学习卡在监督上
局部特征的学习一直有一个昂贵的隐含前提:网络要知道哪些像素是同一个 3D 点。SuperPoint 用单应把同一张图变换两次,从而免费得到像素对应[2];DISK 和 DaD 在 MegaDepth 上用深度与相机位姿算出对应,再用可重复性奖励训练检测器[3, 4];DeDoDe 进一步用 SfM 三角化出的 3D track 做监督[5]。这些做法都很有效,但数据门槛也清楚:要么有精确的几何标注,要么能构造出可信的合成变换,要么有足够好的 SfM 模型。
RIPE 想把这层前提也去掉。给定一对图 ,它只需要一个二元标签
这里的「同一场景」不是「同一栋建筑的两张随手拍」这么宽松,论文的定义是两图之间有足够多的 2D 关键点对应到同一个 3D 点,也就是有实质共视。但比起深度、位姿、单应或像素级对应,这仍然便宜得多:互联网照片、机器人日志、白天—黑夜序列、雨雪天气数据,只要知道拍摄地点或时段,就能自动打上这一位标签。
这个信号为什么可能够用?因为极线几何本身就是一个免费的一致性检验。如果两张图确实在同一场景,那么好的检测器和描述子应该产生一批互相匹配、并且能被同一个基础矩阵解释的点;如果两张图来自不同场景,就不存在这样一个基础矩阵,匹配越少越好。于是奖励可以定义为「通过极线检验的匹配数」,检测器只需要最大化它。论文的关键洞察就在这里:把 epipolar constraint 当作奖励,而不是当作监督标签。
这也解释了 RIPE 与之前强化学习路线的关系。Reinforced Feature Points 把检测、描述、匹配、位姿估计串成完整 pipeline,用已知位姿算最终任务奖励[6];DISK 用已知相对位姿算可重复性奖励[3];DaD 再用蒸馏和多样性把 DISK 的检测器做得更稳[4]。它们都还需要位姿。RIPE 把奖励换成「MNN + RANSAC 基础矩阵的内点数」,位姿就不再是训练的必需品。
与之相对,站内解读过的 LightGlue 和 LoMa 走的是「强检测器 + 学习匹配器」路线:LightGlue 用自注意力让匹配随难度自适应地变快或变准,LoMa 则用 DaD 检测、DeDoDe 描述和 LightGlue 式匹配器,把训练数据与模型容量堆到新的水平;它发表于 RIPE 之后,不在本文的对比表中。RIPE 关心的是更上游的问题——只靠图像对标签,检测器本身能不能被训出来;所以它的奖励仍然停在 MNN + RANSAC,不引入可学习的匹配器。
难点也随之而来。关键点选择是离散的,RANSAC 和 MNN 都不可导;如果直接对所有像素做全局 softmax,网络很容易塌缩到少数峰,甚至退化到极线汇聚的极点(epipole)附近。RIPE 的答案由三部分组成:分格采样保证空间覆盖和可分解的 log-prob,接受门让网络学会「这个格子不值得出点」,描述子辅助损失给稀疏的 RL 奖励补上稠密梯度。下面按这三条线拆。
二、核心方法
2.1 总体流程
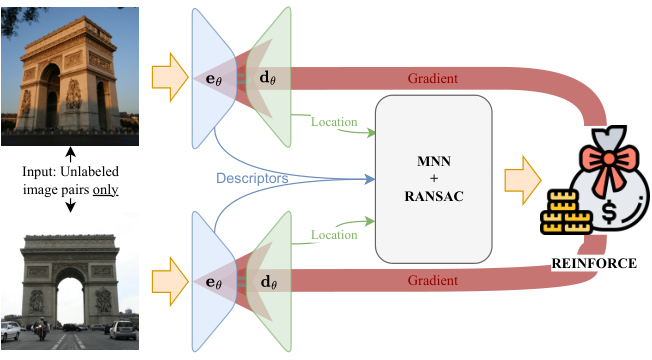
给定一对图,RIPE 的流程可以写成:
- 共享权重的 hourglass 网络对每张图输出一张单通道热图;
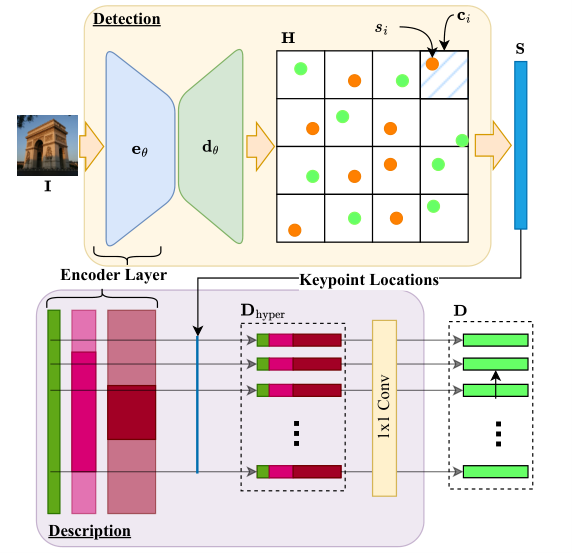
- 热图切成 的格子,每个格子按 categorical 分布采样一个位置,再用接受门决定是否保留;
- 在每个采样位置,从 encoder 的四个尺度双线性插值出 hypercolumn 特征,拼接后压到 256 维并 L2 归一化;
- 两图描述子做 mutual nearest neighbor(MNN),用 RANSAC 估计基础矩阵,保留极线内点;
- 正对的内点给正奖励,负对的对应匹配给负奖励,组成 的稀疏奖励矩阵;
- 用 REINFORCE 的 log-prob 加权奖励更新检测器,同时用对比损失直接训练描述子。
论文的架构细节:encoder 是 torchvision 的 VGG-19[7],取 strides 的四层,通道数为 64/128/256/512;decoder 沿用 DeDoDe 和 DKM 的 depthwise convolutional refiner[5, 8],每个尺度 8 个 block,内部维度也是 64/128/256/512,最后输出 1 通道热图。输入 resize + pad 到 ,不做随机裁剪或旋转。
2.2 分格检测:每格恰好一个点
记热图为
把 切成 的格子,,格子总数
在 的输入上,。每个格子 的 64 个 logit 定义一个 categorical 分布,网络从中采样一个位置:
也就是说,每个格子必定出一个点,点的位置在 64 个像素里选。这个设计有三个直接后果:
- 空间覆盖。格子之间互不竞争,关键点不会全部挤在纹理最强的几个峰上。论文用它对比 DeDoDe:DeDoDe 在定性图里明显把点聚在少数区域,而 RIPE 和 ALIKED 的分布更均匀。
- log-prob 可分解。每格的选择是独立的 categorical,整张图的策略就是 个分布的乘积;REINFORCE 的 log-prob 可以直接按格子相加,后面的 矩阵才有清晰的解释。
- 抗退化。如果所有点都塌到极线汇聚的极点,格子采样会强制其他格子也出点,描述子损失又会把这些点的描述子拉开;论文在补充材料里专门分析了这一点,结论是训练中从未观察到塌缩。
注意,这是训练时的采样方式。推理时并不按格子采样,而是在整张热图上做 NMS,再按原始 logit 取 top-(MegaDepth 2048,HPatches 1024)。训练和推理的选点机制并不完全一致,这一点后面会作为自己的观察展开。
2.3 接受门:不是每个格子都值得出点
只有 categorical 采样还不够。每个格子都会选一个位置,哪怕这个格子是天空、过曝的灯箱或纯色墙面;这些点既不可重复,也很难匹配。RIPE 给每个格子加了一个接受门:用选中位置的 logit 过一个 sigmoid,得到接受概率
再从这个伯努利分布采样一个指示变量 。最终一个格子被保留的概率是
被保留时的对数概率是
这里有一个实现上的巧思:接受门没有单独的 head,而是复用被选中位置的 logit。同一个 既参与「在 64 个位置里选哪个」的排序,又决定「这个格子要不要出点」。这带来两个好处:不增加参数;门的训练信号和点的位置直接绑定——如果一个格子选出的点确实可匹配,那么它的 logit 会被 RL 奖励推高,接受概率也一起变大。反过来,天空格子的 logit 会被压低,门自然关闭。
论文的公式写作 ,其中 是概率;代码里采样的指示变量也叫 accepted_choices。读代码时不要把这二者混淆:log_probs 是 categorical log-prob 与 Bernoulli log-prob 的和,被拒绝的格子同样有 log-prob,只是不进入后续匹配。
代码:分格采样与接受门(官方 ripe/models/ripe.py,原文照录)
    def sample(self, grid):
        """
        Sample keypoints given a grid where each cell has logits stacked in last dimension
        Input
          grid: [B, C, H//w, W//w, w*w]

        Returns
          log_probs: [B, C, H//w, W//w ] - logprobs of selected samples
          choices: [B, C, H//w, W//w] indices of choices
          accept_mask: [B, C, H//w, W//w] mask of accepted keypoints

        """
        chooser = torch.distributions.Categorical(logits=grid)
        choices = chooser.sample()
        logits_selected = torch.gather(grid, -1, choices.unsqueeze(-1)).squeeze(-1)

        flipper = torch.distributions.Bernoulli(logits=logits_selected)
        accepted_choices = flipper.sample()

        # Sum log-probabilities is equivalent to multiplying the probabilities
        log_probs = chooser.log_prob(choices) + flipper.log_prob(accepted_choices)

        accept_mask = accepted_choices.gt(0)

        return (
            log_probs.squeeze(1),
            choices,
            accept_mask.squeeze(1),
            logits_selected.squeeze(1),
        )
下面的部件把「接受门」压缩成一个可以拖的阈值。玩具图里有 312 个格子:上方是天空(其中一小块是云),中间是建筑立面,下方是地面。每个格子有一个「纹理分数」,代表网络学到的 ;阈值 以下的门被关掉。真实训练用的是伯努利采样,这里用确定性阈值代替,方便看清精度—召回的变化。
默认 时,104 个立面格子全部保留,地面混入约 30 个、天空混入约 10 个,精度约 73%;把 拉到 0.7,天空和地面全部被关掉,精度 100%,召回仍是 100%;再拉到 0.8,召回开始掉到 87%,0.9 时只剩 47%。把门关掉,312 个格子全部出点,精度跌到 33%。这就是接受门的作用:它不是让检测器「更敏感」,而是给它一个在无纹理区域弃权的机制。
2.4 Hypercolumn 描述子:从四个尺度取特征
检测到位置之后,下一步是给每个点一个描述子。最直接的做法是把 decoder 最后一层特征在关键点处双线性插值,但这一层分辨率低,空间细节在多次下采样和 refine 中已经损失。RIPE 改用 hypercolumn[9]:在 encoder 的四个尺度上分别插值,把 64+128+256+512=960 维拼起来,再用 卷积压到 256 维,最后 L2 归一化。
这里的插值是在归一化坐标上做的:关键点位置先除以输出图的 映射到 ,再对每个尺度的特征图调用 grid_sample。因为归一化坐标表示的是相对图像位置,同一个坐标在低分辨率特征图上会落到对应的相对位置,不需要为每个尺度单独换算。
为什么非要多尺度?论文的补充材料给了一个很硬的消融:把 hypercolumn 换成「encoder 最后一层的双线性上采样」,训练直接失败,描述子不够有区分度。作者把这一点归因于单尺度特征的感受野和语义层级太单一:低层特征定位准但缺少上下文,高层特征上下文强但定位糊,拼起来才能同时支撑匹配和定位。Poje 等人的 DEAL 也用过 encoder 特征的上采样[10],但 RIPE 认为在他们的设定下不够,必须显式保留多个尺度。
代码:hypercolumn 采样与降维(官方 ripe/models/upsampler/hypercolumn_features.py 与 ripe/models/ripe.py,原文节选)
    def normgrid(self, x, H, W):
        return 2.0 * (x / (torch.tensor([W - 1, H - 1], device=x.device, dtype=x.dtype))) - 1.0

    def extract_values_at_poses(self, x, pos, H, W):
        """Extract values from tensor x at the positions given by pos.

        Args:
        - x (Tensor): Tensor of size (C, H, W).
        - pos (Tensor): Tensor of size (N, 2) containing the x, y positions.

        Returns:
        - values (Tensor): Tensor of size (N, C) with the values from f at the positions given by p.
        """

        # check if grid is float32
        if x.dtype != torch.float32:
            x = x.to(torch.float32)

        grid = self.normgrid(pos, H, W).unsqueeze(-2)

        x = F.grid_sample(x, grid, mode=self.mode, align_corners=True)
        return x.permute(0, 2, 3, 1).squeeze(-2)

    def forward(self, x, pos, H, W):
        descs = []

        for layer in x:
            desc = self.extract_values_at_poses(layer, pos, H, W)
            descs.append(desc)

        return descs
def get_descs(self, feature_map, guidance, kpts, H, W):
descs = self.upsampler(feature_map, kpts, H, W)
if isinstance(self.conv_dim_reduction_coarse_desc, nn.ModuleList):
# individual descriptor convolutions for each layer
desc_conv = []
for desc, conv in zip(descs, self.conv_dim_reduction_coarse_desc):
desc_conv.append(conv(desc.permute(0, 2, 1)).permute(0, 2, 1))
desc = torch.cat(desc_conv, dim=-1)
else:
desc = torch.cat(descs, dim=-1)
desc = self.conv_dim_reduction_coarse_desc(desc.permute(0, 2, 1)).permute(0, 2, 1)
desc = F.normalize(desc, dim=2)
return desc2.5 极线奖励:用 RANSAC 内点数当分数
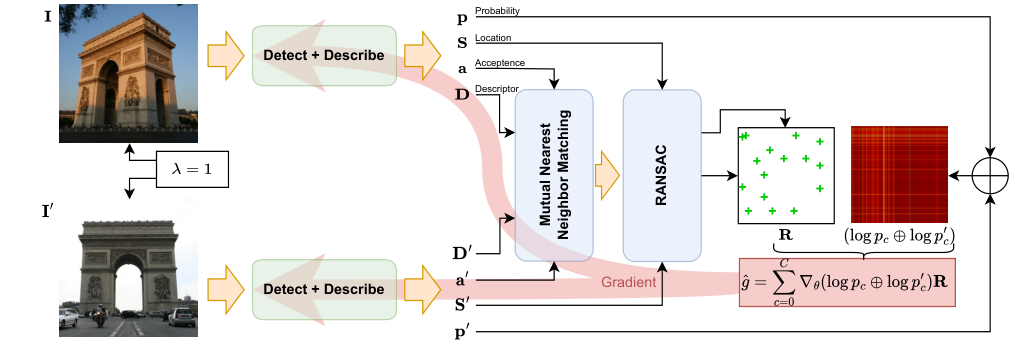
现在到了 RIPE 最核心的部分:奖励怎么算。给定两图的描述子,先用 L2 距离做 mutual nearest neighbor,得到候选匹配集合 。然后在这些匹配上估计基础矩阵 :
- 匹配用 Kornia 的
DescriptorMatcher(match_mode="mnn", th=0.8)[11]; - 基础矩阵用 PoseLib 的 8 点算法 + RANSAC[12],官方配置的极线阈值是 1.0 px;
- RANSAC 返回一个布尔掩码 ,表示匹配 是否能被同一个 解释。
奖励定义为
其中 。正对时内点得 ,负对时内点得 ;没有通过极线检验的匹配得 0。所有 放进一个 的矩阵 ,行是图 1 的格子、列是图 2 的格子。由于只有 MNN 匹配的格子非零,这个矩阵极度稀疏: 时理论上有 万项,但每对图只有 个非零。
论文的 Eq. 7 写的是「 且 为真」,也就是负对也只惩罚通过极线检验的匹配。这和代码的默认行为一致:默认配置 no_filtering_negatives: False 会把 None 传给 matcher,负对同样跑 RANSAC,只有内点被乘上 。代码里还有一条可选路径:把 no_filtering_negatives 设为 True,matcher 收到标签后会对负对跳过 RANSAC,把所有 MNN 都标成内点,奖励先取 0.5 再乘 ,于是每个 MNN 都得 。这条路径的注释说是为了「强制更可区分的描述子」,但它不是默认配置;读论文时容易忽略这个区别。
还有一个很小的项:fp_penalty = -1e-7。正对里没有匹配的格子会被填上 ,负对里则填 。它不是主奖励,作用是给「什么都没匹配上」一个极轻微的梯度,避免零奖励区域完全无信号。因为量级太小,打印矩阵时看起来仍然像 0。
代码:MNN、基础矩阵与极线奖励(官方 ripe/matcher/*.py、ripe/utils/utils.py,原文节选)
    def __call__(self, pts0, pts1, inl_th):
        F, info = poselib.estimate_fundamental(
            pts0.cpu().numpy(),
            pts1.cpu().numpy(),
            {
                "max_epipolar_error": inl_th,
            },
        )

        success = F is not None
        if success:
            inliers = info.pop("inliers")
            inliers = torch.tensor(inliers, dtype=torch.bool, device=pts0.device)
        else:
            inliers = torch.zeros(pts0.shape[0], dtype=torch.bool, device=pts0.device)

        return F, inliers
# use label information to exclude negative pairs from geometric filtering process -> enforces more descriminative descriptors
if label is not None and label[b] == 0:
ransac_inliers = torch.ones((idx_matches.shape[0]), device=dev).bool()
future_results[b] = (None, ransac_inliers)
continue with torch.no_grad():
reward *= 1.0 if label else -1.0
dense_returns = torch.zeros((len(kps1), len(kps2)), device=kps1.device)
if filter_mode == "ignore":
dense_returns[
abs_idx_matches[:, 0][ransac_inliers],
abs_idx_matches[:, 1][ransac_inliers],
] = reward
elif filter_mode == "punish":
in_padding_area = (
padding_mask1[abs_idx_matches[:, 0]] & padding_mask2[abs_idx_matches[:, 1]]
) # both in the image area (not in padding area)
dense_returns[
abs_idx_matches[:, 0][ransac_inliers & in_padding_area],
abs_idx_matches[:, 1][ransac_inliers & in_padding_area],
] = reward
dense_returns[
abs_idx_matches[:, 0][ransac_inliers & ~in_padding_area],
abs_idx_matches[:, 1][ransac_inliers & ~in_padding_area],
] = -1.0
else:
raise ValueError(f"Unknown filter mode: {filter_mode}")
if selected_only:
dense_returns = dense_returns[selected_mask1, :][:, selected_mask2]
if filter_mode == "ignore" and not selected_only:
dense_returns = dense_returns[padding_mask1, :][:, padding_mask2]
if penalty != 0.0:
# pos. pair: small penalty for not finding a match
# neg. pair: small reward for not finding a match
penalty_val = penalty if label else -penalty
dense_returns[dense_returns == 0.0] = penalty_val
if use_whitening:
dense_returns = (dense_returns - dense_returns.mean()) / (dense_returns.std() + 1e-6)下面的部件把奖励矩阵做成可以玩的版本。左图 A 和图 B 各有 20 个关键点,前 9 对是真实对应,其余是随机匹配;拖动极线阈值 ,看哪些匹配能通过极线检验。右边是 的奖励矩阵,绿色是 ,红色是 ,灰色是「匹配了但没通过检验」。真实场景里 ,矩阵是 ,这里缩小到 20 只是为了看得清。
默认设置下(正对, px,离群比例 0.25),14 个候选 MNN 里有 9 个通过极线检验,矩阵里 9 个 。把 拉到 0.5,只剩 5 个;拉到 1,8 个;拉到 4 以上,9 个稳定下来,因为剩下的离群匹配离极线太远,再放宽也进不来。切到「负对:默认 RANSAC」,同样的 9 个内点变成 ;切到「负对:跳过 RANSAC」,14 个 MNN 全部变成 。这个对比就是代码与论文 Eq. 7 之间最值得注意的一处细节。
2.6 REINFORCE:把 C 个格子当成 C 条轨迹
有了奖励矩阵,接下来的问题是:奖励不可导,怎么更新检测器?RIPE 用 REINFORCE[3, 4]。把 encoder–decoder 看成策略 ,输入图像是状态 ,采样出的关键点是动作 ,策略输出的是每个格子的选择概率:
训练目标是最大化期望奖励:
REINFORCE 给出梯度估计:
这里 是外和:若 、,则 ,得到一个 矩阵。第 项的含义是「图 1 的第 个格子选了点、图 2 的第 个格子也选了点」这一对动作的 log-prob,乘以这一对的奖励 。代码里对应的是
dense_logprobs = logprobs1[b][...].view(-1, 1) + logprobs2[b][...].view(1, -1)然后逐元素乘奖励、取均值、取负号,作为策略损失。论文把它记作 ,和式 (10) 一起优化。
为什么一次前向能提供足够多的样本?因为每张图有 个格子,每个格子独立采样一个动作,一次图像对就相当于 条轨迹、 个动作对。奖励矩阵虽然大,但只有 MNN 匹配的格子非零,实际有效的梯度项是 个;其余项乘 0,不贡献梯度。这也是为什么 RIPE 能在单张 A100 上训练,而不需要像完整 RL pipeline 那样反复采样。
但纯 REINFORCE 有一个致命问题:奖励太稀疏,而且只告诉网络「这个匹配好不好」,不告诉它「描述子应该长什么样」。如果只有策略损失,描述子没有直接监督,匹配会迅速退化,奖励也跟着消失。论文的消融很直接:去掉描述子损失( 或 ),训练失败。所以还需要下一节的辅助损失。
代码:REINFORCE 策略损失(官方 ripe/train.py,原文节选)
                current_loss_policy = (dense_rewards * dense_logprobs).view(-1)

                loss_policy_stack = (
                    current_loss_policy
                    if loss_policy_stack is None
                    else torch.hstack((loss_policy_stack, current_loss_policy))
                )

                if kp_penalty != 0.0:
                    # keypoints with low logprob are penalized
                    # as they get large negative logprob values multiplying them with the penalty will make the loss larger
                    loss_kp = (
                        logprobs1[b][mask_selection_for_matching_1]
                        * torch.full_like(
                            logprobs1[b][mask_selection_for_matching_1],
                            kp_penalty * alpha,
                        )
                    ).mean() + (
                        logprobs2[b][mask_selection_for_matching_2]
                        * torch.full_like(
                            logprobs2[b][mask_selection_for_matching_2],
                            kp_penalty * alpha,
                        )
                    ).mean()
                    loss_kp_stack = loss_kp if loss_kp_stack is None else torch.hstack((loss_kp_stack, loss_kp))

                sum_num_keypoints_1 += mask_selection_for_matching_1.sum()
                sum_num_keypoints_2 += mask_selection_for_matching_2.sum()

            loss = loss_policy_stack.mean()
            if loss_kp_stack is not None:
                loss += loss_kp_stack.mean()

            loss = -loss

            if descriptor_loss is not None:
                loss += cfg.desc_loss_weight * loss_desc_stack.mean()
2.7 描述子损失:给 RL 奖励补上稠密梯度
描述子损失是一个按图像对类型分叉的对比损失。记第 个 RANSAC 内点的匹配描述子距离为 ,它的第二近邻距离为 ,边距 :
正对时,这一项要求「匹配内点的距离」比「第二近邻的距离」至少小 :不仅要匹配上,还要比错误匹配明显更近。负对时,这一项把匹配上的描述子推开,至少推到 以外。前者提升可区分性,后者直接惩罚假阳性。
代码里还有一个细节:第二近邻距离取的是两个方向中更硬的那个。对每个内点,先在「图 1 描述子 vs 图 2 全部描述子」里找第二近邻,再在反方向找一次,取两者距离的较小值作为 。这比只看一个方向更严格,也更接近匹配时实际会遇到的竞争。
是官方配置的 pos_margin 和 neg_margin,论文正文没有强调这个数。另一个代码细节是:如果 RANSAC 内点数少于 8,损失会退化成在所有 MNN 匹配上计算(inliers = torch.ones_like(inliers)),而不是只用内点。这能在早期匹配很少时提供梯度,但也意味着少量离群匹配会进入描述子损失;论文没有讨论这个 fallback。
代码:描述子对比损失(官方 ripe/losses/contrastive_loss.py,原文节选)
    if inliers.sum() < 8:  # if there are too few inliers, calculate loss on all matches
        inliers = torch.ones_like(inliers)

    matched_inliers_descs1 = desc1[matches[:, 0][inliers]]
    matched_inliers_descs2 = desc2[matches[:, 1][inliers]]

    if logits_1 is not None and logits_2 is not None:
        matched_inliers_logits1 = logits_1[matches[:, 0][inliers]]
        matched_inliers_logits2 = logits_2[matches[:, 1][inliers]]
        logits = torch.minimum(matched_inliers_logits1, matched_inliers_logits2)
    else:
        logits = torch.ones_like(matches[:, 0][inliers])

    if label:
        snn_match_dists_1, idx1 = second_nearest_neighbor(matched_inliers_descs1, desc2)
        snn_match_dists_2, idx2 = second_nearest_neighbor(matched_inliers_descs2, desc1)

        dists = torch.hstack((snn_match_dists_1, snn_match_dists_2))
        min_dists_idx = torch.min(dists, dim=1).indices.unsqueeze(1)

        dists_hard = torch.gather(dists, 1, min_dists_idx).squeeze(-1)
        dists_pos = F.pairwise_distance(matched_inliers_descs1, matched_inliers_descs2)

        contrastive_loss = torch.clamp(pos_margin + dists_pos - dists_hard, min=0.0)

        contrastive_loss = contrastive_loss * logits

        contrastive_loss = contrastive_loss.sum() / (logits.sum() + 1e-8)  # small epsilon to avoid division by zero
    else:
        dists = F.pairwise_distance(matched_inliers_descs1, matched_inliers_descs2)
        contrastive_loss = torch.clamp(neg_margin - dists, min=0.0)

        contrastive_loss = contrastive_loss * logits

        contrastive_loss = contrastive_loss.sum() / (logits.sum() + 1e-8)  # small epsilon to avoid division by zero
2.8 正则、总损失与训练配置
除了描述子损失,RIPE 还有一项低概率关键点正则:
其中 是一个很小的负数。它的作用不是奖励匹配,而是防止网络把概率质量放到极低概率的点上: 越负,乘上负的 后损失越大。训练时 的影响在前 1/3 步内线性升起,避免一开始就把采样限制得太死。
最终损失是
官方配置 。三项各司其职:策略损失优化「选哪些点」,描述子损失优化「怎么描述」,低概率正则维持采样的多样性。
| 项目 | 值 | 说明 |
|---|---|---|
| 输入分辨率 | resize + pad,保持长宽比 | |
| 网格 | 8 | |
| 描述子维度 | 256 | 960 维 hypercolumn → 1×1 卷积 |
| 奖励 | 1.0 | 每个极线内点 |
| 描述子损失权重 | 5.0 | 表 1 与代码一致 |
| 正则 | (表 1)/ (表 7 与代码) | 论文内部不一致,见下 |
| 优化器 | AdamW, | 线性衰减 |
| 训练 | 80,000 步,batch 6,梯度累积 4 | bf16-mixed,单张 A100 约 3 天 |
| 数据 | DISK 的 MegaDepth 子集 | 正对 / 负对 1:1 |
这里必须指出一处论文与代码的不一致:表 1 把 标成 ,但表 7 的消融说最优是 ,官方配置也确实是 。表 7 的标题还把 写成了「descriptor loss weight」,而正文说它是正则参数;从公式 (9) 看,标题是笔误。按表 7 和代码走, 才是实际训练用的值。
训练数据方面,正对来自 DISK 的 MegaDepth 子集:每个场景的 tuple 里有三张图,随机取两张;负对从另一个随机场景取一张图,标签为 0。正负对严格交替,所以每个 batch 里各占一半。负对不是 hard negative,只是随机另一个场景——这一点对理解后面的局限很重要。
三、实验结果
3.1 评测协议
论文用了四个基准,协议细节比数字更重要:
- MegaDepth-1500[13, 14]:两个场景、1500 对图,挑战是大视角、光照和重复纹理。稀疏方法把长边缩到 1200,稠密方法缩到 1600;所有稀疏方法用 MNN 匹配,PoseLib 估相对位姿,取 top 2048 个点,报告 AUC@。
- HPatches[15]:平面场景的视角/光照序列,短边缩到 480,取 top 1024 个点,用重投影误差的 AUC@1/3/5 px。
- Aachen Day-Night v1.1[16]:6697 张参考图,1015 个查询(824 白天、191 夜间);HLoc + NetVLAD 取 top 50,PnP RANSAC,报告 0.25m/2°、0.5m/5°、5m/10° 的 AUC。
- Boreas[17]:自动驾驶多季节数据,参考序列 + 四个查询序列(Dark、Late Autumn、Heavy Snowfall、Rain);HLoc + NetVLAD 取 top 20,报告 3cm/3°、5cm/5°、25cm/2° 的 AUC。
另外,论文用 IMC2020[18] 的一个小验证子集做超参数选择,只训练 40,000 步就停,报告 AUC@5°。这个数字不是跨方法的主基准,后面讲消融时会用到。
3.2 MegaDepth 与 HPatches:稀疏方法里的第二
先看最常被引用的 MegaDepth-1500。RIPE 的 AUC@5°/10°/20° 是 55.11/68.34/78.03,在稀疏方法里仅次于 ALIKED[19] 的 56.71/69.86/79.54,略高于 DeDoDe-B 的 55.02/67.99/77.31;DISK 是 51.83/64.49/74.3,SuperPoint 是 49.5/62.51/72.12,SiLK[20] 只有 29.83/40.59/49.98。半稠密/稠密方法更高:RoMa 68.28/80.53/88.77,Efficient LoFTR 64.63/78.03/87.21,MASt3R 22.84/35.29/47.62[21, 22, 23](MASt3R 在这个稀疏匹配协议下并不占优,和它的设计目标有关)。
HPatches 上 RIPE 是 37.93/58.93/69.20:AUC@1px 低于 DeDoDe 的 39.88 和 SiLK[20] 的 39.05,AUC@5px 略高于 SiLK 的 67.64,整体和 DeDoDe/SiLK 同一档。ALIKED[19] 在这里掉到 31.95/57.65/69.35,说明它在 MegaDepth 上的优势没有完全迁移到平面单应;SiLK 则因为训练分布接近 HPatches,表现相对好。
下面的部件把表 2 的数字做成可以切换的条形图。选数据集和指标,条形按数值排序,RIPE 用强调色标出;把鼠标停在图上可以看到每个方法的具体值(移动端可以直接点选下拉框)。
3.3 Aachen:数据多样性比网络结构更值钱
Aachen 的结果是论文最有说服力的一组,因为它直接展示了「弱监督 + 多样数据」的价值。
| 方法 | Day 0.25m/2° | Day 0.5m/5° | Day 5m/10° | Night 0.25m/2° | Night 0.5m/5° | Night 5m/10° |
|---|---|---|---|---|---|---|
| ALIKED | 87.3 | 93.9 | 97.3 | 73.3 | 88.0 | 96.9 |
| DeDoDe | 82.2 | 89.0 | 92.6 | 47.1 | 56.5 | 64.4 |
| SIFT | 82.5 | 88.5 | 91.9 | 30.9 | 38.2 | 46.1 |
| RIPE(仅 MegaDepth) | 81.6 | 89.2 | 93.1 | 52.9 | 67.5 | 79.1 |
| RIPE + Tokyo 24/7 | 81.6 | 89.0 | 92.4 | 60.2 | 72.8 | 83.8 |
只看 MegaDepth 训练,RIPE 夜间 0.25m/2° 是 52.9,比 DeDoDe 的 47.1 高 5.8,比 SIFT[24] 的 30.9 高 22.0;但离 ALIKED 的 73.3 还很远。论文对此的解释很坦率:ALIKED 不只在 MegaDepth 上训练,还用了 Aachen 的训练图像和合成数据,所以它在夜间查询上不是零样本。RIPE 只用 MegaDepth 时,已经能在夜间超过 DeDoDe 和 SIFT,说明极线奖励学到的特征对光照变化有一定泛化。
加入 Tokyo 24/7[25] 后,夜间涨到 60.2/72.8/83.8,分别 +7.3/+5.3/+4.7;白天几乎不变(+0.0/-0.2/-0.7)。Tokyo 24/7 是地点识别数据集,每个地点有白天、黄昏、夜晚三个视角,图像之间只按地理位置配对,没有 3D 或深度信息——这正好是 RIPE 能吃的数据。Table 4 进一步扫了混合比例:80% MegaDepth + 20% Tokyo 最好;把 Tokyo 提高到 40%,白天掉到 71.8/81.2/87,说明 Tokyo 的视角变化太少,模型会过拟合到「只认光照变化」而牺牲视角鲁棒性。论文把原因归结为 Tokyo 的图像主要在同一视角附近变化,缺少 MegaDepth 那种大视角差。
3.4 Boreas:恶劣天气下的收益与代价
Boreas 的结果放在补充材料,但很有信息量。RIPE 仅 MegaDepth 时,四个查询序列的 3cm/3°、5cm/5°、25cm/2° 分别是:
- Dark:8.58/27.27/88.12
- Late Autumn:3.96/12.84/91.07
- Heavy Snowfall:3.22/11.78/68.86
- Rain:7.0/23.69/93.94
加入 10% ACDC[26] 后变成 9.89/28.61/88.46、4.37/12.04/91.42、3.36/10.33/69.89、11.57/29.06/94.45。最亮眼的是暴雪 3cm/3°:3.22 是表中最好的稀疏方法(ALIKED 2.37、DeDoDe 1.84、DISK 2.34、SIFT 1.24),加 ACDC 后 3.36 更高。Dark 和 Rain 的紧阈值也有提升(Dark +1.31/+1.34/+0.34,Rain +4.57/+5.37/+0.51)。
但这不是全面提升:Late Autumn 的 5cm/5° 从 12.84 降到 12.04,Heavy Snowfall 的 5cm/5° 从 11.78 降到 10.33。论文的结论是「数据多样性有帮助」,但具体到某个天气/阈值,增益并不单调。另一个不能忽略的事实是,所有方法在 3cm/3° 这种紧阈值下都只有个位数到十几个点,25cm/2° 才到 68–95;恶劣天气的视觉定位仍然很难。
3.5 消融:哪些设计真的关键
论文的消融主要在 IMC2020 验证子集上做,训练 40,000 步,指标是 AUC@5°。这个设置不是最终模型,但足以看趋势。
描述子损失权重 (表 6): 和 训练失败; 是 61.94, 是 60.46, 是 63.48, 是 60.65。最优在 5 附近,太小描述子没有直接监督,太大压过检测损失。
正则 (表 7): 还能训练,61.0; 和 失败; 是 63.48; 掉到 57.45。也就是说,这个正则不能没有,也不能太强,最优值很窄。再强调一次,表 1 写的 与表 7/代码的 不一致,实际应按后者。
Hypercolumn:补充材料说,把 hypercolumn 换成 encoder 最后一层的双线性上采样,训练直接失败。这是架构上最关键的消融之一,说明多尺度特征不是锦上添花,而是让描述子足够可区分的前提。
网格大小 和接受门:论文没有给出单独的消融。这是一个空白: 是表 1 的超参数,但读者无法从论文知道 或 会怎样,也无法知道去掉接受门会掉多少。从设计上看, 控制空间密度和每格的搜索范围,接受门控制弃权,两者都值得单独扫。
退化到极点:论文在补充材料专门分析了「所有点都预测到极点」的风险。MegaDepth 的极点通常在图像外,所以不是问题;ACDC 和 Tokyo 24/7 的极点有时在图像内,理论上可能塌缩。作者认为有两道防线:描述子损失迫使描述子可区分,网格采样强制空间均匀;训练中从未观察到塌缩。这个分析是必要的,但也只是「没观察到」,不是形式化保证。
3.6 定性结果
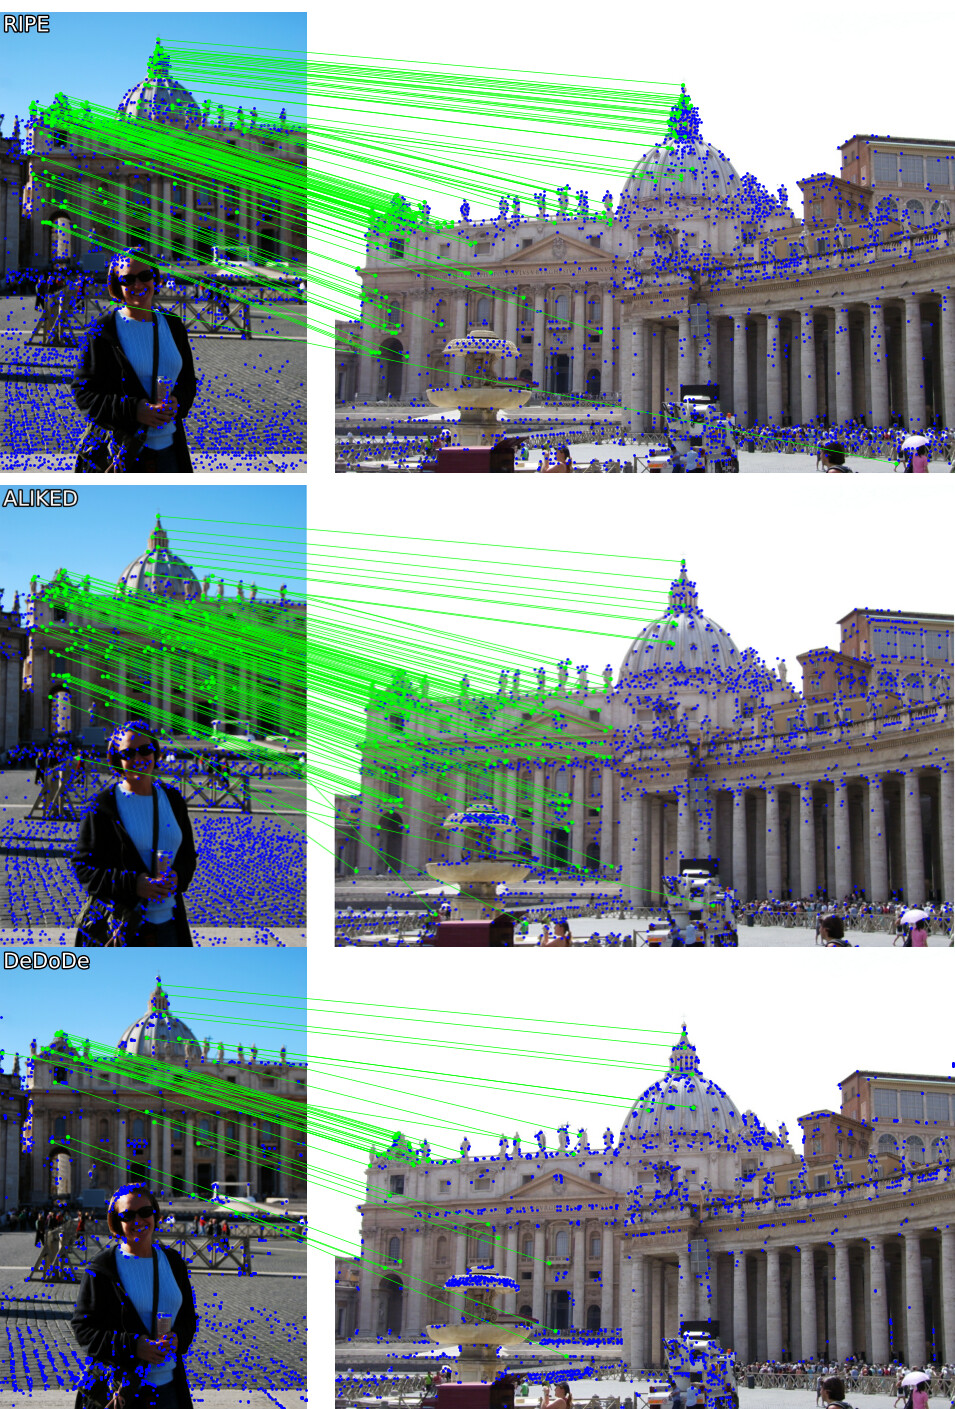
定性图支持论文的核心叙事:RIPE 不是靠更多的点取胜,而是靠把点放在可匹配、可被极线几何解释的地方。DeDoDe 的聚类问题在图中很明显——它倾向在少数区域反复出点,导致匹配线扎堆;RIPE 的分格采样天然抑制了这种聚集。ALIKED 的分布也不差,但它的训练用了 pose + homography,RIPE 只用二元标签。
四、局限性
4.1 论文自己承认的
- 训练不稳定,超参数敏感。官方配置里学习率 0.001 的注释直接写着「somewhat unstable」;、 以及过大的 都会让训练失败。最终模型能跑,但它不是一个「随便调都能收敛」的方法。
- 极点塌缩的风险。奖励只看极线内点数,理论上存在把所有点放到极点附近的退化解。论文的分析是「MegaDepth 极点常在图外;ACDC/Tokyo 有时在图内,但描述子损失 + 网格采样阻止了塌缩;实验中从未观察到」。这是经验结论,不是证明。
- 数据多样性不是单调收益。Aachen 上 Tokyo 比例从 20% 加到 40%,白天指标明显下降;Boreas 上 ACDC 也不是每个指标都涨。作者把原因归为 Tokyo 缺少视角变化,但这说明「多喂数据」需要选对数据。
- 恶劣天气的紧阈值仍然很低。Boreas 3cm/3° 只有个位数到十几个点,25cm/2° 才好看;论文没有回避这一点。
- 计算成本。单张 A100 训练 3 天,单图推理 0.47 s(DeDoDe 0.45 s、ALIKED 0.08 s、DISK 0.17 s)。它不是面向实时的方法。
- 标签的定义仍有门槛。「同一场景」要求足够多的共视 3D 点,不是任意两张同地点照片;正对的选择、负对的采样仍然会影响学到的东西。
4.2 我自己的观察
- 没有旋转/尺度鲁棒性的评测。训练变换只有 resize + pad + 归一化,没有随机旋转、尺度或透视增强;评测也集中在 MegaDepth/HPatches 这种以直立视角为主的基准。RaCo 的结果表明,学习型检测器在 45°、135° 这类中间旋转上会明显掉点[27],而 RIPE 没有针对这一点做实验。论文的「鲁棒」主要指光照、天气、视角,不是面内旋转。
- 训练和推理的选点机制不一致。训练时每格 categorical 采样 + 伯努利接受门,推理时整图 NMS + top-K,按原始 logit 排序;接受概率 在推理时并没有被显式计算。这未必是 bug——logit 排序和 排序在单调性上有关——但训练分布与推理分布确实不同,论文没有分析这个 gap。
- 奖励不惩罚定位误差。一个匹配只要极线残差小于 1 px 就拿 ,不管关键点落在角点的哪一侧。HPatches AUC@1px 37.93 低于 DeDoDe 的 39.88,可能部分来自这里:RIPE 优化的是「能匹配」,不是「像素级准」。如果下游是三角化或 BA,亚像素定位会很重要。
- 负对太容易。负对从随机另一个场景取,不是 hard negative;网络很快就能学会「不同场景不要匹配」。论文没有做 hard-negative 消融,也没有分析负对难度对学到特征的影响。对真实应用来说,最难的负对往往是「同一地点、不同时间/视角但无共视」,RIPE 目前的采样没有覆盖这种。
- 描述子损失的 fallback 会引入离群匹配。内点少于 8 时,损失在全部 MNN 上算,而不是只用内点;早期或难对图上,这可能把错误匹配当成正样本拉近。代码注释说这是为了「too few inliers」,但没有说明阈值 8 的依据。
- 论文内部数字有前后不一致。除了 的 vs ,表 7 标题把 写成 descriptor loss weight;式 (10) 前的文字说「final loss for the descriptor is 」,从上下文看应是 。这些不影响方法本身,但复现时要按代码和表 7,而不是表 1。
- 许可证限制。官方 LICENSE 是「Software Copyright License for Academic Use of RIPE, Version 2.0」,仅限非商业学术用途;商用需要另谈。这一点比很多 MIT/Apache 的局部特征项目更严格,落地前要确认。
五、结论与展望
RIPE 的价值不在于它把 MegaDepth 刷到第一——它没有,ALIKED 仍然高 1.6 个点,RoMa/Eff. LoFTR 这些稠密方法更高。它的价值在于把监督信号压到了理论上很低的限度,并且证明了这样仍然能训练出一个有竞争力的稀疏关键点提取器。二元「是否同场景」标签 + 极线几何奖励,让训练数据从「有深度/位姿/SfM 的互联网照片」扩展到「只要知道拍摄地点或时段的任意图像对」。Aachen 夜间和 Boreas 暴雪的结果说明,这种扩展不是玩具:加入 Tokyo 24/7 或 ACDC 后,模型确实在对应的域上变好。
从方法上看,最值得带走的三个设计是:
- 分格 categorical 采样把离散选点变成可分解的 log-prob,让 REINFORCE 的 外和成立,同时保证空间覆盖;
- 接受门复用选中 logit,用几乎零额外参数给网络一个弃权机制;
- 极线 RANSAC 内点数当奖励,把「几何一致性」变成不需要位姿的监督信号。
这三者缺一不可:没有分格,采样会塌缩;没有接受门,天空也会出点;没有极线奖励,就退回需要位姿的 DISK/DaD 路线。
展望上,最直接的问题是效率和鲁棒性。 的稠密 log-prob 矩阵在 时是 2400 万项,虽然只有匹配项非零,但显存和计算仍然可观;如果能只采样部分格子对,或用一个可学习的匹配器替代 MNN+RANSAC,训练成本会降很多。另一个方向是把奖励做得更细:定位精度、hard negative、旋转/尺度一致性都可以进入奖励,而不只是「是否通过 1 px 极线检验」。RIPE 的作者在后续工作 RIPE++ 中已经把「只用正对、去掉负对、加入可训练匹配器」作为方向[28],但这篇论文本身的主线仍然是「二元标签 + 极线奖励」,RIPE++ 的细节不在本文范围内。
六、上手
官方仓库提供了推理 demo、MegaDepth/HPatches 评测和训练脚本。下面命令按 README 整理,安装和评测命令折叠起来;权重在第一次运行 demo.py 时自动下载到 /tmp/ripe_weights.pth。
安装与推理 demo
git clone https://github.com/fraunhoferhhi/RIPE
cd RIPE
mamba create -f conda_env.yml
mamba activate ripe-env
python demo.py
demo.py 会读取 assets/all_souls_000013.jpg 和 assets/all_souls_000055.jpg,调用 model.detectAndCompute(image, threshold=0.5, top_k=2048),做 MNN 和 RANSAC,最后把匹配图保存为 result_ransac.png。核心接口是:
kpts, desc, score = model.detectAndCompute(image, threshold=0.5, top_k=2048)kpts 是 坐标,desc 是 256 维 L2 归一化描述子,score 是热图分数归一化到最大值后的排序分。注意 threshold 卡的是原始热图 logit,不是接受概率 ;top_k 在 NMS 之后按原始分数截断。
复现 MegaDepth-1500 与 HPatches
git clone https://github.com/JohannesK14/glue-factory
cd glue-factory
uv sync
uv run python -m gluefactory.eval.megadepth1500 --conf ripe+NN
uv run python -m gluefactory.eval.hpatches --conf ripe+NN
README 给出的期望值是 MegaDepth-1500 的 55.11/68.34/78.03 和 HPatches 的 37.93/58.93/69.20,与表 2 一致。评测走的是作者 fork 的 Glue Factory,ripe+NN 配置里 MegaDepth 长边 1600、HPatches top 1024、PoseLib RANSAC 阈值 0.5;这和论文正文的稀疏方法协议(长边 1200、top 2048)不完全一样,复现时以仓库配置为准。
训练:MegaDepth 子集,可选 Tokyo 24/7 / ACDC
# 先在仓库根目录创建 .env,写入 OUTPUT_DIR、DATA_DIR、SLURM_JOB_ID
cd data
bash download_disk_data.sh
cd ..

python ripe/train.py --config-name train project_name=train name=reproduce wandb_mode=offline

# 加入 20% Tokyo 24/7(对应 Aachen 夜间实验)
python ripe/train.py --config-name train project_name=train name=reproduce wandb_mode=offline data=megadepth+tokyo

# 加入 10% ACDC(对应 Boreas 恶劣天气实验)
python ripe/train.py --config-name train project_name=train name=reproduce wandb_mode=offline data=megadepth+acdc
训练脚本默认 80,000 步、batch 6、梯度累积 4、bf16-mixed,单张 A100 约 3 天。data=megadepth+tokyo 和 data=megadepth+acdc 的组合权重都是 20%/80%(Tokyo/ACDC 在前,MegaDepth 在后),与论文表 4 的 80% MegaDepth + 20% Tokyo 以及补充材料的 10% ACDC 设置一致。跑之前确认 DATA_DIR 下有 disk-data,可选数据在 Tokyo_Query_V3 和 ACDC 下。
参考
- Künzel, Hilsmann, Eisert. RIPE: Reinforcement Learning on Unlabeled Image Pairs for Robust Keypoint Extraction. ICCV 2025. arXiv · 代码
- DeTone, Malisiewicz, Rabinovich. SuperPoint: Self-Supervised Interest Point Detection and Description. CVPR Workshops 2018. arXiv · 代码
- Tyszkiewicz, Fua, Trulls. DISK: Learning Local Features with Policy Gradient. NeurIPS 2020. arXiv · 代码
- Edstedt, Bökman, Wadenbäck, Felsberg. DaD: Distilled Reinforcement Learning for Diverse Keypoint Detection. arXiv 2503.07347, 2025. arXiv · 代码
- Edstedt, Bökman, Wadenbäck, Felsberg. DeDoDe: Detect, Don't Describe — Describe, Don't Detect for Local Feature Matching. 3DV 2024. arXiv · 代码
- Bhowmik, Gumhold, Rother, Brachmann. Reinforced Feature Points: Optimizing Feature Detection and Description for a High-Level Task. CVPR 2020. arXiv
- Simonyan, Zisserman. Very Deep Convolutional Networks for Large-Scale Image Recognition. ICLR 2015. arXiv
- Edstedt, Athanasiadis, Wadenbäck, Felsberg. DKM: Dense Kernelized Feature Matching for Geometry Estimation. CVPR 2023. arXiv · 代码
- Hariharan, Arbeláez, Girshick, Malik. Hypercolumns for Object Segmentation and Fine-Grained Localization. CVPR 2015. CVF
- Potje, Cadar, Araujo, Martins, Nascimento. Enhancing Deformable Local Features by Jointly Learning to Detect and Describe Keypoints. CVPR 2023. arXiv · 代码
- Riba, Mishkin, Ponsa, Rublee, Bradski. Kornia: an Open Source Differentiable Computer Vision Library for PyTorch. WACV 2020. arXiv · 代码
- Larsson, contributors. PoseLib: Minimal Solvers for Camera Pose Estimation. GitHub, 2020. GitHub
- Li, Snavely. MegaDepth: Learning Single-View Depth Prediction from Internet Photos. CVPR 2018. arXiv
- Sun, Shen, Wang, Bao, Zhou. LoFTR: Detector-Free Local Feature Matching with Transformers. CVPR 2021. arXiv · 代码
- Balntas, Lenc, Vedaldi, Mikolajczyk. HPatches: A Benchmark and Evaluation of Handcrafted and Learned Local Descriptors. CVPR 2017. arXiv
- Sattler, Maddern, Toft, Torii, Hammarstrand, Stenborg, Safari, Okutomi, Pollefeys, Sivic, Kahl, Pajdla. Benchmarking 6DOF Outdoor Visual Localization in Changing Conditions. CVPR 2018. arXiv · 基准
- Burnett, Yoon, Wu, Li, Zhang, Lu, Qian, Tseng, Lambert, Leung, Schoellig, Barfoot. Boreas: A Multi-Season Autonomous Driving Dataset. The International Journal of Robotics Research, 42(1–2):33–42, 2023. arXiv · 项目页
- Jin, Mishkin, Mishchuk, Matas, Fua, Yi, Trulls. Image Matching across Wide Baselines: From Paper to Practice. International Journal of Computer Vision, 129:517–547, 2021. arXiv · 代码
- Zhao, Wu, Chen, Chen, Xu, Li. ALIKED: A Lighter Keypoint and Descriptor Extraction Network via Deformable Transformation. IEEE Transactions on Instrumentation and Measurement, 2023. arXiv · 代码
- Gleize, Wang, Feiszli. SiLK: Simple Learned Keypoints. ICCV 2023. arXiv · 代码
- Edstedt, Sun, Bökman, Wadenbäck, Felsberg. RoMa: Robust Dense Feature Matching. CVPR 2024. arXiv · 代码
- Wang, He, Peng, Tan, Zhou. Efficient LoFTR: Semi-Dense Local Feature Matching with Sparse-Like Speed. CVPR 2024. arXiv · 代码
- Leroy, Cabon, Revaud. Grounding Image Matching in 3D with MASt3R. ECCV 2024. arXiv · 代码
- Lowe. Distinctive Image Features from Scale-Invariant Keypoints. International Journal of Computer Vision, 60(2):91–110, 2004. DOI
- Torii, Arandjelovic, Sivic, Okutomi, Pajdla. 24/7 Place Recognition by View Synthesis. CVPR 2015. CVF
- Sakaridis, Dai, Van Gool. ACDC: The Adverse Conditions Dataset with Correspondences for Semantic Driving Scene Understanding. ICCV 2021. CVF
- Shenoi, Lindenberger, Sarlin, Pollefeys. RaCo: Ranking and Covariance for Practical Learned Keypoints. 3DV 2026. arXiv · 代码
- Künzel, Eisert, Hilsmann. RIPE++: Reinforced Keypoint Learning from Positive Pairs Only. LIMIT@ECCV 2026. arXiv · 代码