· 144 min read
论文解读:RoMa 三部曲,从鲁棒稠密匹配到前馈 3D 特征
TL;DR RoMa 是 DKM 之后稠密匹配的里程碑[1]:把粗匹配特征换成冻结的 DINOv2,把卷积解码器换成在 64×64 anchor 上预测概率的 Transformer,再用多尺度鲁棒回归精化;WxBS 的 mAA 从 DKM 的 58.9 提到 80.1(+36%),IMC2022 拿到 88.0,MegaDepth-1500 AUC@5 62.6。两年后的 RoMa v2[2] 把整套流程重做:DINOv3 + 交替注意力的多视图 Transformer、stride-4 粗匹配、两阶段训练、CUDA 局部相关、每像素 2×2 协方差;MegaDepth-1500 62.8/77.0/86.6,ScanNet-1500 33.6/56.2/73.8,640² 吞吐 30.9 对/秒(RoMa 的 1.7 倍),新基准 SatAst 的 AUC@10 从 RoMa 的 23.5 提到 37.0。2026 年的 RoMa-Ω[3] 则换了一个更根本的变量:把 v2 的冻结 DINOv3 主干换成前馈重建模型 VGGT-Ω 的中间层特征,架构、损失、两阶段训练基本不动,重训后在 WxBS/HardMatch 上把 v2 的短板补回来(72.9 / 50.0,v2 为 64.8 / 46.5),RUBIK 88.0,MegaDepth PCK@1 81.7;代价是 1.03B 参数、29.9 GB 显存、12.1 对/秒。三篇的官方代码都能拿到:RoMa 与 RoMa-Ω 含训练代码,RoMa v2 仓库目前只有推理与评测。
- 论文 v1:RoMa: Robust Dense Feature Matching,Johan Edstedt、Qiyu Sun、Georg Bökman、Mårten Wadenbäck、Michael Felsberg,Linköping University / East China University of Science and Technology / Chalmers,CVPR 2024。
- 论文 v2:RoMa v2: Harder Better Faster Denser Feature Matching,Johan Edstedt、David Nordström、Yushan Zhang、Georg Bökman 等,Linköping / Chalmers / Amsterdam / Lund,ECCV 2026。
- 论文 Ω:RoMa-Ω: What Feed-Forward 3D Models Know About Image Matching,David Nordström、Xinyue Zhang、Thibaut Loiseau、Vincent Lepetit、Fredrik Kahl,Chalmers / ShanghaiTech / École des Ponts,ECCV 2026 Workshops。
- 代码:github.com/Parskatt/RoMa(MIT,DINOv2 权重 Apache-2.0);github.com/Parskatt/RoMaV2(MIT,DINOv3 权重单独协议);github.com/davnords/RoMa-Omega(MIT;依赖的 VGGT-Ω 代码与权重为 FAIR 非商用研究许可,权重需申请)。v2 的训练代码未公开,同源的 LoMa train-dev 可作框架参考(稀疏匹配器,见 3.8);RoMa-Ω 的训练代码公开,是更接近 v2 的官方参考(见 4.3)。
- 前作与延伸:DKM、UFM、VGGT-Ω;站内相关:FlexGlue 的稀疏到稠密匹配。
一、动机:两道坎,三次追问
稀疏匹配(SuperGlue[4]、LightGlue[5])先检测关键点,再在关键点之间建立对应;稠密匹配(LoFTR[6]、DKM[7])则直接为一张图的每个像素估计另一张图中的位置,输出稠密 warp 和逐像素置信度。稠密匹配的好处是不依赖检测器的可重复性:纹理弱、视角变化大、极线约束弱的地方,检测器可能一个点都不给,但稠密网络仍然可以从邻域把对应关系推出来。代价是要在低分辨率上先做全局匹配(coarse matching),再逐级上采样精化(refinement),且训练数据远比分类任务稀缺。
RoMa 面对的第一道坎是域过拟合。稠密匹配的监督来自 MegaDepth、ScanNet 这类有限场景的 MVS/RGB-D 深度,模型很容易把训练集的纹理、光照和场景布局记下来;换到 WxBS 这样的跨模态、极端视角数据上就崩。一个自然的想法是冻结一个大规模预训练的基础模型(foundation model)当特征提取器,但 DINOv2 的 patch 是 stride 14 的语义特征,定位精度不够——它能告诉你「这是同一栋建筑」,却很难告诉你「窗框的哪个角」。RoMa 的答案是把粗特征和细特征彻底解耦:粗匹配用冻结的 DINOv2 保证鲁棒性,细特征用单独训练的 VGG19 保证定位精度,两者拼成一个可精确定位的特征金字塔[8]。
第二道坎更本质:粗匹配在运动边界附近是多峰的。当感受野同时覆盖前景和背景,同一个像素可能对应另一张图里的两个不同位置;用 L2 回归去拟合,网络只能给出两个模式的平均值——一个在物理上根本不存在的「中间位置」。RoMa 从尺度空间理论出发,把匹配分布建模成精确对应面与高斯核的卷积,说明粗尺度下条件分布会因运动边界而模糊、多峰;于是粗匹配必须能表达多峰分布,精化阶段在给定初始 warp 后才近似单峰。这条推理直接决定了两个设计:粗匹配用「回归即分类」(regression-by-classification),精化用鲁棒回归。
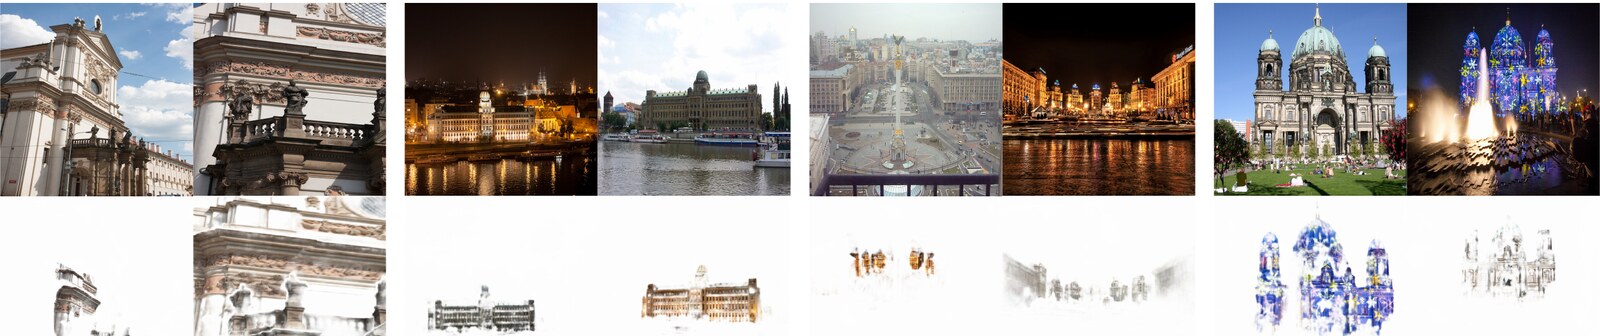
第一代 RoMa 的追问是「怎么同时跨过这两道坎」。它的四个贡献正好对应四件事:冻结 DINOv2 粗特征 + 专用 VGG19 细特征;预测 anchor 概率的 Transformer 匹配解码器;从尺度空间出发的粗/细损失;在 WxBS、IMC2022、MegaDepth-1500 等基准上的系统验证。它把 WxBS 的 mAA 从 58.9 拉到 80.1,相对提升 36%;IMC2022 的 mAA 从 83.8 拉到 88.0;MegaDepth-1500 AUC@5 62.6。
第二次追问来自 RoMa v2:「RoMa 还不够」。它在卫星图—宇航员照片、RUBIK 这类几何挑战上仍然失败;560×560 推理要 198.8 ms,高分辨率显存吃紧;粗匹配 stride 14 导致精化必须从 stride 14 一路做到 1,又贵又难;固定分辨率训练使换分辨率就掉点;而且没有任何不确定性输出,下游 RANSAC 只能把所有残差一视同仁。v2 的贡献可以概括为七件事:DINOv3 + 多视图 Transformer 的新匹配架构;新的匹配损失(稠密 NLL + 鲁棒回归 + overlap);解耦的两阶段训练;CUDA 局部相关核;逐像素预测协方差;覆盖航拍、室内、合成和小基线的 5069 场景数据混合;以及靠归一化 RoPE 与多分辨率训练换来的分辨率鲁棒性。副标题里的 Harder / Better / Faster / Denser 分别对应硬场景、精度、速度、稠密对应。
第三次追问来自 RoMa-Ω,问题更根本:v2 的鲁棒性究竟来自匹配器,还是来自冻结的 DINOv3 特征?DINOv3 的预训练目标是图像上的自监督学习,不是跨视图几何对应;如果换成前馈 3D 重建模型 VGGT-Ω 的中间层特征——这些特征在训练中必须满足多视图几何一致性——匹配会不会更好?Ω 的答案不是简单的「是」:冻结特征里确实有匹配信息,但不能直接拿来做最近邻;原始 3D 预测在分布内能打平 v2,跨域却会崩;真正有效的是「冻结的 3D 特征 + 可训练的跨视图适配器」。它在困难基准上把 v2 的跨模态短板补了回来,代价是 1B 参数和 30 GB 显存。
下面三章按这三代展开,每章末尾给出该代的实验;第五章收束三篇共同的局限,第六章给出选型建议。
二、RoMa:冻结主干 + 回归即分类
2.1 总体架构
RoMa 沿用 DKM 的「匹配—精化」两段式,但把每一段都换掉了:
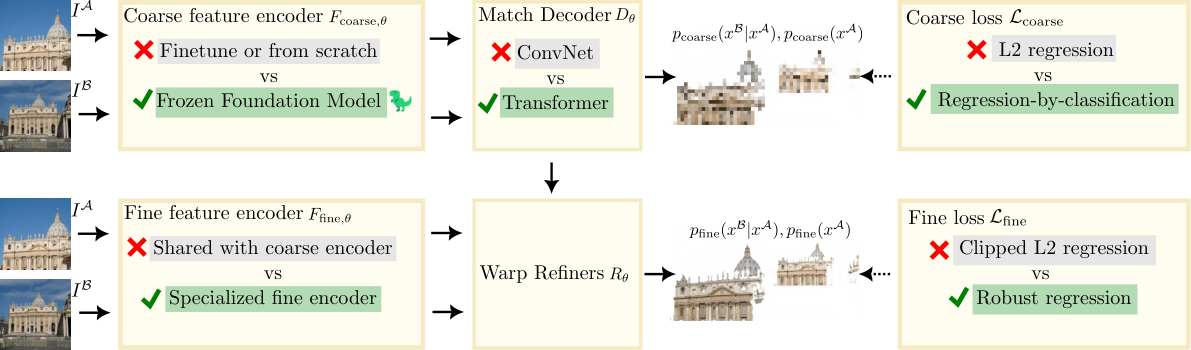
粗匹配分支里,DINOv2 ViT-L/14 的主干完全冻结,取 patch 特征(不用 cls token)后接一个线性投影 + BatchNorm,压到 512 维;随后是 DKM 的 Gaussian Process 匹配编码器(指数余弦核,逆温度 10),把另一张图的特征表示成当前像素的 match embedding。解码器是 5 个 ViT block、8 头、hidden 1024、MLP 4096 的 Transformer,输入是「投影后的 DINOv2 特征 512 维 + GP 输出 512 维」的拼接,输出每个像素在 个 anchor 上的概率,外加一个 matchability 分数。注意这个解码器不用位置编码:作者发现只允许模型通过特征相似度传播,鲁棒性明显更好。
精化分支用单独训练的 VGG19:取每个 2×2 maxpool 之前的特征,stride 1/2/4/8 的维度分别是 64/128/256/512,线性投影 + BatchNorm 到 9/64/256/512;然后接 5 个 refiner,stride 分别是 1、2、4、8、14,每个 refiner 8 个卷积块(5×5 depthwise + BN + ReLU + 1×1),内部通道 24/144/569/1137/1377。refiner 的输入是细特征、上采样后的当前 warp、局部相关(local correlation,窗口大小随 stride 为 0/0/5/7/15)以及当前 warp 的线性编码;输出残差 warp 和置信度 logit。匹配与精化之间切断梯度:粗匹配不会被精化的损失拖着重训,这也让两阶段训练成为可能。
2.2 冻结特征与专用细特征
Table 1 的冻结特征对比很能说明问题:在 MegaDepth 上,VGG19 的 EPE 是 87.6、鲁棒性 43.2%;ResNet50 是 60.2 / 57.5%;DINOv2 是 27.1 / 85.6%。DINOv2 的 EPE 只有 VGG19 的三分之一,鲁棒性翻倍。但 DINOv2 只有 stride 14 的特征,直接拿来精化无法做到亚像素。
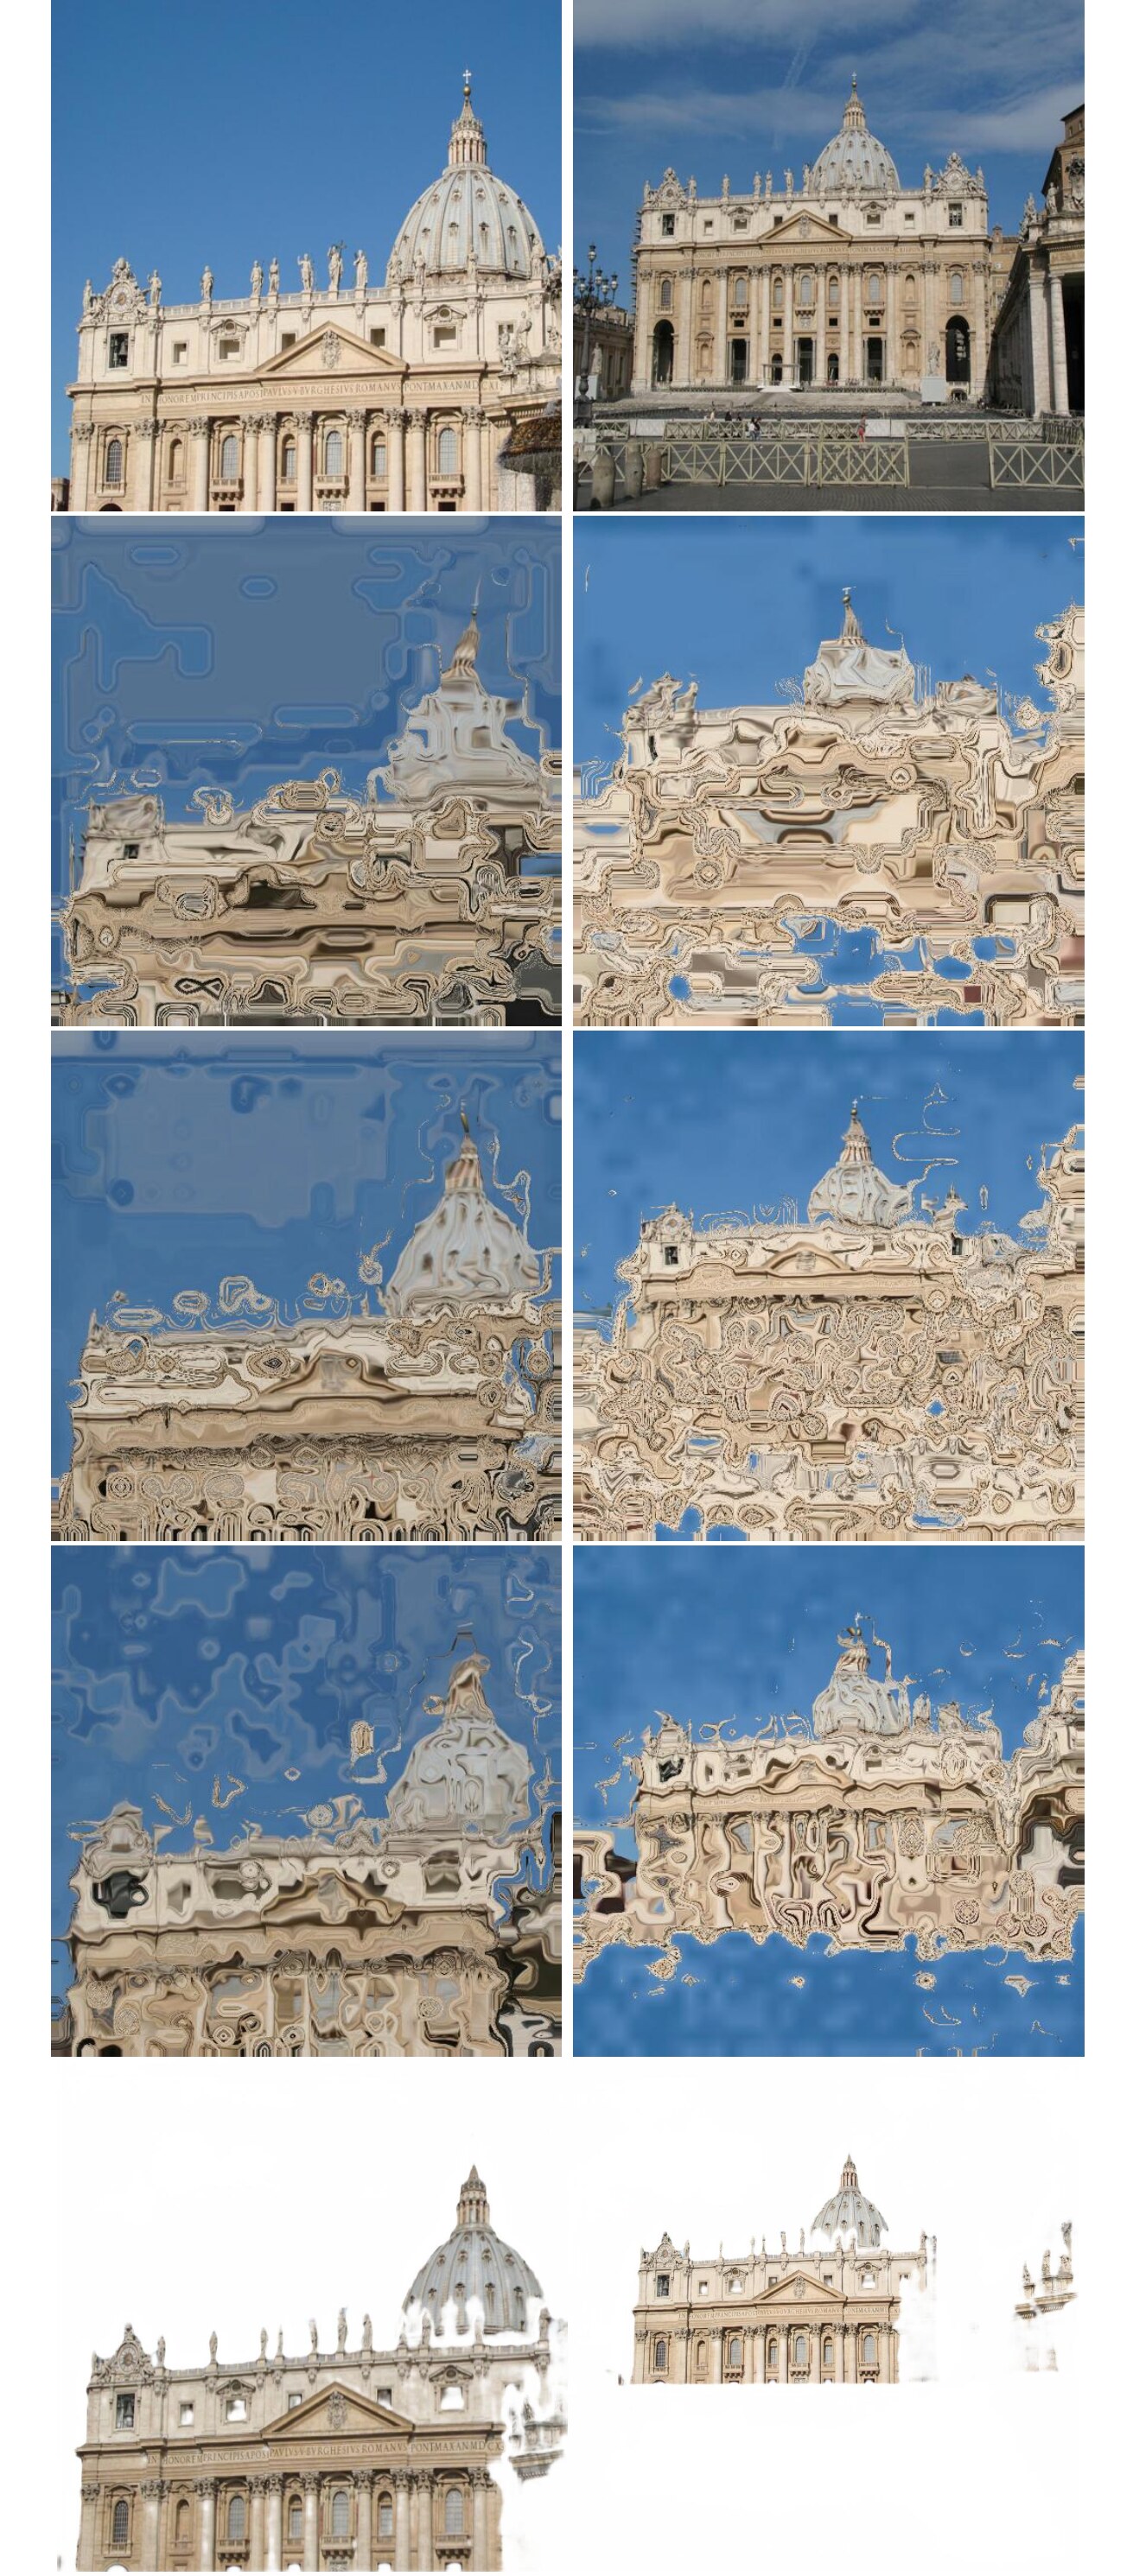
消融表把这件事拆得更细(Table 2,100-PCK@1/3/5px,越低越好):
| 设置 | 改动 | 1px | 3px | 5px |
|---|---|---|---|---|
| I | DKM 基线 | 17.0 | 7.3 | 5.8 |
| II | I + 粗/细编码器不共享(RN50/RN50) | 16.0 | 6.1 | 4.5 |
| III | II + 细特征换 VGG19 | 14.5 | 5.4 | 4.5 |
| IV | III + 解码器换 Transformer | 14.4 | 5.4 | 4.1 |
| V | IV + 粗特征换冻结 DINOv2 | 14.3 | 4.6 | 3.2 |
| VI | V + 粗损失换回归即分类 | 13.6 | 4.1 | 2.8 |
| VII | VI + 细损失换鲁棒回归(RoMa) | 13.1 | 4.0 | 2.7 |
| VIII | VII + 解码器换回 ConvNet | 14.0 | 4.9 | 3.5 |
两个细节值得注意。第一,VGG19 作为粗特征比 RN50 差(Table 1),但作为细特征却明显更好(II→III);这正说明粗匹配和精化需要的能力不同:前者要语义不变性,后者要局部纹理和边缘。第二,DINOv2 的增益主要体现在 3px/5px(V:4.6/3.2),说明它救的是「大范围找对」;VGG19 细特征的增益更多体现在 1px(III→IV 附近),说明它救的是「局部对准」。RoMa 把两者拼起来,而不是指望一个主干同时做好两件事。
2.3 回归即分类:用 anchor 概率表达多峰
粗解码器不直接回归 ,而是把另一张图的坐标空间离散成 个均匀 anchor,预测每个 anchor 的概率:
其中 是 anchor 的坐标, 是基础分布,RoMa 取均匀分布 。输出是 维: 个 anchor 概率加一个 matchability。推理时先取 ,再在 本身及其左、右、上、下四个相邻 anchor(共 5 个)上做局部 soft-argmax:
这个设计的精髓是:分类负责选峰,局部加权负责亚像素。anchor 网格的步长是 (在归一化坐标里约 0.016),单靠 argmax 只能到网格精度;但峰内几个 anchor 的概率加权可以把位置插值到亚像素。更重要的是,多峰分布可以被完整保留:网络可以同时给前景和背景两个 anchor 高概率,而 L2 回归只能输出两者的均值。
把这个玩具模型和真实网络对照:两个高斯峰对应运动边界两侧的两个匹配假设,64 个 anchor 对应 网格的一维切片。拖大「峰间距」、拖小「尺度」时,两峰分开,期望值稳稳落在中间的低谷;把「尺度」拖大,两峰糊成一个宽包,argmax 和局部 soft-argmax 也开始漂移。真实网络不会显式输出高斯混合,而是直接输出 64×64 个 anchor 概率;但「分类保多峰、局部加权保亚像素」的逻辑是一样的。
官方实现:N4 局部 soft-argmax 与粗损失(Parskatt/RoMa @ 77f8d68)
# romatch/utils/utils.py :: cls_to_flow_refine
# https://github.com/Parskatt/RoMa/blob/77f8d68/romatch/utils/utils.py
@torch.no_grad()
def cls_to_flow_refine(cls):
    B,C,H,W = cls.shape
    device = cls.device
    res = round(math.sqrt(C))
    G = torch.meshgrid(
        *[torch.linspace(-1+1/res, 1-1/res, steps = res, device = device) for _ in range(2)],
        indexing = 'ij'
        )
    G = torch.stack([G[1],G[0]],dim=-1).reshape(C,2)
    # FIXME: below softmax line causes mps to bug, don't know why.
    if device.type == 'mps':
        cls = cls.log_softmax(dim=1).exp()
    else:
        cls = cls.softmax(dim=1)
    mode = cls.max(dim=1).indices

    index = torch.stack((mode-1, mode, mode+1, mode - res, mode + res), dim = 1).clamp(0,C - 1).long()
    neighbours = torch.gather(cls, dim = 1, index = index)[...,None]
    flow = neighbours[:,0] * G[index[:,0]] + neighbours[:,1] * G[index[:,1]] + neighbours[:,2] * G[index[:,2]] + neighbours[:,3] * G[index[:,3]] + neighbours[:,4] * G[index[:,4]]
    tot_prob = neighbours.sum(dim=1)
    flow = flow / tot_prob
    return flow

# romatch/losses/robust_loss.py :: RobustLosses.gm_cls_loss(节选)
G = torch.meshgrid(*[torch.linspace(-1+1/cls_res, 1 - 1/cls_res, steps = cls_res,device = device) for _ in range(2)], indexing='ij')
G = torch.stack((G[1], G[0]), dim = -1).reshape(C,2)
GT = (G[None,:,None,None,:]-x2[:,None]).norm(dim=-1).min(dim=1).indices
cls_loss = F.cross_entropy(scale_gm_cls, GT, reduction  = 'none')[prob > 0.99]
certainty_loss = F.binary_cross_entropy_with_logits(gm_certainty[:,0], prob)
losses = {
    f"gm_certainty_loss_{scale}": certainty_loss.mean(),
    f"gm_cls_loss_{scale}": cls_loss.mean(),
}
# forward 里的组合(ce_weight=0.01,见 experiments/train_roma_outdoor.py)
gm_loss = self.ce_weight * gm_cls_losses[f"gm_certainty_loss_{scale}"] + gm_cls_losses[f"gm_cls_loss_{scale}"]
这也解释了消融里 VI 的增益:把粗损失从 L2 换成回归即分类,1px/3px/5px 从 14.3/4.6/3.2 降到 13.6/4.1/2.8;而把 Transformer 换回 ConvNet(VIII),即使其它全部保留也退到 14.0/4.9/3.5。作者认为 ConvNet 解码器会过拟合训练分辨率、过度依赖局部性,导致粗 warp 被过度平滑。
2.4 尺度空间:为什么粗匹配必须多峰
RoMa 用一个很简洁的模型说明多峰的来源。设 是无限分辨率下的精确对应分布,那么在尺度 上观察到的分布是它与各向同性高斯核的卷积:
这可以看成匹配位置随尺度增加的扩散(diffusion)。当场景中有多个物体投影到图像上时,运动边界处会出现对应关系的间断:一个感受野同时看到前景和背景,两个精确对应面在卷积后叠加,条件分布 就出现多个峰。
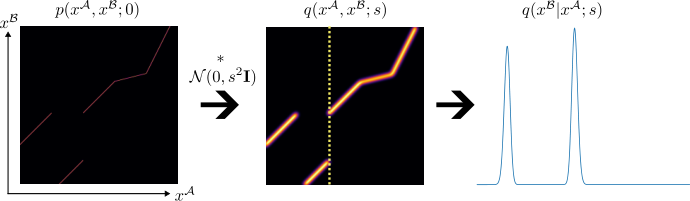
尺度空间模型是论文用来解释「粗匹配为什么多峰」的理论工具,官方仓库没有把它实现成一个单独模块;训练时它落到 2.3 的 anchor 分类损失上(官方 gm_cls_loss 见上一节的代码)。
反过来,精化阶段已经有一个初始 warp,只在对齐后的局部邻域里找残差;此时条件分布近似单峰,用鲁棒回归就足够了。RoMa 的损失设计正是这条推理的直接产物:粗匹配用分类(可多峰),精化用鲁棒回归(单峰、重尾)。
2.5 损失:粗分类 + 细鲁棒
粗损失。把 GT 对应点 落到最近的 anchor ,对预测的 做交叉熵;同时对 matchability 做二元交叉熵,权重 :
这等价于最小化预测分布与尺度空间模型分布 的 KL 散度,只是把 用离散对应样本近似。 控制「条件匹配」和「可匹配性(matchability)」的权衡:前者决定「匹配到哪」,后者决定「这个像素值不值得匹配」。
细损失。每个尺度的 refiner 输出均值 和置信度,作者把精化建模成 generalized Charbonnier 分布(),负对数似然(忽略常数)是
其中 , 随尺度增大。这个损失在局部像 L2(梯度随残差线性增长,保证亚像素精度),在全局则按 衰减(对离群点不敏感),正好匹配「精化阶段条件单峰但可能有重尾」的假设。置信度用二元交叉熵监督,只在 GT 可见的区域计算。
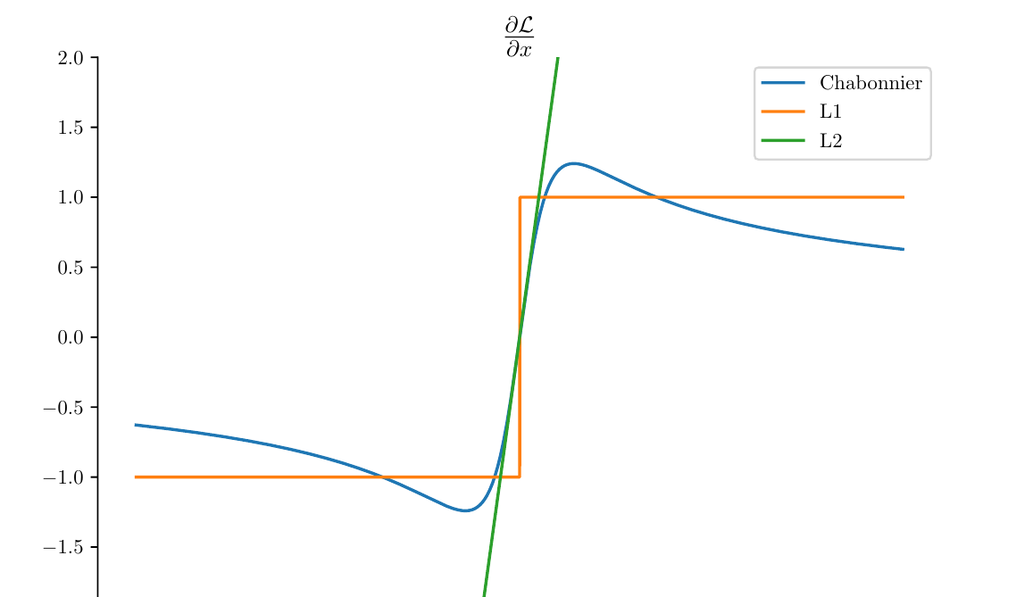
下面的部件把 、残差和损失模式当旋钮,直接看梯度曲线的变化:
官方实现:RoMa 的细损失(Parskatt/RoMa @ 77f8d68)
# romatch/losses/robust_loss.py :: RobustLosses.regression_loss(节选)
# https://github.com/Parskatt/RoMa/blob/77f8d68/romatch/losses/robust_loss.py
def regression_loss(self, x2, prob, flow, certainty, scale, eps=1e-8, mode="delta"):
    epe = (flow.permute(0,2,3,1) - x2).norm(dim=-1)
    ce_loss = F.binary_cross_entropy_with_logits(certainty[:, 0], prob)
    a = self.alpha[scale] if isinstance(self.alpha, dict) else self.alpha
    cs = self.c * scale
    x = epe[prob > 0.99]
    reg_loss = cs**a * ((x/(cs))**2 + 1**2)**(a/2)
    losses = {
        f"{mode}_certainty_loss_{scale}": ce_loss.mean(),
        f"{mode}_regression_loss_{scale}": reg_loss.mean(),
    }
    return losses

# experiments/train_roma_outdoor.py
depth_loss = RobustLosses(
    ce_weight=0.01,
    local_dist={1:4, 2:4, 4:8, 8:8},
    local_largest_scale=8,
    depth_interpolation_mode=depth_interpolation_mode,
    alpha = 0.5,
    c = 1e-4,)
对照代码可以看出两处实现细节:官方把第二项写成 (论文排版为 ),且 ce_weight=0.01 同时加权粗、细的 BCE。RoMa v2 的训练代码没有公开,官方仓库只有推理与评测;因此 v2 的 refiner 损失(3.3 节)没有可引用的官方实现,上面给出的是 v1 的官方代码。
总损失是 。论文还指出,由于匹配与精化之间切断了梯度,网络原则上可以分成两个阶段训练——v2 正是这么做的。消融 VII 把细损失从截断 L2 换成鲁棒回归,1px 从 4.1 降到 4.0、5px 从 2.8 降到 2.7;数字不大,但这是在其它模块都已到位后的净增益。
2.6 推理与采样
推理时,RoMa 先在 560×560 上跑粗匹配与精化,再上采样到 864×864 精化一次(默认设置)。稠密 warp 和置信度不能直接喂给 RANSAC 之类的稀疏鲁棒估计器,所以还需要采样:RoMa 先把置信度低于 0.05 的像素阈值掉,再用 DKM 的 balanced sampling——用匹配分布的 KDE 估计给样本重新加权,让低置信区域也能被采到,避免样本全挤在纹理最丰富的角落。这个细节对下游位姿估计的召回率很重要。
2.7 RoMa 的实验
训练沿用 DKM 的设置:MegaDepth + ScanNet 的随机图像对,学习率 decoder 、encoder (batch 8),消融用 448×448,最终模型用 560×560;评估 ScanNet-1500 时用 ScanNet 训练的子模型,其余用 MegaDepth 子模型。
| 基准 | 指标 | DKM | RoMa |
|---|---|---|---|
| MegaDepth-1500 | AUC@5/10/20 | 60.4/74.9/85.1 | 62.6/76.7/86.3 |
| ScanNet-1500 | AUC@5/10/20 | 29.4/50.7/68.3 | 31.8/53.4/70.9 |
| IMC2022 | mAA@10px | 83.1 | 88.0 |
| WxBS | mAA@10px | 58.9 | 80.1 |
| InLoc DUC1 | 0.25m,2° / 0.5m,5° / 1.0m,10° | 51.5/75.3/86.9 | 60.6/79.3/89.9 |
| InLoc DUC2 | 同上 | 63.4/82.4/87.8 | 66.4/83.2/87.8 |
几个解读:
- WxBS 是最大的故事。这个基准专门收跨模态、跨视角、跨光照的宽基线对,DKM 只有 58.9,RoMa 80.1,相对提升 36%。这不是靠更大的模型堆出来的,而是冻结 DINOv2 + 细特征解耦 + 多峰粗匹配三件事一起起作用。
- IMC2022 是隐藏测试集,RoMa 的 88.0 比此前的 83.8 高 4.2 个点,相对误差降低 26%。这说明增益不是只在公开验证集上过拟合。
- MegaDepth-1500 的绝对提升不大(62.6 vs 60.4),因为这类室内/室外 MVS 场景本来就在训练分布内;RoMa 的价值主要在分布外。
- InLoc 的 DUC1 提升很大,DUC2 较小,后者本身就是更难、更少共视的查询。视觉定位用的是 HLoc[9] 管线,匹配器只是其中一环,端到端增益会被检索和几何估计稀释。
- 运行时间:560×560、batch 8、RTX6000 上,DKM 186.3 ms/对,RoMa 198.8 ms/对,只慢 7%。多出来的开销主要是 Transformer 解码器,但精化部分与 DKM 同构。
三、RoMa v2:更难、更好、更快、更稠密
3.1 总体:两阶段训练 + stride-4 粗匹配
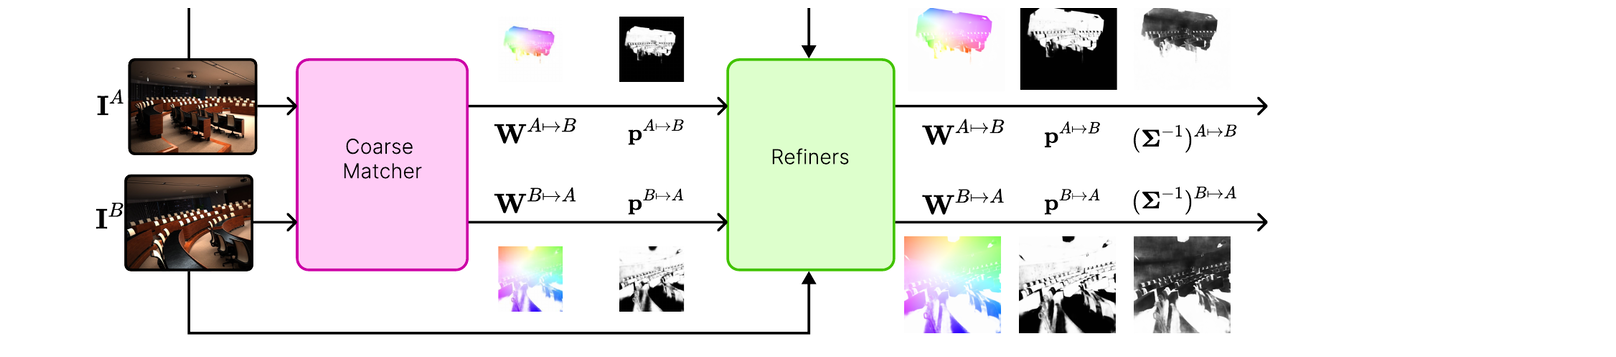
RoMa v2 最重要的结构变化是粗匹配的输出分辨率。RoMa 的 DINOv2 是 stride 14,粗 warp 也在 stride 14,所以精化必须从 14 一路做到 1,共 5 个 refiner;v2 的匹配器通过 DPT 头直接在 stride 4 输出 warp 和置信度,精化只需要 {4, 2, 1} 三个 refiner。这带来三重好处:VGG19 细特征只需提取到 stride 4,计算量大幅下降;显存下降;粗匹配的定位精度更高,精化的负担更小。这也是 v2 能在 640² 上比 RoMa 快 1.7 倍的结构性原因。
训练也改成了严格的两阶段:先训粗匹配器 300k steps、batch 128、学习率 ,约 38M 对;然后冻结匹配器,训 refiner 300k steps、batch 64、学习率 ,约 19M 对。RoMa 虽然也切了梯度,但两个阶段是联合训练的;v2 把「匹配」和「精化」彻底拆开,匹配器可以用更大的 batch 和更纯的匹配损失,refiner 则专心学亚像素残差。
3.2 粗匹配器:DINOv3 + 交替注意力的多视图 Transformer
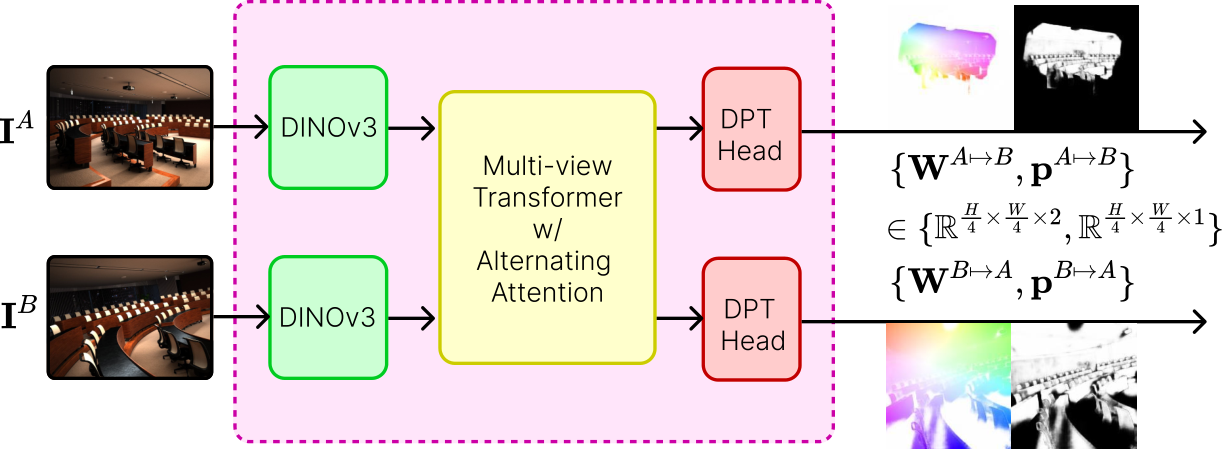
具体来说,DINOv3 ViT-L 取第 11 和第 17 层的特征(各 1024 维),拼接成 2048 维后线性投影到 768 维;两张图的 token 拼在一起,送入一个 ViT-B 规模的多视图 Transformer(dim 768、12 层、12 头、FFN ratio 4,不用 LayerScale),输出再线性映射回 1024 维。这个 Transformer 交替做两种注意力:
- 全局注意力(global attention):两张图的所有 token 一起做自注意力,不加位置编码,让模型纯粹按内容建立跨图关联;
- 帧内注意力(frame-wise attention):每张图内部做注意力,使用归一化的 Axial RoPE,和 DINOv3 的做法一致。
这个「全局/帧内交替」的设计来自 VGGT[10],但 v2 只在帧内注意力上用 RoPE。RoMa 的 GP 匹配编码器被替换成单头注意力:先算相似度矩阵
再用它加权另一张图的位置编码,得到匹配嵌入 。位置编码是 ,其中 是固定的高斯矩阵,。官方代码按 的顺序拼接(torch.cat((x_emb.sin(), x_emb.cos()))),与论文的书写顺序相反,只影响通道排列,不改变表达能力。最后,DINOv3 的第 11/17 层特征、匹配嵌入和 Transformer 输出一起送入 DPT 头(scratch 256,输出维度 [256, 512, 1024, 1024] 对应 stride [4, 8, 16, 32]),在 stride 4 输出 warp 与置信度。
为什么要把 GP 换掉?作者说得很直白:直接在 RoMa 的 GP 前面加多视图 Transformer,梯度经过 GP 后信息量不足,训练也不稳定。把 GP 换成一个可微的单头注意力,跨图信息才能有效地传回匹配器。这个改动是 v2 架构的核心,也是 Table 2 里 HyperSim PCK 从 UFM[11] 的 11.2/48.3/67.4 跳到 30.5/76.7/86.7 的主要原因之一(另一部分是损失)。
匹配损失也换了。RoMa 的粗损失是 anchor 分类 + matchability;v2 改成三项:
其中 是稠密、单向的「最佳 patch」负对数似然:对每个 A 图的 patch ,在相似度矩阵的第 行上做 softmax,取 GT 对应 patch 的概率,
这可以看成 LoFTR 那种粗分类的稠密版本,但 v2 同时保留了一个回归头,用鲁棒回归 直接监督 warp; 是逐像素的 overlap 二元交叉熵。分类项负责「在另一张图的所有 patch 里选对」,回归项负责「把坐标压到亚像素」,两者互补。这也是为什么 v2 不再需要 64×64 的 anchor 网格:stride 4 的 DPT 输出本身就是稠密的,NLL 在整张图的 patch 维度上做分类,分辨率比 64×64 高得多。
实现上要注意:论文写的是「对 做 Softmax」,而 已经是 。把 归一化成 才是概率,这等价于对 做 softmax;代码里直接对余弦相似度做交叉熵,既数值稳定,也和论文的式子一致。
官方实现:相似度矩阵与匹配嵌入的前向(Parskatt/RoMaV2 @ 95c9968)
# src/romav2/matcher.py :: cosine_similarity + _compute_match_embeddings(节选)
# https://github.com/Parskatt/RoMaV2/blob/95c9968/src/romav2/matcher.py
def cosine_similarity(f_A: torch.Tensor, f_B: torch.Tensor) -> torch.Tensor:
    f_A = normalize(f_A, dim=-1)
    f_B = normalize(f_B, dim=-1)
    res = einsum(f_A, f_B, "B H_A W_A D, B H_B W_B D -> B H_A W_A H_B W_B")
    return res

def _compute_match_embeddings(
    *,
    f_A: torch.Tensor,
    f_B: torch.Tensor,
    pos_emb_grid: torch.Tensor,
    temp: float,
    B: int,
    H_A: int,
    W_A: int,
    H_B: int,
    W_B: int,
) -> torch.Tensor:
    attn_AB_logits = (1 / temp * cosine_similarity(f_A, f_B)).reshape(
        B, H_A * W_A, H_B * W_B
    )
    attn_AB = torch.softmax(attn_AB_logits, dim=2)
    attn_AB = attn_AB.reshape(B, H_A, W_A, H_B, W_B)

    match_emb = einsum(
        attn_AB, pos_emb_grid, "B H_A W_A H_B W_B, B H_B W_B D -> B H_A W_A D"
    )
    return attn_AB_logits, attn_AB, match_emb

# Matcher.__init__:omega = 2πW,W ~ N(0,1)
omega = 2 * torch.pi * torch.randn(cfg.dim // 2, 2)
self.omega = nn.Buffer(omega)

# Matcher.forward:χ = sin(2πWx) ⊕ cos(2πWx)
x = get_normalized_grid(B, H_B, W_B)
x_emb = nn.functional.linear(
    x.reshape(B, H_B * W_B, 2), self.scale * self.omega
).reshape(B, H_B, W_B, -1)
pos_emb_grid = torch.cat((x_emb.sin(), x_emb.cos()), dim=-1)
NLL 只在训练时使用,而 RoMa v2 官方仓库没有训练代码,所以没有它的官方实现可引用;上面是官方前向里计算相似度、softmax 权重和匹配嵌入的部分。可以看到代码直接对 做 softmax,等价于把论文的 归一化。
粗匹配器的骨干也从 DINOv2 换成了 DINOv3[12]。线性探针的结果(Table 1):DINOv3 的 EPE 19.0、鲁棒性 86.4%,DINOv2 是 27.1 / 77.0%。但 Table 10 的端到端消融更有意思:DINOv3 在 Hypersim 上更好(79.2 vs 78.1),在 WxBS 上反而略差(34.2 vs 35.6)。作者没有回避这一点——DINOv3 的泛化更强,但对某些跨模态场景未必全面占优。
3.3 精化器:CUDA 局部相关 + 2 的幂通道
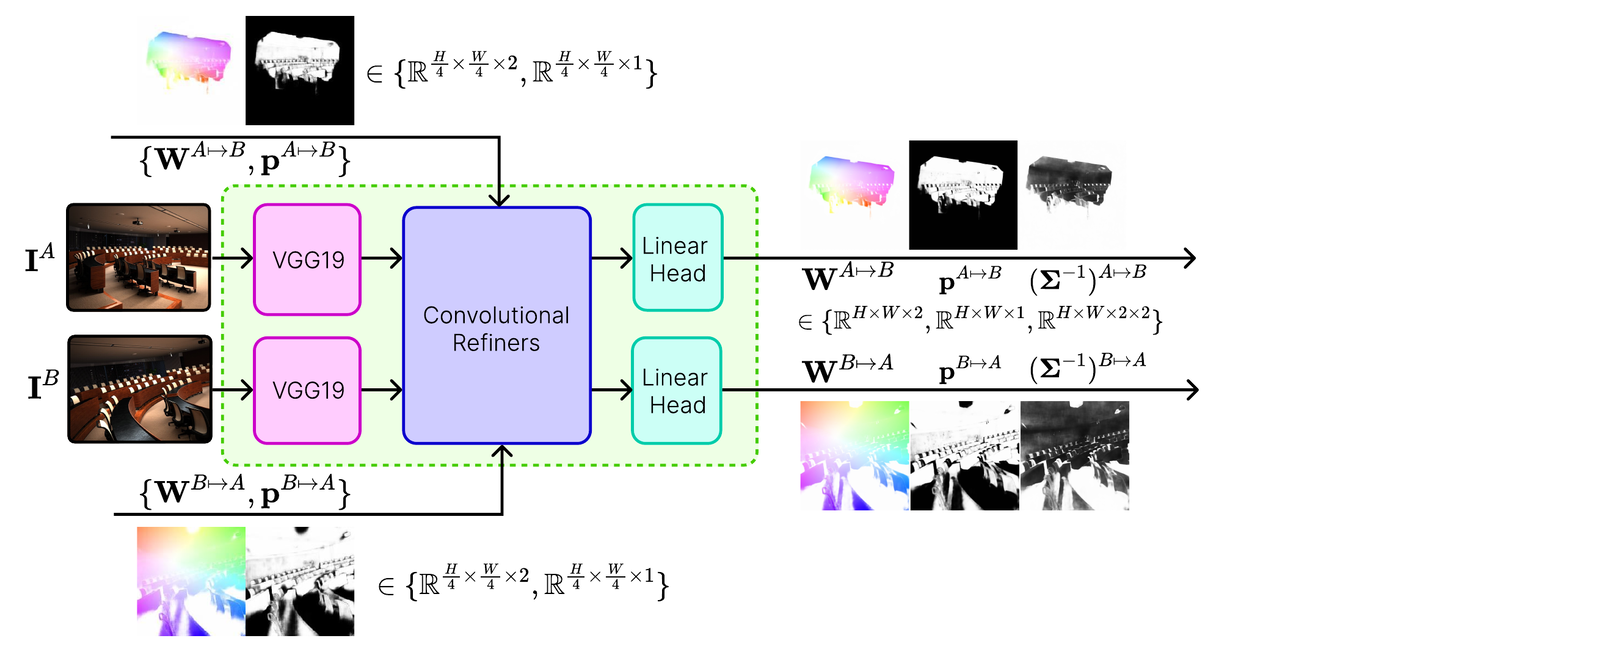
三个 refiner(stride 4/2/1)沿用 DKM/RoMa 的 8 层 5×5 depthwise 卷积结构,但做了两处工程优化:
- 自定义 CUDA 局部相关核。RoMa 的局部相关实现用大量显存,高分辨率下尤其明显。v2 把它写成 PyTorch 的 CUDA 扩展,显存从 5.6 GB 降到 4.8 GB,吞吐从 30.3 提到 30.9 对/秒(640²,H200,batch 8)。这个提升看起来不大,但它让 640² 的批量推理能塞进更小的卡。
- 通道数改为 2 的幂。stride 4/2/1 的 VGG19 特征维度是 192/48/12,线性投影到 256/128/64;拼接后的通道数分别是 512/128/32,正好是 2 的幂,推理速度略有提升。局部相关的窗口是 [7, 3, 0]:stride 1 的 refiner 不做局部相关(上一个 refiner 已经把 warp 推到很近),stride 2 用 3×3,stride 4 用 7×7。
窗口大小不是随便定的:每一级只负责修正上一级残留的那点误差。下面的部件把「当前 warp、GT 残差、相关窗口」放在同一张 patch 网格上,切换 stride 看窗口能覆盖多远:
官方实现:局部相关(Parskatt/RoMaV2 @ 95c9968)
# src/romav2/local_correlation.py :: native_torch_local_corr
# https://github.com/Parskatt/RoMaV2/blob/95c9968/src/romav2/local_correlation.py
# 装了 local_corr 扩展时走 CUDA kernel;这是同一文件里的 PyTorch 回退路径。
def native_torch_local_corr(
    feature0,
    feature1,
    warp,
    local_window,
    B,
    K,
    c,
    r,
    h,
    w,
    device,
    padding_mode="zeros",
    sample_mode="bilinear",
    dtype=torch.float32,
):
    corr = torch.empty((B, K, h, w), device=device, dtype=dtype)
    for _ in range(B):
        with torch.no_grad():
            local_window_coords = (
                warp[_, :, :, None] + local_window[:, None, None]
            ).reshape(1, h, w * K, 2)
            window_feature = F.grid_sample(
                feature1[_ : _ + 1],
                local_window_coords,
                padding_mode=padding_mode,
                align_corners=False,
                mode=sample_mode,  #
            )
            window_feature = window_feature.reshape(c, h, w, K)
        corr[_] = (
            (feature0[_, ..., None] / (c**0.5) * window_feature)
            .sum(dim=0)
            .permute(2, 0, 1)
        )
    return corr
local_window 由 local_correlation() 按 local_radius 生成,包含 个归一化偏移;三个 refiner 分别取 local_radius 7/3/0。官方代码在装了扩展时走 CUDA kernel,回退路径就是上面的 grid_sample 实现。
精化损失是三项之和:
其中 、,Charbonnier 的 、,并按 缩放。注意这里的 比 RoMa 的 0.03 小一个数量级:v2 的粗匹配已经把误差压得很小,精化只需要处理亚像素残差,所以损失在更小的尺度上保持 L2 形状。
3.4 预测协方差:每个像素一个 2×2 精度矩阵
RoMa v2 多了一个 RoMa 和 UFM 都没有的输出:逐像素的 2×2 协方差(更准确地说,是精度矩阵 )。残差定义为
网络不直接回归协方差,而是回归三个数 ,映射成 Cholesky 因子:
这样 天然正定,不需要额外的投影或特征分解。训练用高斯负对数似然:
两个细节:第一,只对共视且残差 px 的区域算这个损失,否则大残差会把协方差拉爆;第二,残差 在损失里被 detach,协方差头不会反过来影响 warp 的回归。精度矩阵是分层预测的:从 stride 4 到 stride 1,每个 refiner 预测一个增量 ,最终 。这利用的是精度(信息)可加的性质:越细的尺度提供越多局部信息。
官方实现:Cholesky 精度参数化与逐级累加(Parskatt/RoMaV2 @ 95c9968)
# src/romav2/refiner.py :: ConvRefiner.forward(节选)
# https://github.com/Parskatt/RoMaV2/blob/95c9968/src/romav2/refiner.py
if delta_confidence.shape[-1] == 4:
    chol_eps = 1e-6
    l00 = F.softplus(delta_confidence[..., 1]) + chol_eps  # this is in pixels
    l10 = delta_confidence[..., 2]
    l11 = F.softplus(delta_confidence[..., 3]) + chol_eps
    p00 = l00 * l00
    p10 = l00 * l10
    p11 = l10 * l10 + l11 * l11
    delta_confidence = torch.stack(
        [delta_confidence[..., 0], p00, p10, p11], dim=-1
    )

if prev_confidence is not None:
    if prev_confidence.shape[-1] == delta_confidence.shape[-1]:
        confidence = prev_confidence + delta_confidence
    else:
        padded_prev_confidence = torch.zeros_like(delta_confidence)
        padded_prev_confidence[..., :1] = prev_confidence
        confidence = padded_prev_confidence + delta_confidence
else:
    confidence = delta_confidence
代码里 delta_confidence[..., 0] 是 overlap logit,后三个数就是 ;p00,p10,p11 是 的三个独立元素(这里用 0/1 下标,对应论文的 1/2)。prev_confidence + delta_confidence 就是分层精度 的实现。高斯 NLL 本身只在训练时计算,官方仓库没有训练代码,所以没有它的官方实现可引用。
协方差在下游怎么用?论文在 HyperSim 上做了两组实验:一组只把预测协方差当作后处理,对 RANSAC 的结果做加权精化;另一组直接把协方差权重塞进 RANSAC 的残差打分。结果是 AUC@1 从 54.9 提到 75.8(仅精化)再到 76.4(RANSAC + 精化),AUC@3/5 也从 79.5/85.9 提到 89.0/92.6 和 89.3/92.8。AUC@1 提升约 20 个点,说明「知道哪里不确定」在严格阈值下比「平均更准」更值钱。
3.5 数据与训练:5069 个场景的混合
RoMa 只在 MegaDepth 和 ScanNet 上训练,v2 则搭了一个 10 个数据集的混合(Table 3):
| 数据集 | 类型 / GT | 采样权重 | 场景数 |
|---|---|---|---|
| MegaDepth[13] | 室外 / MVS | 1 | 169 |
| AerialMegaDepth[14] | 航拍 / MVS | 1 | 124 |
| BlendedMVS[15] | 航拍 / Mesh | 1 | 493 |
| Hypersim[16] | 室内 / 渲染 | 1 | 393 |
| TartanAir v2[17] | 室外 / 渲染 | 1 | 46 |
| Map-free[18] | 物体中心 / MVS | 1 | 397 |
| ScanNet++ v2[19] | 室内 / Mesh | 1 | 856 |
| UnrealStereo4K | 室外 / 渲染 | 0.01 | 8 |
| Virtual KITTI 2 | 室外 / 渲染 | 0.01 | 5 |
| FlyingThings3D[20] | 室外 / 渲染 | 0.5 | 2239 |
| 合计 | 5069 |
这个混合的设计意图很明确:AerialMegaDepth 和 BlendedMVS 提供航拍、大旋转和空对地视角;Hypersim、ScanNet++ 提供室内和纹理弱的结构;TartanAir、FlyingThings3D、VKITTI2 提供合成数据和光流式的稠密监督;Map-free 提供物体中心的近距离场景。航拍数据是 SatAst 和 RUBIK 提升的关键,小基线数据(FlyingThings3D 权重 0.5)则让 v2 在细粒度动态物体上比 RoMa 好——这也是图 10(a) 里吉他那一组想说明的。
训练分辨率是混合的:匹配器在 {512×512, 592×448, 624×416, 688×384, 448×592, 416×624, 384×688} 上训练,refiner 固定 640×640。匹配器 300k steps、batch 128;refiner 300k steps、batch 64。这个训练量比 RoMa 大得多,也是「更好」的代价之一。
3.6 分辨率鲁棒性:归一化网格 RoPE + ω=1
RoMa 的一个实际痛点是换分辨率就掉点。v2 做了三件事:
- RoPE 用在归一化网格上,而不是像素网格。这样 token 之间的距离始终在训练分布内,换分辨率时不会出现「位置编码频率突然变高」的问题。
- 匹配嵌入的位置编码频率固定为 。RoMa 初始化 并让它可学习;v2 发现高频位置编码在分辨率变化时插值很脆弱,干脆固定成低频。作者猜测这也是 UFM 必须在 420×560 固定分辨率推理的原因。
- 多分辨率、多长宽比训练,让模型见过各种网格;refiner 则沿用 RoMa 的「把输入位移按 canonical resolution 重新缩放」的做法,因为卷积核和像素网格绑定,不能靠 RoPE 解决。
这三件事加起来,v2 在训练/推理分辨率不一致时的退化明显小于 RoMa。不过论文没有给一张独立的「分辨率 vs 精度」曲线,定量支撑主要来自 3.14 节讨论的亚像素精度消融。
3.7 EMA 去偏与新基准 SatAst
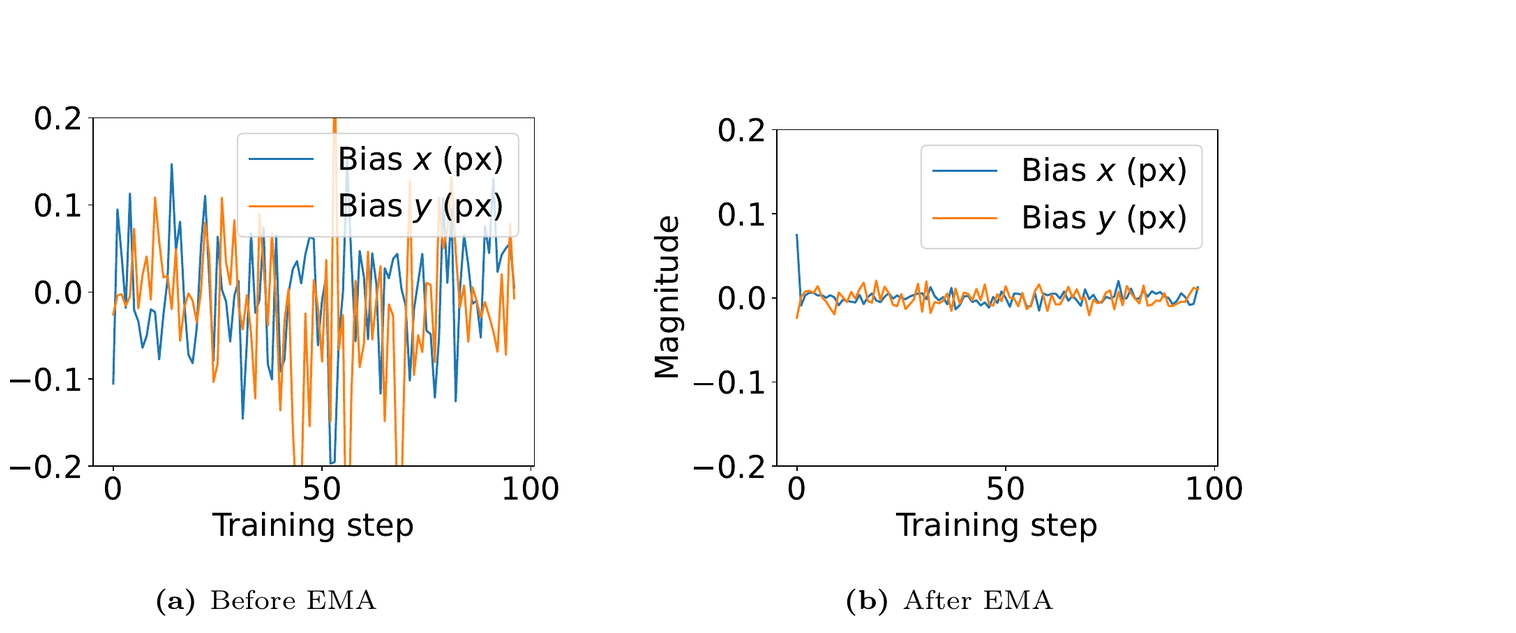
训练 refiner 时,作者观察到预测有约 ±0.1 px 的亚像素偏置,而且这个偏置随训练步几乎随机波动(图 9a)。这不是数据问题,而是优化过程的噪声;解决办法很朴素:保存权重的指数滑动平均(EMA,decay 0.999),推理时用 EMA 权重。偏置被压平(图 9b),MegaDepth-1500 从 61.4/75.8/85.7 提到 62.8/77.0/86.6,ScanNet-1500 基本不变(33.6/56.1/73.5 → 33.6/56.2/73.8)。一个几乎零成本的 trick,在亚像素敏感的基准上值 1.4 个 AUC@5。
SatAst 是 v2 新提出的基准:从 EarthMatch[21] 取 39 对「宇航员照片—卫星图」,每对手工标 10 个对应点,再把卫星图旋转 90° 生成副本,共 156 对;用 RANSAC 估计单应,算标注点的重投影 AUC@10px。难点有三个:卫星图对大多数匹配器都是分布外;尺度变化大;平面内旋转大。结果 RoMa v2 37.0、RoMa 23.5、UFM 1.8——UFM 几乎完全失败,RoMa v2 比 RoMa 高 13.5 个点。这个基准很小(156 对),方差不会小,但它是目前唯一系统评估「卫星—宇航员」跨模态匹配的公开基准。
3.8 同源项目 LoMa:一份可参考、但不能当作 v2 官方的训练代码
截至 2026 年 11 月,RoMa v2 仓库仍然只有推理和评测。作者 Parskatt 在 issue #24 里说短期内无法投入开源,并提到 LoMa 的训练代码「very similar to RoMaV2」。LoMa[22] 是作者有重叠的团队(Nordström、Edstedt、Bökman 等)的 ECCV 2026 Oral 工作,代码结构主要沿用 RoMaV2(README 还注明大部分代码由 Parskatt 编写);它的 train-dev 分支公开了 descriptor → matcher 的两阶段训练脚本,数据从 MegaDepth 起步,支持 torchrun 多卡。
但 LoMa 不是 RoMa v2 的复刻:它是 LightGlue 家族的稀疏关键点匹配器,输出关键点对,不输出稠密 warp、overlap 和逐像素精度矩阵;训练损失是 GlueLoss,不是 v2 的 NLL + warp + overlap + precision NLL。README 也明确警告 train-dev 是开发分支,训练复现「has not been validated」。因此它可以作为同源训练框架的参考,但不能当作 v2 的官方训练实现,更不能把 LoMa 的命令当成 v2 的复现步骤。
3.9 相对位姿:MegaDepth-1500 与 ScanNet-1500
前八节讲的是 v2 的机制和代码现状,从这一节开始看它在公开基准上的表现。
下面的部件把论文表 4–7、11 的主要数字放在一起。选基准、点指标,就能看到不同方法在同一协议下的排序;橙色是 RoMa v2,灰色是其它方法。
先看相对位姿。MegaDepth-1500 上,RoMa v2 62.8/77.0/86.6,只比 RoMa 高 0.2/0.3/0.3——这几乎是噪声级别的差距,因为 MegaDepth 本来就在两者的训练分布里。真正拉开差距的是 ScanNet-1500:RoMa v2 33.6/56.2/73.8,RoMa 31.8/53.4/70.9,AUC@10 高 2.8 个点,AUC@20 高 2.9 个点。但也要诚实地说:在这个基准上,前馈 3D 重建方法 MASt3R[23](33.6/56.8/74.1)和 VGGT[10](33.9/55.2/73.4)与 RoMa v2 基本打平,MASt3R 的 @10/@20 还略高,Reloc3r[24](34.8/58.4/75.6)甚至更高。论文自己的措辞也是「on par with VGGT and MASt3R」。所以「匹配器打败前馈 3D 模型」这句话只对 MegaDepth 成立,对 ScanNet 不成立。
3.10 视觉定位
Map-free 上,RoMa v2 的 Precision 73.3、AUC 89.6,比 RoMa 的 59.7/84.4 高 13.6/5.2;InLoc 的 DUC1 从 60.6/79.3/89.9 提到 67.7/84.3/94.4,DUC2 从 66.4/83.2/87.8 提到 73.3/86.3/90.8,论文称在 InLoc 公开榜上排第一。注意这两项都用 HLoc[9] 管线,匹配器只是其中一环;Map-free 还用了 DA3 的单目深度做度量尺度。增益能传到端到端,说明匹配质量的提升没有被检索和几何估计吃掉。
3.11 稠密匹配:六个数据集全面开花
Table 6 和 Table 7 的六组稠密基准是 v2 优势最大的地方:
- TA-WB(UFM 的主场):RoMa v2 的 EPE 13.82,RoMa 60.61,UFM 15.85;PCK@1 67.7 vs 35.1 vs 31.3。v2 在 UFM 自己提出的「宽基线 + 光流式监督」基准上反超了 UFM,而且 PCK@1 是两倍多。
- AerialMegaDepth:EPE 4.12,RoMa 25.05,相对降低 84%;PCK@3 81.1 vs 65.0 vs 61.6。航拍大旋转和空对地视角是 v2 数据混合的直接收益。
- MapFree:EPE 2.03 vs 8.55 vs 3.59;PCK@1 55.4 vs 45.8 vs 31.6。
- MegaDepth(640² 稠密):EPE 1.47 vs 2.34 vs 3.15;PCK@1 79.6 vs 74.8 vs 55.3。注意 RoMa 是在 MegaDepth 上充分训练的,v2 还能再低 0.87 px,说明架构/数据/训练的综合收益不是「换个大模型」能解释的。
- ScanNet++ v2:EPE 4.00 vs 27.52 vs 6.93;PCK@1 45.5 vs 20.2 vs 31.4。RoMa 在这个室内扫描基准上崩得厉害,v2 的室内数据(Hypersim + ScanNet++)起了作用。
- FlyingThings3D:EPE 0.93 vs 5.68 vs 1.33;PCK@1 89.4 vs 78.0 vs 83.4。动态小物体的细粒度匹配是 v2 的另一个强项。
这里有一个值得注意的协议细节:RoMa 和 RoMa v2 都是直接吃 640×640,UFM 则先缩到它建议的 420×560,再把预测双线性上采样回 640×640(论文称 UFM 在高分辨率上精度会明显退化)。这对 UFM 不完全公平,但论文解释了原因;更重要的是,即便给 UFM 更有利的低分辨率,v2 在六个基准上仍然全胜。
3.12 多模态与几何挑战:有输有赢
WxBS 是 v2 唯一明显输给 RoMa 的基准:RoMa 60.8,v2 55.4,UFM 42.3。注意这里的 60.8 是 v2 论文重测的 RoMa;RoMa v1 自己报告的 80.1 用的是 WxBS v1.1 的更新 GT 和评测协议,两者不能直接比较,结论只应看同一张表内的排序。作者把原因定位在 IR-to-RGB 子集:v2 和 UFM 都在这个子集上挣扎,而 RoMa 的冻结 DINOv2 + VGG19 组合对模态变化更稳。这是一个真实的 trade-off:v2 用了更大的数据混合、更强的 DINOv3、更复杂的训练,但在「跨模态外观」这一维上没有全面超过 v1。DINOv3 的 WxBS 消融(34.2 vs DINOv2 的 35.6)也印证了这一点。
作者有重叠的稀疏匹配器 LoMa 则在这个短板上更进一步:README 报告 LoMa-B 在 WxBS 上 mAA@10px 为 68.8,作者称更重的 LoMa-G 在该基准上超过 RoMa 家族[22]。但 LoMa 输出关键点、不是稠密 warp,评测协议也与这里的稠密表不同,所以这个数字只说明「跨模态稀疏匹配」仍在快速进步,不能直接与 60.8/55.4 相减。
SatAst 上则是 v2 大胜:37.0 vs RoMa 23.5 vs UFM 1.8。这个基准的卫星图对大多数匹配器都是 OOD,v2 的航拍数据(AerialMD、BlendedMVS)和旋转鲁棒性带来了明显收益;但 37.0 的绝对水平仍然不高,说明「卫星—宇航员」还远未解决。RUBIK 上 v2 57.3,超过此前的 DUSt3R[25] 54.8,也高于 UFM 53.1 和 RoMa 47.3,说明在大旋转 + 小重叠的几何挑战上 v2 的架构和数据都起了作用。
3.13 运行时间与显存
| 方法 | 吞吐(pairs/s)↑ | 显存(GB)↓ |
|---|---|---|
| UFM | 43.0 | 16.2 |
| RoMa | 18.5 | 4.7 |
| RoMa v2(无 CUDA 核) | 30.3 | 5.6 |
| RoMa v2(有 CUDA 核) | 30.9 | 4.8 |
640×640、batch 8、H200。v2 比 RoMa 快 1.7 倍,显存几乎持平(4.8 vs 4.7 GB);UFM 更快,但显存是 v2 的 3.4 倍。这个组合意味着 v2 在「单卡高分辨率批量推理」的场景里更实用:你可以在同样的显存下跑更大的 batch,或者用更少的卡跑同样的吞吐。RoMa 在 560×560 上是 198.8 ms/对,v2 在 640² 上是 30.9 对/秒(约 32.4 ms/对),但这个对比的分辨率和硬件不同,不能直接相除;论文的公平对比是同一张表里的 30.9 vs 18.5。
3.14 消融:哪些设计真的有用
- EMA:Mega-1500 61.4/75.8/85.7 → 62.8/77.0/86.6;ScanNet 几乎不变。说明亚像素偏置主要影响高精度基准。
- 骨干:DINOv2 在 WxBS 上 35.6、Hypersim 78.1;DINOv3 是 34.2、79.2。DINOv3 不是全面更好,跨模态场景反而略退。
- 协方差:HyperSim AUC@1 54.9 → 75.8(仅精化)→ 76.4(RANSAC + 精化),AUC@3/5 提升约 10/7 个点。这是「不确定性」最直接的变现。
- Subpixel 精度:把 v2 的残差按 UFM 的分布做 quantile mapping,Mega-1500 从 62.8/77.0/86.6 掉到 46.3/63.7/77.4。说明 v2 在 MegaDepth 上的领先,很大一部分来自更准的亚像素,而不是「大范围找对」。
- 架构:HyperSim PCK 上 RoMa v2 的 30.5/76.7/86.7 远高于 UFM 的 11.2/48.3/67.4;这个对比同时包含了多视图 Transformer、NLL 损失和数据混合的贡献,不能单独归因。
3.15 定性结果
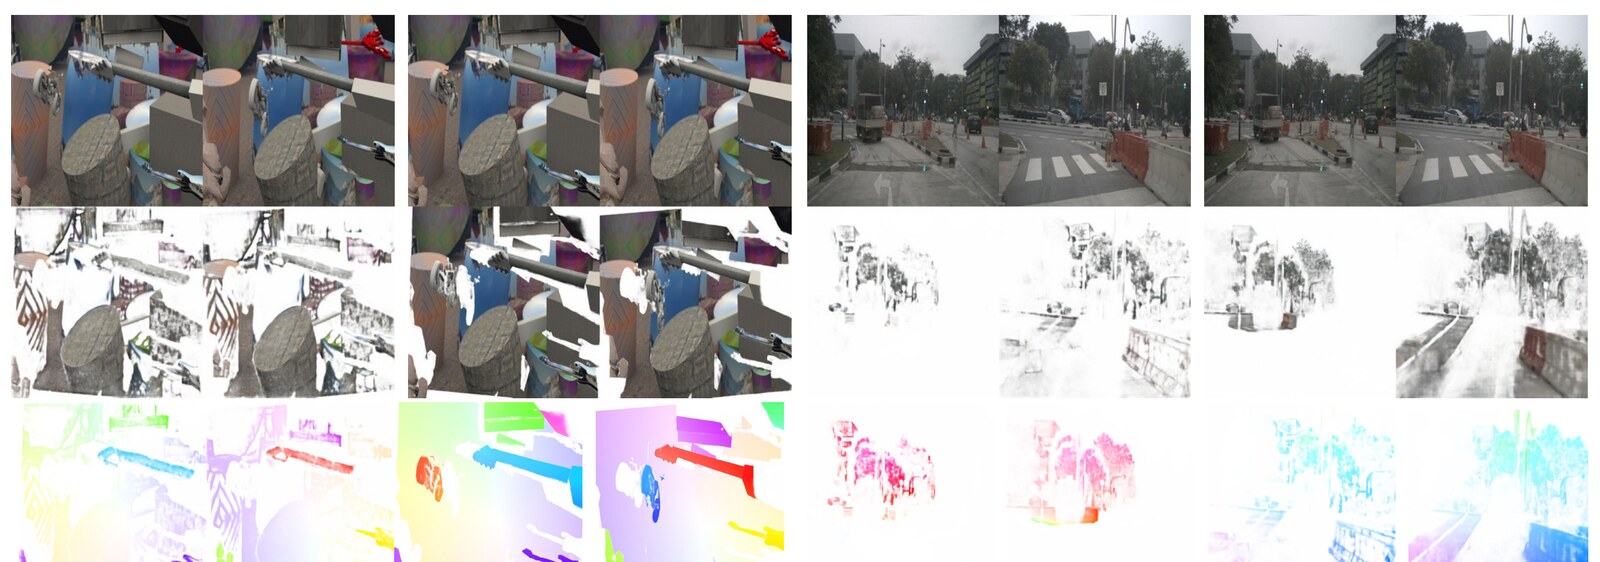
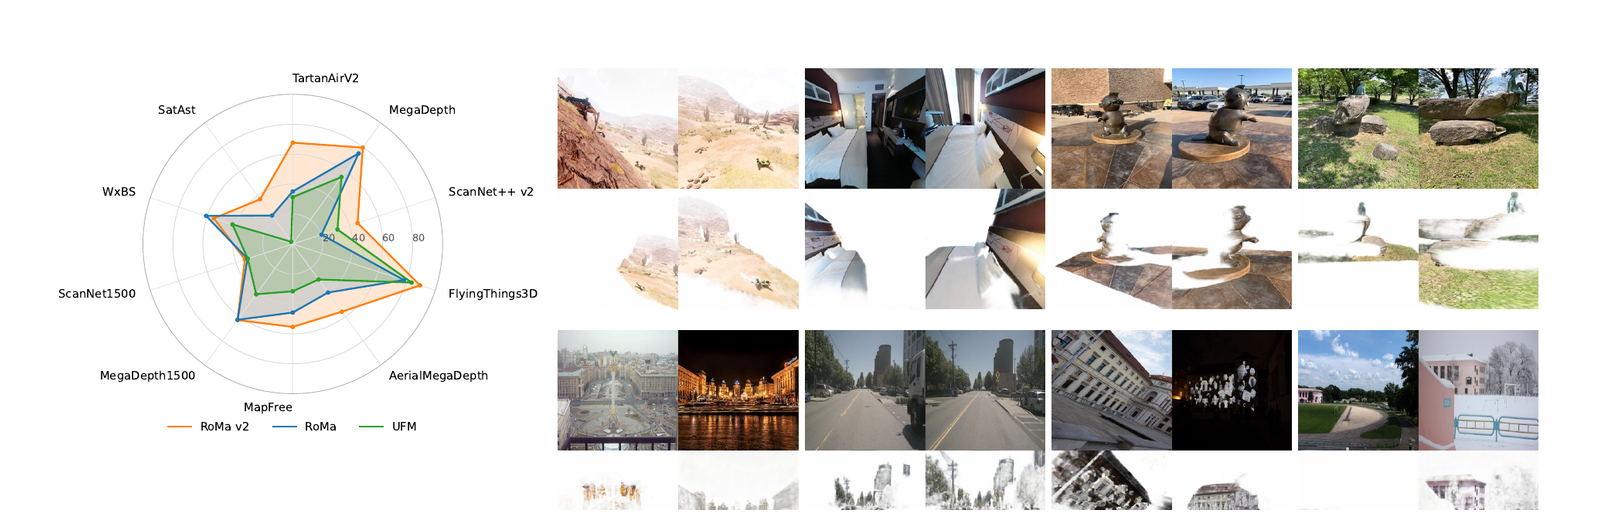
定性结果和定量结论一致:v2 的优势集中在「小物体/动态物体」「纹理弱」「大视角/航拍」三类;在跨模态(IR-RGB)上 RoMa 仍然更稳。这也提醒读者,不存在一个在所有维度都更好的匹配器,选型要看下游场景。
四、RoMa-Ω:把冻结主干从 DINO 换成 VGGT-Ω
RoMa-Ω 是这条线上最新的一篇(arXiv 2026 年 9 月,ECCV 2026 Workshops),作者是 Nordström、Xinyue Zhang、Loiseau、Lepetit、Kahl,和 RoMa/RoMa v2 的作者群有重叠(Nordström 也是 LoMa 的一作)。第一章已经把问题摆出来了;这一章按「先探测、再改造」展开:先看冻结特征的零样本匹配和 VGGT-Ω 原始 3D 预测的直接匹配,再看在冻结特征上训练完整匹配器的结果。三层探测回答的是两个不同的问题——特征里有没有匹配信息,以及能不能直接拿来用。
4.1 三个层次的探测:特征、预测、匹配器
第一层是冻结特征的零样本匹配。给定查询点 和特征 ,在另一张图的每个位置 上算余弦相关
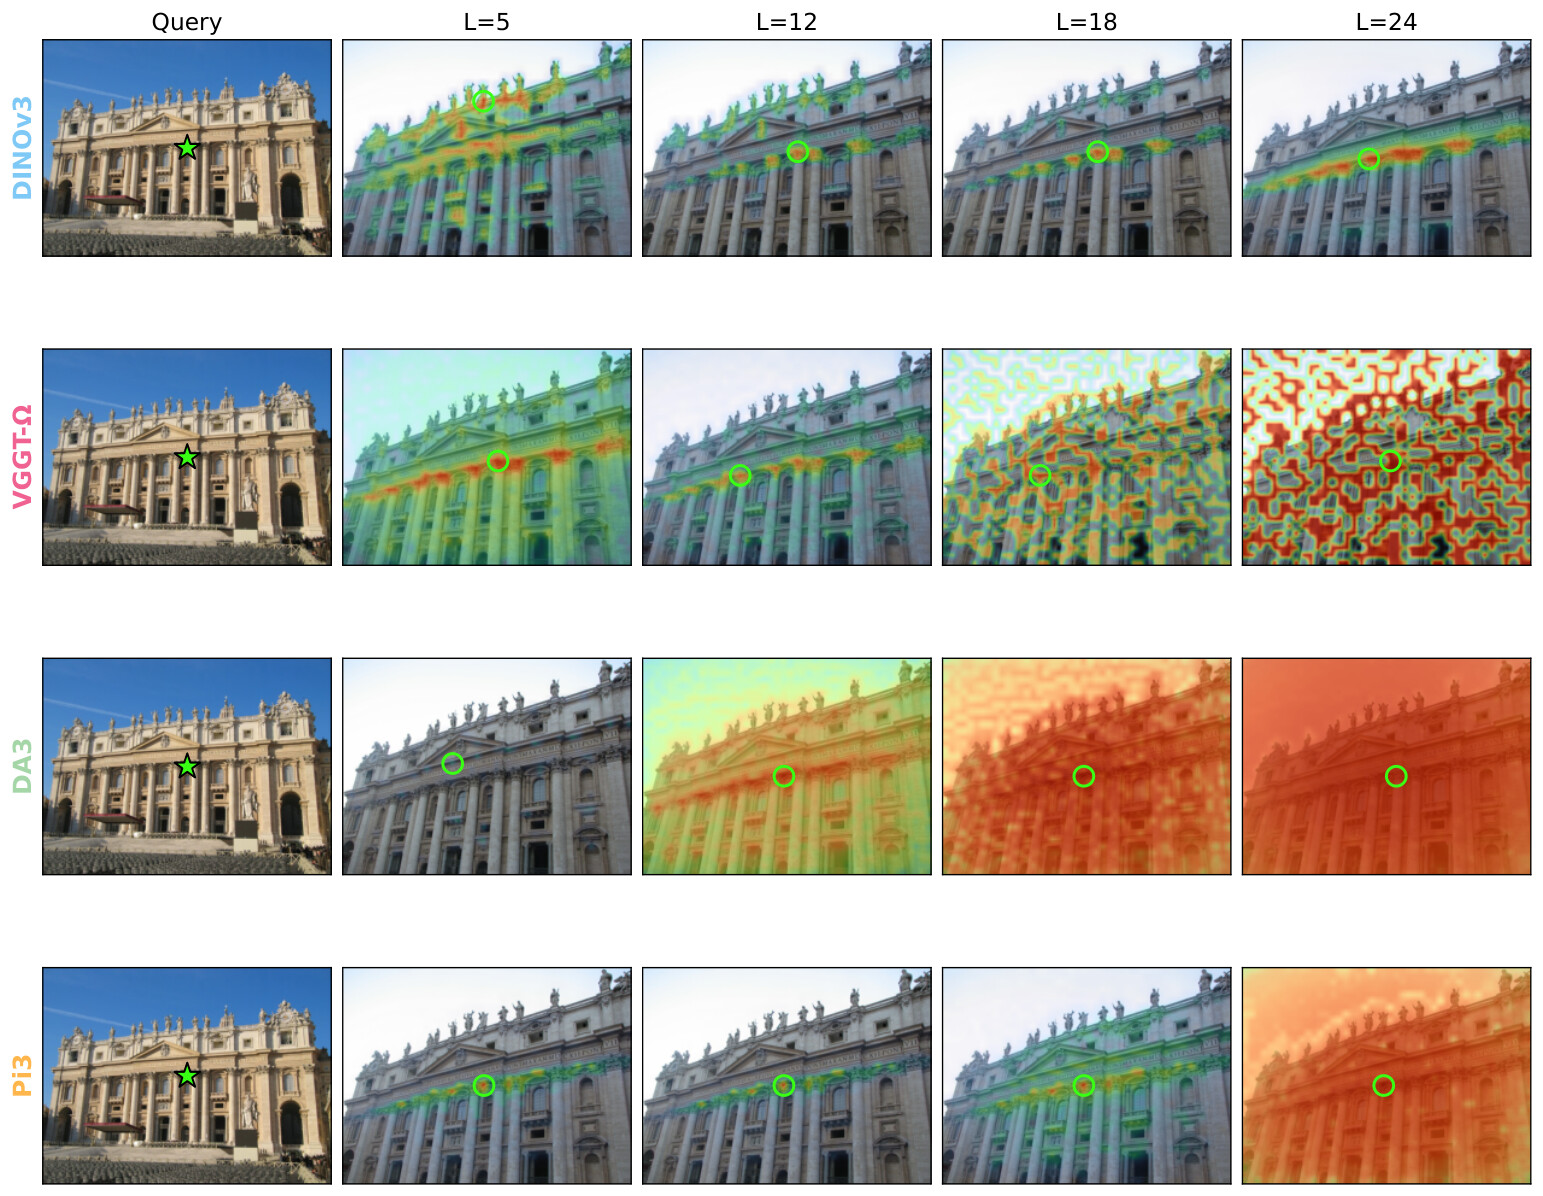
取 作为对应。图 12 把 DINOv3、VGGT-Ω、DA3、Pi3 的第 5/12/18/24 层并排:DINOv3 越往后相关峰越尖,能稳稳落在真实对应上;三个重建模型恰好相反,后层的相关图明显变糊,尽管全局最大值经常仍落在正确位置。作者把原因归到 DINOv3 的 Gram anchoring——它显式约束 patch 级相似度不要塌;重建模型只为跨视图几何一致性优化,没有义务保留 patch 之间的可区分性。论文 Fig. 4 的注意力图也是同一现象:中间层的峰最可解释,最后一层反而散。
第一层还有线性探针:如果信息还在、只是不在「匹配友好」的坐标里,那么只训练一个线性投影 + 小解码器就应该能把它读出来。论文 Fig. 5 正是这个结果:零样本下 DINOv3 强、重建模型后层塌;换成线性探针后趋势反转,重建模型的后层大幅回升并稳定超过 DINOv3,其中 VGGT-Ω 最强。这个对照很关键——它说明「冻结特征能不能直接匹配」和「冻结特征里有没有匹配信息」是两个问题。
第二层是直接用 VGGT-Ω 的原始 3D 预测,不训练任何东西。用预测的深度和相机把像素 warping 过去,或者在 3D 点里做互为最近邻,再用本质矩阵 + RANSAC 估相对位姿。Table 1 在 ScanNet-1500 上给出的数字很意外:depth warp 34.2/57.6/74.8,直接读相机 34.2/57.6/74.9,原版 VGGT 33.9/55.2/73.4,RoMa v2 33.6/56.2/73.8——不训练就能和 v2 打平甚至略高,互为最近邻反而差(22.7/43.0/59.5)。但 Table 2 的 VGGT-Ω 行马上暴露边界:RUBIK 84.3 AUC@20° 很强,WxBS 只有 29.0、HardMatch 只有 20.2。作者的解释是前馈重建模型的训练采样多是视频里时间上相邻的帧,见惯了小基线、温和视角;一旦换成极端光照、模态或大视角,原始预测就崩。所以原始 3D 预测不是即插即用的匹配器,真正要做的是在冻结特征上学习一个匹配专用的适配器。
第三层是完整匹配器。作者把 RoMa v2 的粗匹配阶段原样搬过来:冻结主干、可训练 Transformer 解码器、DPT 头,只把 DINOv3 换成 VGGT-Ω[26]。论文 Fig. 6 里 VGGT-Ω 在所有解码器深度上都高于 DINOv3,但差距随深度增加而缩小——足够强的解码器能部分补上主干的差距。这三层实验合起来,才有了下面「换主干」的决定。
4.2 架构:只换主干,但换得很讲究
RoMa-Ω 的骨架就是 RoMa v2:冻结主干 → 粗匹配器(相关 + DPT 头)→ 卷积精化器。唯一的结构性改动是主干,但 VGGT-Ω 的输出形态和 DINOv3 不同,直接替换并不够。
VGGT-Ω 是 24 层 Transformer,交替做帧内注意力和跨视图注意力。论文从第 {5, 12, 18, 24} 层取 patch 特征,并把每层的帧内 token 与跨视图 token 拼接,得到一个 2048 维描述子(1024 + 1024)。帧内 token 保留单张图的外观与位置,跨视图 token 带几何对齐信息;两者都留着,比只取一路更稳。
最深的第 24 层特征在进入相关之前,先过一个 12 层的跨视图 Transformer。它把两个视图的 token 拼在一起做联合推理,再以残差方式加回:
实现上先把 2048 维降到 768 维(global_in),在这个宽度上跑 12 层自注意力,再用 global_out 升回 2048;global_out 的权重和偏置零初始化,所以训练第 0 步 ,精化器是恒等映射,模型从「原始冻结特征」出发,只学习要加的那一点修正。这个设计让相关用的描述子变成可训练的,而主干仍然完全冻结。
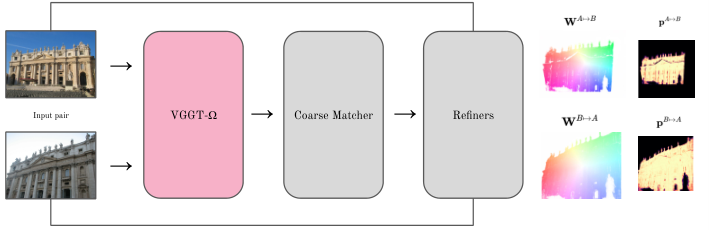
DPT 头只吃第 {18, 24} 两层特征(四个缓存层里的后两个),并把匹配嵌入加到最后两层上;相关和 DPT 都在 1024 维的工作宽度上跑,先做一次降维。Table 6 的消融 V 把 DPT 改回 2048 维全宽,结果反而略差——更宽不等于更好;论文没有展开原因,一个直观解释是降维抑制了噪声。其余部分与 v2 完全一致:粗匹配输出 warp 和 confidence,精化器按 stride {4, 2, 1} 逐级上采样并累计精度矩阵。论文刻意不改这些,是为了把「主干」这一个变量单独隔离出来。
Table 6 的消融阶梯说明每一步都不能省:只把 DPT 头接到冻结的 VGGT-Ω 上(II),Hypersim PCK@1 只有 4.9,还不如 v2 基线(I)的 21.0;加回 v2 的 Transformer 解码器(III)立刻回到 21.5/64.6/78.8;再把 DPT 的输入收窄到最深的 {18, 24} 两层(IV),跳到 27.8/68.5/80.9。IV 同时把相关计算的工作宽度从 2048 降到 1024,而 V 把 DPT 改回 2048 全宽,反而掉到 23.2/65.1/79.1。换主干不是把 DINOv3 拔掉、VGGT-Ω 插上就完事,跨视图适配器才是把冻结特征变成可匹配描述子的关键。
| # | 改动 | Hypersim PCK | ETH3D PCK |
|---|---|---|---|
| I | RoMa v2 基线 | 21.0/61.8/74.2 | 40.6/85.8/94.2 |
| II | VGGT-Ω + DPT 头 | 4.9/28.3/48.0 | 8.7/47.5/70.7 |
| III | II + Transformer 解码器 | 21.5/64.6/78.8 | 34.1/82.3/93.0 |
| IV | III + 只用 {18, 24} 两层 | 27.8/68.5/80.9 | 43.4/87.7/95.1 |
| V | IV + DPT 用满 2048 维 | 23.2/65.1/79.1 | 37.6/85.3/94.4 |
数据来自论文 Table 6:粗匹配器训练 100K steps 后的 PCK(%),Hypersim / ETH3D 各三根柱子是 1/3/5 px 阈值。
RoMa-Ω 官方代码:VGGT-Ω 特征提取与零初始化跨视图精化(matcher.py @ 24c693a)
def _vggt_features(self, img_A, img_B):
    B = img_A.shape[0]
    H_p = img_A.shape[-2] // self.cfg.patch_size
    W_p = img_A.shape[-1] // self.cfg.patch_size
    images = torch.stack((img_A, img_B), dim=1)  # (B, 2, 3, H, W)

    grad_ctx = torch.no_grad() if self.cfg.vggt_frozen else nullcontext()
    with grad_ctx:
        aggregated_tokens_list, patch_token_start = self.vggt.aggregator(images)

    feats = []
    for tokens in aggregated_tokens_list:
        if tokens is None:
            continue
        patch_tokens = tokens[:, :, patch_token_start:, :]
        feats.append(patch_tokens.reshape(B, 2, H_p, W_p, self.feat_dim))
return feats, H_p, W_pself.global_in = nn.Linear(self.feat_dim, cfg.global_dim) # 2048 -> 768
self.global_refiner = nn.ModuleList(
[
SelfAttentionBlock(dim=cfg.global_dim, num_heads=num_heads)
for _ in range(cfg.num_global_layers) # 12 层
]
)
self.global_out = nn.Linear(cfg.global_dim, self.feat_dim) # 768 -> 2048
nn.init.zeros_(self.global_out.weight)
nn.init.zeros_(self.global_out.bias)a = self.global_in(feat_A.reshape(B, H * W, D))
b = self.global_in(feat_B.reshape(B, H * W, D))
x = torch.cat((a, b), dim=1) # (B, 2*H*W, global_dim): all tokens, both views
for blk in self.global_refiner:
x = blk(x)
x = self.global_out(x) # back up to feat_dim; zero-init -> 0 at step 0
d_A, d_B = x[:, : H * W], x[:, H * W :]
refined_A = feat_A + d_A.reshape(B, H, W, D)
refined_B = feat_B + d_B.reshape(B, H, W, D)4.3 训练:两阶段、数据混合,以及一次真实的训练崩塌
RoMa-Ω 沿用 v2 的两阶段:先训粗匹配器,再冻结它训精化器。粗匹配 500K steps、batch 128,论文用 16×A100 约 2 天;精化 300K steps、batch 64,8×A100 约 2 天;学习率都是 。粗匹配在多分辨率/多长宽比上训练:512²、592×448、624×416、688×384 及其转置;精化只训 640²。README 的训练脚本按 8 卡写,并注明每阶段约 3 天,和论文的 16 卡数字不同——复现时按自己的卡数折算。
数据是 18 个来源的混合(Table 7),大体沿用 v2/LoMa 的配方,新增 MegaScenes、MegaDepth-X、MegaSynth、SpatialVID 等。权重设计很有意思:大多数数据集权重 1;Mapillary、Aria、CO3Dv2、MegaSynth 降到 0.1;SpatialVID、UnrealStereo4K、Virtual KITTI 2 只有 0.01;FlyingThings3D 是 0.5。这等于把「室内外真实重建」当主粮,把驾驶、合成、动态场景当调味料,防止某一类数据主导梯度。
训练稳定性是这篇论文少见的坦诚之处。作者发现跑到约 150K steps 后梯度范数会爆、loss 开始上升;排查后用了两个补救:跟踪梯度的 EMA,拒绝超过 EMA 3 倍的梯度;加一个轻量的学习率衰减。整个训练一共跳过了 40 步梯度,训练就稳住了(Fig. 8)。这不是一个漂亮的「新损失」,但它是重训大主干时最容易踩的坑,值得记下来。
损失函数沿用 v2 的形式:粗匹配的注意力 NLL、warp 的鲁棒回归、overlap BCE、精度矩阵的 Gaussian NLL。v2 的训练代码没公开,RoMa-Ω 把同一套损失放了出来,这是目前能读到的最接近 v2 的官方实现。核心权重是 attn_nll_weight=1.0、warp_loss_weight=1.0、overlap_loss_weight=0.01、prec_loss_weight=0.001;注意 v2 论文写的 overlap 权重是 ,而 Ω 官方代码这里是 0.01(注释 # like roma),复现时以代码为准。精度损失只在残差小于 8 px 的共视区计算;pow=0.5、eps=1e-3 对应 2.5 节的广义 Charbonnier。官方代码如下。
RoMa-Ω 官方损失:注意力 NLL、Gaussian NLL 与权重(loss.py @ 24c693a)
attn_log_probs_AB = F.log_softmax(attn_logits_AB, dim=-1)
closest_bin_B = (
    (warp_patch[..., None, None, :] - grid_patch_B[:, None, None])
    .reshape(B, H_patch_A, W_patch_A, H_patch_B * W_patch_B, 2)
    .norm(dim=-1)
    .argmin(dim=-1, keepdim=True)
)
within_frame = warp_patch.abs().amax(dim=-1, keepdim=True) < 1.0
covisible = bool_overlap_patch.logical_and(within_frame)
best_match_log_probs = torch.take_along_dim(
    attn_log_probs_AB, closest_bin_B, dim=-1
)
nll_loss = -best_match_log_probs[covisible].sum()
class Loss(nn.Module):
@dataclass(frozen=True)
class Cfg:
pow: float = 0.5
eps: float = 1e-3
attn_nll: bool = True
precision_pred: bool = True
use_prec_loss_threshold: float = 8.0 # in pixels
warp_loss_weight: float = 1.0
attn_nll_weight: float = 1.0
overlap_loss_weight: float = 0.01 # like roma
prec_loss_weight: float = 0.001quad = (
torch.einsum(
"bhwd, bhwdc, bhwc -> bhw", residuals.detach(), P, residuals.detach()
)
/ 2
)
a, b, c = P_params[..., 0], P_params[..., 1], P_params[..., 2]
det = (a * c - b * b).clamp_min(1e-12)
logdet_term = -0.5 * torch.log(det) + math.log(2 * math.pi)
nll = quad + logdet_term4.4 结果:在 v2 输掉的地方赢回来
先看三个困难基准(Table 2)。WxBS 上 RoMa-Ω 72.9,RoMa 72.6,v2 64.8;HardMatch 50.0 / 48.1 / 46.5;RUBIK 88.0 / 75.4 / 85.6。换句话说,它同时拿到了 RoMa 的跨模态鲁棒性和 v2 的几何精度:比 v2 高 8.1 mAA(WxBS)、3.5 mAA(HardMatch)、2.4 AUC@20°(RUBIK),比 RoMa 高 0.3 / 1.9 / 12.6。WxBS 上对 RoMa 的 0.3 基本是噪声,真正的价值是「不再像 v2 那样在跨模态上退步」。
| 方法 | WxBS mAA@10px ↑ | HardMatch mAA@10px ↑ | RUBIK AUC@20° ↑ |
|---|---|---|---|
| VGGT-Ω 原始 | 29.0 | 20.2 | 84.3 |
| RoMa | 72.6 | 48.1 | 75.4 |
| RoMa v2 | 64.8 | 46.5 | 85.6 |
| RoMa-Ω | 72.9 | 50.0 | 88.0 |
读这张表要先看协议。v2 论文里 RoMa/v2 的 WxBS 是 60.8/55.4(640×640),这里同一张表是 72.6/64.8;RoMa-Ω 的官方评测代码默认 precise 设置跑 800×800 粗匹配 / 1280×1280 精化,分辨率更高,绝对分数自然更高。因此 72.9 不能减去 v2 论文的 55.4,只能在这张表内比较:Ω 比 v2 高 8.1,比 RoMa 高 0.3。README 用 8 卡复现的 WxBS 是 71.98、HardMatch 51.10,和论文的 72.9/50.0 也有小出入,说明这类小基准的方差和协议敏感度都不低。
稠密匹配(Table 4,640×640)则是另一种画面:Ω 在 6 个数据集中的 5 个不输 v2——TA-WB EPE 9.24 vs 13.82,MegaDepth 0.97 vs 1.47(PCK@1 81.7 vs 79.6),AerialMegaDepth 2.61 vs 4.12,Map-free 2.02 vs 2.03(基本打平),ScanNet++ 3.85 vs 4.00(PCK@1 45.6 vs 45.5,也基本打平);唯一明显输的是 FlyingThings3D(1.07 vs 0.93,PCK@1 88.5 vs 89.4),动态小物体仍是 v2 的强项。视觉定位(Table 3)上,Map-free VCRE<45 的 AUC 是 81.7,v2 79.4,RoMa 68.5。
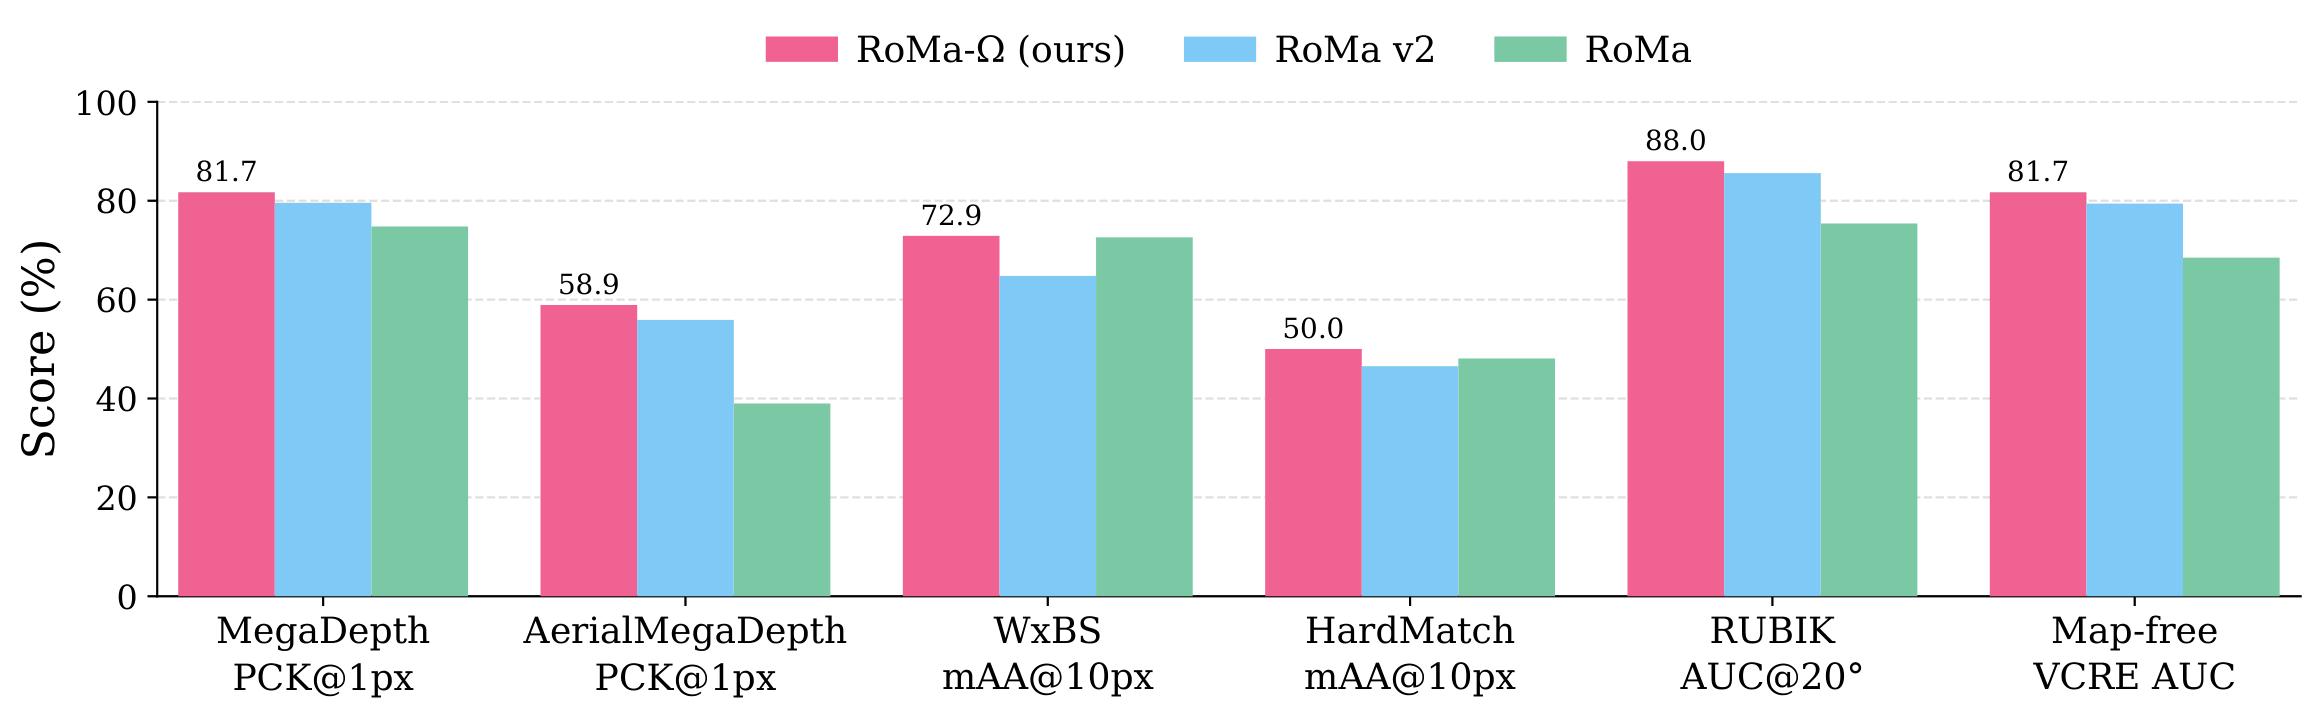
代价在 Table 5:560²、batch 8、A100 上,RoMa-Ω 12.1 对/秒、29.9 GB 显存、1.03B 总参数(其中 125M 可训练);RoMa v2 是 21.6 对/秒、4.0 GB、425M,RoMa 是 12.7 对/秒、3.9 GB、414M。Ω 比 v2 慢约 40%,显存是 v2 的 7.5 倍,吞吐与 RoMa 持平。
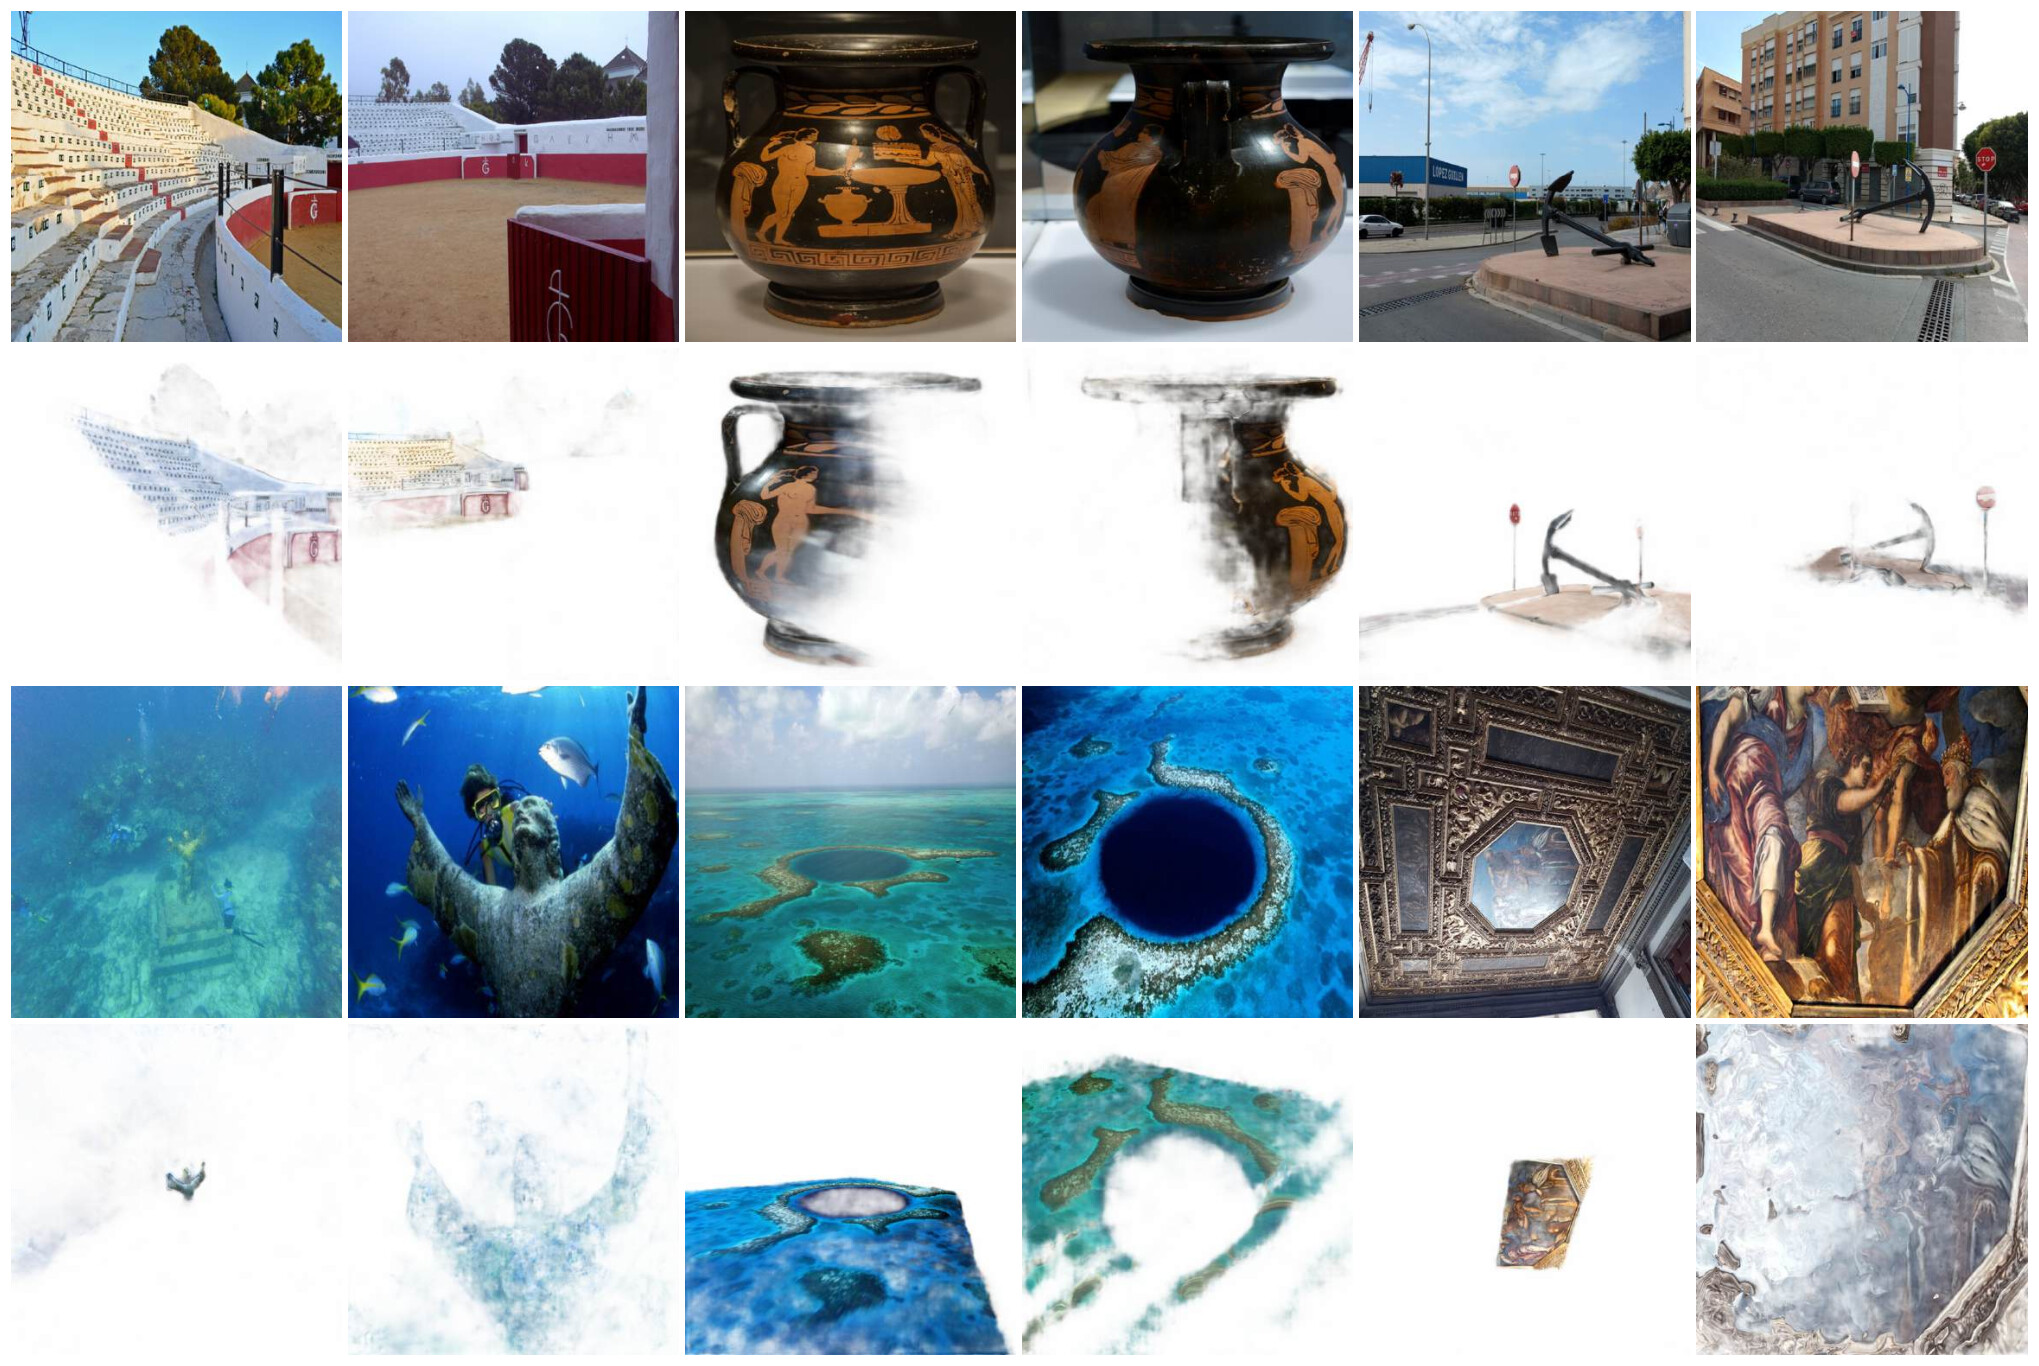
4.5 代价、边界与在 RoMa 脉络里的位置
论文自己承认的局限有三条:只系统验证了 VGGT-Ω,没有覆盖所有前馈 3D 模型;只问了「3D 模型对匹配知道多少」,没问反方向;计算成本限制了实用性。下面几条是我补充的。
- 显存是硬门槛。560²、batch 8 下 29.9 GB,是 v2 的 7.5 倍;1.03B 总参数里只有 125M 可训练。想在 24 GB 卡上跑高分辨率基本不现实,官方 README 也直接称它是 “powerful but slow dense matcher”。
- 许可比代码更严格。RoMa-Ω 仓库是 MIT,但它依赖的 VGGT-Ω 子模块和权重是 FAIR Noncommercial Research License,权重还要在 Hugging Face 上申请。代码能随便读,商用不行——这会让不少工业场景直接出局。
- WxBS 的提升幅度要谨慎解读。对 RoMa 只有 +0.3,而 WxBS 本身只有几十对、标注和 RANSAC 协议都敏感;README 复现的 71.98 和论文 72.9 也差了一点。真正稳的结论是「Ω 把 v2 的跨模态短板补回来了」,而不是「Ω 全面超过 RoMa」。
- HardMatch 的绝对水平仍低。50.0 mAA 是 SOTA,但意味着一半的困难对仍然没匹配好;这个基准来自 LoMa[22],专门收集了 100 类困难场景,本来就是用来暴露问题的。
- 原始 3D 预测的「免费午餐」有边界。ScanNet 上不训练就能打平 v2,但 WxBS/HardMatch 上只有 29.0/20.2;这说明前馈 3D 模型的几何预测在分布内很强,跨域仍要靠匹配数据重训。
- 训练复现成本高。粗匹配 16×A100 两天、精化 8×A100 两天,数据要自己按 DKM/LoMa 的流程准备;论文给了混合配方,但没有给数据打包。
把它放回 RoMa 的脉络里,三篇的主线其实是冻结主干的演化:RoMa 用 DINOv2 的语义特征解决域过拟合,v2 换成更强的 DINOv3 并把工程做扎实,Ω 则证明重建训练的 VGGT-Ω 特征比自监督语义特征更适合当匹配底座。但 Ω 也说明「换主干」不是即插即用:VGGT-Ω 的原始特征零样本很糊(4.1),必须加 12 层跨视图精化器才能用(Table 6 的 II→III 是 4.9→21.5,PCK@1 翻了四倍)。所以更准确的结论是「冻结的 3D 特征 + 可训练的跨视图适配器」,而不是「前馈 3D 模型取代匹配器」。LoMa 是同一作者群的稀疏分支,Ω 的数据配方也参考了它;两者是互补,不是替代。
五、局限性与边界
先看论文自己承认的(v2 为主;Ω 的代价与边界已在 4.5 单独讨论):
- WxBS 的跨模态退化。v2 在 WxBS 上 55.4,低于 RoMa 的 60.8;作者明确说 IR-to-RGB 子集是短板,并把这归因于 DINOv3 与数据混合的 trade-off。
- 天空区域的置信度偏差。Fig 11 显示,模型在天空像素上错误地给出了置信度(图 16);作者怀疑是 AerialMegaDepth 的深度在天空处泄漏进了训练信号。这不是 v2 独有的问题,但它在航拍数据上被放大了。
- SatAst 仍然很难。37.0 AUC@10px 是 SOTA,但绝对水平说明卫星—宇航员匹配还远未解决;基准只有 156 对,方差大。
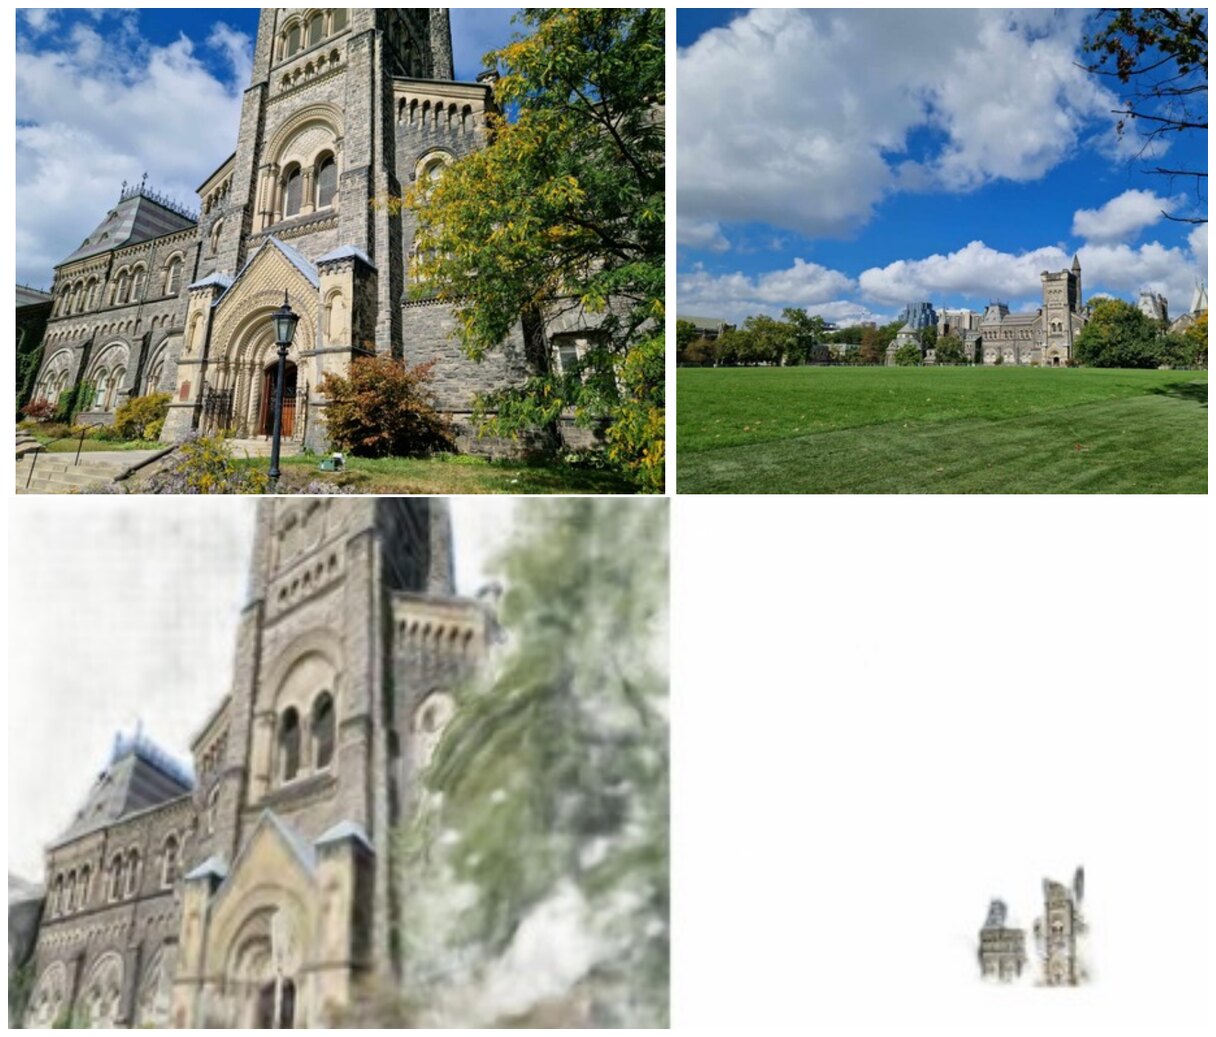
我自己再补几条:
- MegaDepth-1500 上的边际收益很小。62.8/77.0/86.6 vs 62.6/76.7/86.3,提升在 0.3 个点以内;如果只看这个基准,v2 的升级理由不足。v2 的真正价值在 ScanNet、TA-WB、AerialMegaDepth、SatAst 这些更难的分布上。
- 与前馈 3D 模型的边界在模糊。ScanNet 上 MASt3R/VGGT/Reloc3r 与 v2 打平甚至更好;如果下游是位姿估计而不是稠密对应,前馈 3D 模型可能是更简单的选择。匹配器的不可替代性主要在「高分辨率稠密 warp + 不确定性 + 可解释的几何」。RoMa-Ω 把这条边界推得更清楚:冻结的 VGGT-Ω 特征可以当匹配主干并在 ScanNet 上打平 v2(4.1),但它的原始 3D 预测在 WxBS/HardMatch 上只有 29.0/20.2——边界不在「能不能匹配」,而在「能不能跨域」。
- 协方差的校准没有保证。NLL 只在 px 的共视区训练,且残差被 detach;在遮挡、超大残差、分布外场景下,预测的 可能过度自信。论文的 Table 12 是下游收益,不是校准曲线;实际使用前最好在目标域上检查一下残差 vs 预测精度的相关性。
- 训练成本与可复现性。5069 个场景、匹配器与 refiner 各 300k steps,训练量远超 RoMa;论文没有给出 GPU 训练总时长,但这不是普通实验室能轻松复现的。RoMa v2 没有放训练代码,只有推理和评测脚本。RoMa 虽然放了训练代码,但数据准备仍依赖 DKM 的 MegaDepth/ScanNet 流程。
- 速度仍不是实时。30.9 对/秒在 H200 上是好数字,但 640²、batch 8、4.8 GB 显存对边缘设备仍然太重;和稀疏匹配(LightGlue 在毫秒级)相比,稠密匹配的适用场景仍是离线 SfM、建图、定位,而不是实时 SLAM 的前端。
- 分辨率的「鲁棒」是相对的。归一化 RoPE + 多分辨率训练缓解了换分辨率掉点,但 refiner 仍要把位移缩放到 canonical resolution;极端长宽比、超高分辨率(4K 以上)没有系统评估。
- VGG19 细特征偏老。RoMa 系列都依赖 VGG19 做细特征,这在 2026 年显得有些复古;未来用更强的细粒度主干(或 DINOv3 的多层特征)替换,可能还有空间。
- 评估协议的差异。UFM 被缩到 420×560 再上采样,RoMa/RoMa v2 直接 640²;WxBS/SatAst 的标注和 RANSAC 协议也会影响绝对值。跨论文比较时,最好看同一张表里的数字,而不是把不同论文的 SOTA 直接相减。
六、结论与展望
把三篇论文放在一条线上看,RoMa 解决的是「怎么让稠密匹配在分布外仍然可靠」:冻结的基础模型提供语义鲁棒性,专用细特征提供定位精度,回归即分类让粗匹配能表达多峰,鲁棒回归让精化对重尾不敏感。它的核心不是某个模块,而是「粗匹配和精化需要不同的归纳偏置」这一认识——粗匹配要能保留多个假设,精化要能在一个假设内做到亚像素。
RoMa v2 解决的是「怎么把这件事做成一个更好用的系统」:DINOv3 和多视图 Transformer 提升匹配质量,stride-4 粗匹配和两阶段训练把速度与显存打下来,数据混合把航拍/室内/合成/小基线都覆盖,CUDA 核和 2 的幂通道是工程优化,EMA 去偏和预测协方差则让输出更可靠。它的副标题「Harder Better Faster Denser」不是营销:Harder 对应 SatAst/RUBIK,Better 对应稠密 EPE/PCK,Faster 对应 1.7× 吞吐,Denser 对应 stride-4 的稠密 warp 和逐像素协方差。
RoMa-Ω 解决的是「主干还能从哪里来」:它不新造匹配器,而是把 v2 的冻结 DINOv3 换成 VGGT-Ω 的中间层特征,再加 12 层跨视图适配器重训。结果是 WxBS 72.9、HardMatch 50.0、RUBIK 88.0、MegaDepth PCK@1 81.7——第一次把 RoMa 的跨模态鲁棒性和 v2 的几何精度放进同一个模型。它的方法论意义大于数字:匹配器的主干不必来自自监督语义预训练,重建训练的 3D 特征同样可以,甚至更好;但冻结特征零样本不可用,必须配一个可训练的跨视图适配器。代价是 1.03B 参数和 29.9 GB 显存,以及非商用的 VGGT-Ω 权重许可。
给实践者的几条建议:
- 要跨模态鲁棒性(IR-RGB、昼夜、季节):优先 RoMa;如果能接受显存和许可代价,RoMa-Ω 在同一协议下与 RoMa 持平(72.9 vs 72.6)且精度更高。v2 在 WxBS 上反而略退。
- 要稠密、高分辨率、亚像素精度:RoMa v2 是性价比最高的选择,尤其是航拍、室内扫描、动态小物体;640² 的 EPE/PCK 全面领先。
- 能拿到 VGGT-Ω 权重且不计成本:RoMa-Ω 在 WxBS/HardMatch/RUBIK 上最强,但 29.9 GB 显存、1B 参数、非商用许可,适合离线评测和研究,不适合产品部署。
- 要不确定性做加权:v2 的 在 HyperSim 上把 AUC@1 拉高约 20 个点,值得在 RANSAC/位姿精化里用起来;但先在目标域检查校准。
- 资源受限:UFM 吞吐更高但显存 16.2 GB;RoMa v2 在 4.8 GB 下 30.9 对/秒,更适合单卡批量;如果只要稀疏匹配,LightGlue 仍然是毫秒级的选择。
- 做 SfM/定位:匹配器只是管线的一环,HLoc 的检索、几何估计和采样策略会稀释匹配器的增益;先确保采样(balanced sampling、置信度阈值)正确,再换模型。
往前看,几个方向很清楚。第一,匹配器与前馈 3D 模型的融合:VGGT/MASt3R 直接输出点图,RoMa v2 输出稠密 warp + 协方差,两者的输出可以互相监督;ScanNet 上已经打平,RoMa-Ω 更进一步,把冻结的 VGGT-Ω 特征直接当匹配主干。下一步可能是把 1B 主干蒸馏成可部署的小模型,或者用匹配器的亚像素精度反向改进 3D 重建。第二,不确定性驱动的几何估计:v2 只做了残差加权,还没有把协方差真正融进 RANSAC 的采样、Bundle Adjustment 的信息矩阵或位姿图的边。第三,稀疏—稠密统一:FlexGlue 已经把稀疏查询和稠密网格放在一个网络里,RoMa v2 的 stride-4 稠密输出和协方差可以作为它的精化器;未来可能不再区分「稀疏匹配器」和「稠密匹配器」。第四,数据与许可:DINOv3 的权重协议、VGGT-Ω 的非商用许可、合成数据的域偏差、卫星/航拍数据的稀缺,都会决定下一代匹配器能走多远。
七、上手
三个仓库都能直接跑推理。RoMa 和 RoMa-Ω 的训练代码也开源;RoMa v2 目前只放推理与评测,训练细节在论文附录里。
7.1 RoMa
安装(PyPI 包名是 romatch):
安装命令
pip install romatch最小示例(来自 README,device、图片路径和尺寸按你的环境替换):
RoMa 最小匹配示例
from PIL import Image
from romatch import roma_outdoor

device = "cuda"
imA_path, imB_path = "assets/rome1.jpg", "assets/rome2.jpg"
imA, imB = Image.open(imA_path), Image.open(imB_path)

roma_model = roma_outdoor(device=device)
warp, certainty = roma_model.match(imA_path, imB_path, device=device)
matches, certainty = roma_model.sample(warp, certainty)
kptsA, kptsB = roma_model.to_pixel_coordinates(
    matches, imA.height, imA.width, imB.height, imB.width
)几个开关:roma_outdoor() 默认在 560×560 上匹配、再上采样到 864×864 精化;tiny_roma_v1_outdoor() 是给低算力场景的小模型;sample() 里可以调采样数量;to_pixel_coordinates() 把归一化坐标换成像素坐标。权重里 DINOv2 部分受 Apache-2.0 约束,其余代码 MIT。训练代码在 experiments/,示例启动命令:
RoMa 训练命令(多卡)
torchrun --nproc_per_node=4 --nnodes=1 --rdzv_backend=c10d experiments/roma_outdoor.py数据准备沿用 DKM 的 MegaDepth/ScanNet 流程;没有 DKM 的数据脚本,这一步需要自己补。
7.2 RoMa v2
安装(基础版;想要 CUDA 局部相关核就加 fused-local-corr):
安装命令
pip install romav2
# 或者带 CUDA 局部相关核:
pip install "romav2[fused-local-corr]"
最小示例(来自 README):
RoMa v2 最小匹配示例
from romav2 import RoMaV2

model = RoMaV2()
preds = model.match("path/to/A.jpg", "path/to/B.jpg")
matches, overlaps, precision_AB, precision_BA = model.sample(preds, 5000)
sample() 的第二个参数是采样数量;overlaps 是每个匹配的置信度,precision_AB/BA 是两个方向的预测精度(协方差的派生量)。常用设置通过 model.apply_setting(...) 调整:
H_lr、W_lr:低分辨率匹配尺寸;H_hr、W_hr:高分辨率精化尺寸(沿用 RoMa 的两段式)。bidirectional=True:双向匹配,样本更多样,也能估计两个方向的协方差。threshold:overlap 阈值,MegaDepth-1500 这类基准常用 0.05。balanced_sampling=True:像 RoMa 一样做 KDE 重加权,通常能提升 RANSAC 的结果。
评测脚本(README 给的命令):
数据准备与评测
source scripts/eval_prep.sh
uv run tests/test_mega1500.py
uv run tests/test_scannet1500.py
RoMa v2 的代码是 MIT,DINOv3 权重受单独协议约束;仓库没有训练代码,只有推理、评测和模型定义。如果你想复现训练,需要按论文附录的数据混合和两阶段流程自己搭;同源的 LoMa train-dev 分支虽然公开了训练代码,但如 3.8 所述,它是稀疏匹配器且训练复现未经验证,只能作为框架参考。
7.3 RoMa-Ω
RoMa-Ω 的代码是 MIT,但它依赖的 VGGT-Ω 子模块和权重是 FAIR Noncommercial Research License,权重需要在 Hugging Face 上申请后下载。官方只在 Linux + Python 3.12 上测过;安装要带 submodule:
安装与权重
git clone --recurse-submodules https://github.com/davnords/RoMa-Omega
cd RoMa-Omega
# 从 https://huggingface.co/facebook/VGGT-Omega 申请并下载 vggt_omega_1b_512.pt,
# 放到仓库根目录并命名为 vggtomega.pt;或用 --checkpoint 指定路径
uv sync
评测(WxBS / HardMatch 会自动下载;RUBIK 需按仓库说明自己下):
稀疏评测命令(README)
python experiments/eval_sparse.py --name roma_omega --benchmark wxbs      # README: mAA 0.7198
python experiments/eval_sparse.py --name roma_omega --benchmark hardmatch # README: mAA 0.5110
python experiments/eval_sparse.py --name vggt_omega --benchmark wxbs      # VGGT-Ω 原始预测的零样本匹配
稠密 PCK/EPE 评测需要自己下数据(MegaDepth 走 DKM 的流程):
稠密评测
python experiments/eval_dense.py训练分两阶段,README 的脚本按 8 卡写、每阶段约 3 天(论文的粗匹配是 16 卡约 2 天):
训练命令(README)
torchrun --nproc_per_node=8 experiments/train_matcher.py --name my-run
torchrun --nproc_per_node=8 experiments/train_refiners.py --name my-run \
  --matcher-run-path experiments/vggtroma/runs/my-run/<timestamp>
数据集要自己准备,README 只给了「Follow DKM for MegaDepth」;完整的 18 个来源和权重在论文 Table 7。README 复现的 WxBS 是 71.98、HardMatch 51.10,和论文的 72.9/50.0 有零点几到一点多的出入,可能是评测设置或权重版本不同;跑之前先对齐分辨率(默认 precise 是 800 粗 / 1280 精)和采样参数。
参考
- Edstedt, Sun, Bökman, Wadenbäck, Felsberg. RoMa: Robust Dense Feature Matching. CVPR 2024. arXiv · 代码
- Edstedt, Nordström, Zhang, Bökman, et al. RoMa v2: Harder Better Faster Denser Feature Matching. ECCV 2026. arXiv · 代码
- Nordström, Zhang, Loiseau, Lepetit, Kahl. RoMa-Ω: What Feed-Forward 3D Models Know About Image Matching. ECCV 2026 Workshops. arXiv · 代码
- Sarlin, DeTone, Malisiewicz, Rabinovich. SuperGlue: Learning Feature Matching with Graph Neural Networks. CVPR 2020. arXiv · 代码
- Lindenberger, Sarlin, Pollefeys. LightGlue: Local Feature Matching at Light Speed. ICCV 2023. arXiv · 代码
- Sun, Shen, Wang, Bao, Zhou. LoFTR: Detector-Free Local Feature Matching with Transformers. CVPR 2021. arXiv · 代码
- Edstedt, Athanasiadis, Wadenbäck, Felsberg. DKM: Dense Kernelized Feature Matching for Geometry Estimation. CVPR 2023. arXiv · 代码
- Oquab, Darcet, Moutakanni, et al. DINOv2: Learning Robust Visual Features without Supervision. TMLR 2024. arXiv · 代码
- Sarlin, Cadena, Siegwart, Dymczyk. From Coarse to Fine: Robust Hierarchical Localization at Large Scale. CVPR 2019. arXiv · 代码
- Wang, Chen, Karaev, et al. VGGT: Visual Geometry Grounded Transformer. CVPR 2025 (Best Paper). arXiv · 代码
- Zhang, Keetha, Lyu, et al. UFM: A Simple Path towards Unified Dense Correspondence with Flow. NeurIPS 2025. arXiv
- Siméoni, Vo, Seitzer, Baldassarre, Oquab, et al. DINOv3. arXiv 2508.10104, 2025. arXiv · 代码
- Li, Snavely. MegaDepth: Learning Single-View Depth Prediction from Internet Photos. CVPR 2018. arXiv
- Vuong, Ghosh, Ramanan, Narasimhan, Tulsiani. AerialMegaDepth: Learning Aerial-Ground Reconstruction and View Synthesis. CVPR 2025. arXiv
- Yao, Luo, Li, Fang, Quan. BlendedMVS: A Large-scale Dataset for Generalized Multi-view Stereo Networks. CVPR 2020. arXiv · 代码
- Roberts, Paczan, et al. Hypersim: A Photorealistic Synthetic Dataset for Holistic Indoor Scene Understanding. ICCV 2021. arXiv · 代码
- Wang, Zhu, Wang, Hu, et al. TartanAir: A Dataset to Push the Limits of Visual SLAM. IROS 2020. arXiv
- Sarlin, Trulls, Pollefeys, Hosang, Lynen. Map-free Visual Relocalization: Metric Pose Relative to a Single Image. ECCV 2022. arXiv · 代码
- Yeshwanth, Liu, Nießner, Dai. ScanNet++: A High-Fidelity Dataset of 3D Indoor Scenes. ICCV 2023. arXiv · 代码
- Mayer, Ilg, Häusser, et al. A Large Dataset to Train Convolutional Networks for Disparity, Optical Flow, and Scene Flow Estimation. CVPR 2016. arXiv
- Berton, Goletto, Trivigno, Stoken, Caputo, Masone. EarthMatch: Iterative Coregistration for Fine-grained Localization of Astronaut Photography. CVPRW 2024. arXiv
- Nordström, Edstedt, Bökman, Astermark, Heyden, Larsson, Wadenbäck, Felsberg, Kahl. LoMa: Local Feature Matching Revisited. ECCV 2026 (Oral). arXiv · 代码(train-dev)
- Leroy, Cabon, Revaud. Grounding Image Matching in 3D with MASt3R. ECCV 2024. arXiv · 代码
- Dong, Wang, Liu, Cai, Fan, Kannala, Yang. Reloc3r: Large-Scale Training of Relative Camera Pose Regression for Generalizable, Fast, and Accurate Visual Localization. CVPR 2025. arXiv
- Wang, Leroy, Cabon, Chidlovskii, Revaud. DUSt3R: Geometric 3D Vision Made Easy. CVPR 2024. arXiv · 代码
- Wang, Chen, Zhang, Karaev, Schönberger, Labatut, Bojanowski, Novotny, Vedaldi, Rupprecht. VGGT-Ω. CVPR 2026 (Oral). arXiv · 代码