· 85 min read
论文解读:SSIO 与 IMUDINO,自监督惯性感知的两种老师
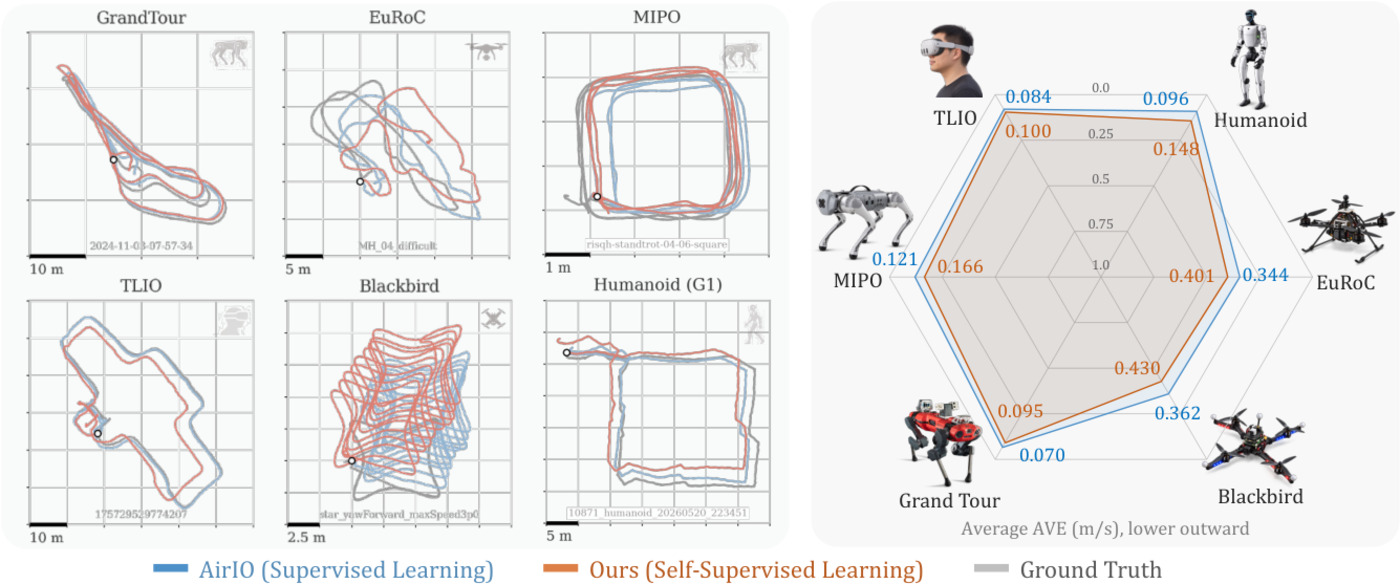
TL;DR 这两篇论文都在回答同一个问题:没有人工标签,IMU 能不能自己教会自己?SSIO[1] 的做法是让 IMU 预积分器当老师:在短窗口内把加速度计和陀螺仪积分成速度变化量,网络只需让两端速度之差等于这个变化量,速度里不可观测的常值偏置在做差时自动消掉;再用静止帧零速正则和一轮位姿图蒸馏把单窗口预测串成轨迹。六个平台(行人、无人机、四足、人形)上,从头自监督训练的 AVE 与同架构监督基线平均只差约 0.06 m/s,学生长时评估还会反超积分老师(20 s 上 0.141 vs 0.885 m/s)。IMUDINO[2] 的做法是让 DINO 自蒸馏当老师:学生看 2 个全局视图 + 6 个局部视图,EMA 老师只看全局视图,用 DINO 的 CLS 对齐、iBOT++ 的 patch 对齐和 KoLeo 正则一起训练;视图变换是裁剪、幅值/时间缩放、SO(3) 旋转、30–200 Hz 重采样和通道掩码,架构只是加了一维 patchify 与频率感知位置编码的标准 ViT。1.16 万小时人体数据预训练后,冻结骨干在 HAR 七个数据集上平均 89.73 mF1(监督 SOTA 86.76),机器人里程计平台无关模型 AVE 0.209 m/s(TartanIMU 平台专家 0.350)。
如果只记一句话:SSIO 用物理约束把标签「算」出来,IMUDINO 用数据增广把标签「造」出来。 前者垂直,盯住一个任务做到逼近监督;后者水平,用一个骨干覆盖四类任务。两篇的代码开放程度也不同:SSIO 有完整训练、评测和六个检查点;IMUDINO 只放推理代码和 85M 权重,训练代码没有开源。
- SSIO:论文,Yuheng Qiu、Yutian Chen、Carlton Cort 等 13 人,Amazon FAR / CMU / UC Berkeley / Stanford / Penn State,arXiv 2026 年 10 月 19 日;代码、权重、项目主页。
- IMUDINO:论文,Zhoutong Ye、Chengwen Zhang、Zixuan Wang、Xufeng Jian 等 12 人,清华大学,arXiv 2026 年 11 月 5 日;代码(GPL-3.0)、权重(
imudino.pt,约 340 MB)。 - 背景:读 SSIO 前最好知道 IMU 预积分、位姿图优化和 AirIO;读 IMUDINO 前最好知道 DINO/iBOT、EMA 教师和 ViT。两篇的共同前作是 RoNIN、TLIO 与 AirIO。
一、为什么把这两篇放在一起
IMU 是机器人、手机、手表、无人机上最便宜、最连续、最不受光照和遮挡影响的状态传感器。它的问题也很固定:噪声和零偏经过两次积分会迅速漂移,所以单靠 IMU 的姿态和位置估计必须频繁借助外部观测。传统做法要么上视觉/LiDAR/GNSS,要么花大价钱采运动捕捉、RTK 或 SLAM 真值来训练学习式模型。前者受环境限制,后者受成本限制——每换一个平台、每换一次挂载,真值就得重来一遍。
SSIO 和 IMUDINO 都把目光放在了同一条出口上:机器人日常运行产生的 IMU 数据本身是无标注、无限量的。但「怎么从无标注 IMU 里造出监督信号」,两篇给出了截然不同的答案。
SSIO 是垂直的:它只做惯性里程计一个任务,但要做到「新平台没有速度/位姿真值也能训练」。它的监督信号来自物理——IMU 预积分器在短窗口内给出的速度变化量。这个信号是「算」出来的,有明确的单位和误差结构(零偏、姿态、窗口长度),所以论文能围绕它做误差分析、压力测试和长时外推。
IMUDINO 是水平的:它不针对任何一个任务,而是想学一个通用惯性表示,让 HAR、健康、动作捕捉、机器人里程计都能用一个冻结骨干。它的监督信号来自数据增广——同一段 IMU 的裁剪、缩放、旋转、重采样、掩码视图应该共享语义。这个信号是「造」出来的,没有物理单位,但胜在覆盖面广,能一次预训练、多处复用。
| 维度 | SSIO | IMUDINO |
|---|---|---|
| 目标 | 单任务:机体系速度 → 轨迹 | 通用表示:四类惯性任务 |
| 监督 | IMU 预积分的速度变化量 + 静止零速 + PGD | DINO/iBOT++ 的视图一致性 + KoLeo |
| 老师 | 冻结的物理积分器 | EMA 学生网络 |
| 网络 | CNN + 双向 GRU + 速度头 | ViT(一维 patchify + 频率感知 PE) |
| 数据 | 六个平台,逐平台训练 | 11.6k h 人体可穿戴,一次预训练 |
| 输出 | 速度 + 协方差 | CLS token + patch tokens |
| 下游 | 积分成轨迹,直接评估 AVE/ATE | 冻结 linear/MLP probe,少数微调 |
| 开源 | 训练 + 评测 + 六个检查点 | 仅推理 + 85M 检查点 |
| 总结 | 物理约束把标签算出来 | 数据增广把标签造出来 |
下面的第二节和第三节分别拆两篇论文,第四节做正面对照,第五节收结论,第六节是两套上手命令。
二、SSIO:让积分器当老师
2.1 问题:换一个平台,就要重采一遍真值
惯性里程计是机器人状态估计里最「自给自足」的一路:只靠 IMU,不依赖相机、LiDAR 或 GNSS,在视觉失效、光照恶劣、室内外切换时仍然能工作。它的代价是漂移——加速度计和陀螺仪的噪声、零偏经过两次积分会迅速放大成位置误差。
传统做法分两条路。模型式方法从平台的运动学或动力学出发,用腿式机构的接触约束、飞行器的推力模型、或者多 IMU 的刚体运动学来构造观测;学习式方法则从数据里学一个从 IMU 序列到速度或位姿的映射[3, 4, 5]。两条路都有同一个盲区:平台绑定。传感器安装位置、机身质量分布、控制策略、步态或飞行模式,都会被隐式或显式地写进模型。换一个机器人,原来的模型就未必成立,于是工程上最常见的做法是——重新采数据、重新标真值。
这就把问题变成了成本问题。运动捕捉、RTK、SLAM 都能给真值,但它们要么只能在特定场地用,要么在复杂环境里自己也会退化;更麻烦的是,每换一次挂载、载荷或控制策略,真值就得重来一遍。SSIO 的核心问题因此可以一句话概括:
机器人能不能只用自己的 IMU 数据,学会自己的运动模型?
论文的贡献有三点:提出一套只依赖无标注 IMU 的两阶段自监督框架;据作者所知,第一次证明从零开始在无标注 IMU 上训练的学习式 IO 能接近监督学习的性能;并展示学生模型在长时评估中反超它的积分老师,同时能利用更多无标注数据继续提升。
2.2 积分自监督:只监督「速度的变化量」
SSIO 的网络沿用 AirIO 的 CNN + 双向 GRU + 速度解码器,但去掉了 AirIO 的姿态编码器,记作 AirIO†。输入是机体坐标系下的原始加速度计和陀螺仪读数(重力没有被去掉),输出是每个锚点上的机体系速度 和对应的 速度协方差。
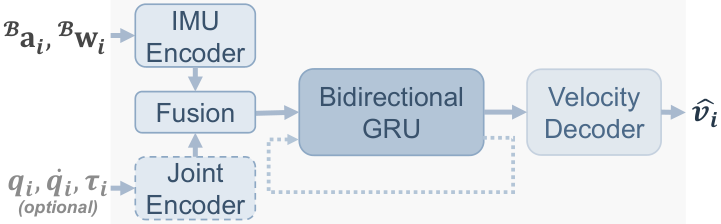
保留机体系是有意为之。AirIO 的观察是:把 IMU 转到全局系、再减掉重力,会损失与平台运动相关的可观测性;保留机体系、保留重力方向,网络反而能从 IMU 历史里自己推断倾角。对自监督来说还有第二个好处:老师在窗口起点机体系里给出的速度变化量,只需要一个相对旋转就能和学生预测比较,不需要任何全局航向。
这是整篇论文的核心。对每个长度为 的短窗口,把窗口内的 IMU 预积分,得到两端之间的相对旋转 和重力补偿后的速度变化量 (都表达在窗口起点 的机体系)。网络在窗口两端各输出一个速度 、,于是它预测的速度变化量是
监督信号就是让这个预测等于积分器给出的 :
为什么监督「变化量」而不是直接监督速度?因为单靠 IMU,速度的常值偏置是不可观测的:积分器只能确定速度差,确定不了绝对的起点速度。做差恰好把这个偏置消掉,于是标签不需要任何外部真值。论文在附录和代码里把这个思想写成了两种实现:固定间隔的 损失,以及它在锚点维上的稠密极限——方差损失。后者是 TLIO 那组配置的默认损失,直接对残差在窗口内取方差:
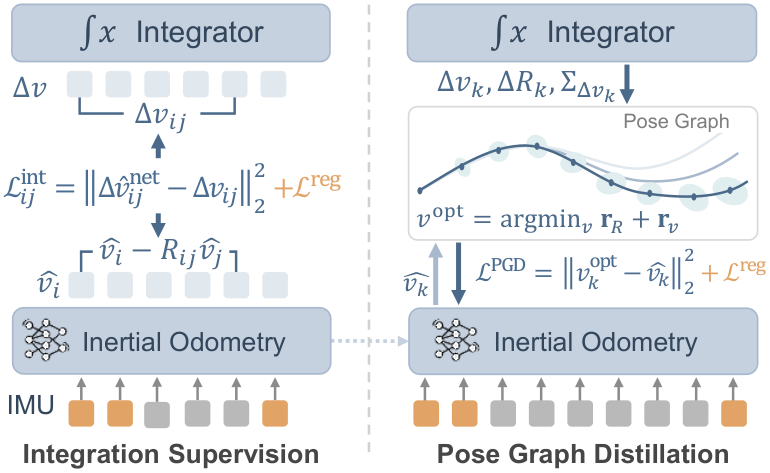
监督窗口不是单一尺度,而是一组几何间隔:从单个网络步长(9 个 IMU 采样)一直到几秒。短间隔让老师的积分误差几乎可以忽略,长间隔则让目标真正包含运动信息而不是噪声。最长的间隔按数据集单独选,原则是「老师在这个间隔上的积分误差要低于目标速度误差」——TLIO 用 5.12 s,MIPO 这种高动态四足只用 0.41 s。
老师的 IMU 流和学生的输入流是分开配置的:默认情况下老师积分的是经过零偏校正的 corrected 流,学生读原始 raw 流。零偏只影响训练目标,不影响部署时的输入;零偏由每个序列的静止帧估计,论文假设零偏是常数。
代码:积分老师的 Δv 与锚点系对齐(官方 train_ssio.py,原文节选)
    if imu_input == "corrected":
        acc = tp.cast(torch.Tensor, data.corrected_acc)[:, :, 0]
        gyro = tp.cast(torch.Tensor, data.corrected_gyro)[:, :, 0]
    else:
        assert imu_input == "raw"
        acc, gyro = data.acc[:, :, 0], data.gyro[:, :, 0]                             # (B, N, 3)

    time_ns = data.time_ns       [:, :, 0]                                            # (B, N, 1) int64
    acc_cov = data.acc_cov       [:, :, 0]                                            # (B, N, 3, 3)
    rot_wb  = data.gt_poses.rotation()                                                # SO3 [B, N], body-level (no K)

    dt     = (time_ns[:, 1:] - time_ns[:, :-1]).to(acc.dtype) * 1e-9
    preint = model.integrate(
        dt   = dt,
        gyro = gyro  [:, :-1],
        acc  = acc   [:, :-1],
        rot  = rot_wb[:, :-1],
    )
    Dv = torch.cat([torch.zeros_like(preint["Dv"][:, :1]), preint["Dv"]], dim=1)

    # Per-step Δv-cov in body_i frame, then cumulative sum (index 0 zero-padded).
    R_ij     = (rot_wb[:, :1].Inv() @ rot_wb[:, :-1]).matrix()
    step_cov = R_ij @ acc_cov[:, :-1] @ R_ij.transpose(-1, -2) * dt.pow(2).unsqueeze(-1)
    cum_cov  = torch.cumsum(step_cov, dim=1)
    Dv_cov   = torch.cat([torch.zeros_like(cum_cov[:, :1]), cum_cov], dim=1)

    # Re-express from the frame-0 body frame into the anchor-0 body frame, so
    # ``R[:, 0:1] @ ref_delta_v`` in the losses is exact rather than a proxy.
    R_align = rot_wb[:, start_index:start_index + 1].Inv() @ rot_wb[:, 0:1]            # SO3 [B, 1]
    A       = R_align.matrix()
    Dv      = R_align @ Dv
    Dv_cov  = A @ Dv_cov @ A.transpose(-1, -2)


    return Dv, Dv_cov
这里有一个容易被忽略的实现细节:预积分从输入的第 0 帧开始,但损失里用来转世界的旋转是输出锚点 0 的旋转,二者之间差一个 。所以代码最后把 从第 0 帧机体系重新表达进锚点 0 机体系;不补这一步,会留下一个任何网络输出都拟合不了的残差项,而且做差也不会消掉(官方代码注释说在 EuRoC 上实测占 的 0.9% 到 3.4%)。
代码:方差形式的积分损失(官方 Loss/ssio.py,原文节选)
        R          = ref_rot_Twb.Exp()                  # so(3) → SO3
        pred_world = R @ pred_v                         # body→world
        ref_world  = R[:, 0:1] @ ref_delta_v            # R[anchor 0] as R_0 proxy

        e    = pred_world - ref_world

        match self.weight:
            case "identity":
                loss = e.var(dim=1, unbiased=False).mean()

            case "preint":
                # Inverse-trace(Σ_preint) precision weights (trace is rotation-invariant);
                # 1e-6 floor handles Σ=0 at anchor 0. Weighted mean keeps offset-invariance.
                precision = 1.0 / (torch.diagonal(ref_delta_v_cov, dim1=-2, dim2=-1).sum(-1) + 1e-6)  # (B, M)
                w         = precision.unsqueeze(-1)                                                    # (B, M, 1)
                w_sum     = w.sum(dim=1, keepdim=True)                                                 # (B, 1, 1)
                mu_w      = (w * e).sum(dim=1, keepdim=True) / w_sum                                   # (B, 1, 3)
                loss      = ((w * (e - mu_w).pow(2)).sum(dim=1) / w_sum.squeeze(1)).mean()
2.3 静止正则与位姿图蒸馏:补上绝对信息和轨迹一致性
自监督只约束速度变化,对绝对速度的常值偏移没有约束。静止帧是唯一能白送绝对信息的地方:人站着、狗趴着、无人机悬停时,速度必须为零。SSIO 从原始 IMU 统计量里检测静止窗口——滚动 1 s 内加速度模长的标准差小于 0.20 m/s²、角速度模长的均值小于 0.10 rad/s、角速度模长的标准差小于 0.05 rad/s、加速度模长均值偏离重力小于 0.40 m/s²。检测到的帧上加一项
其中 是静止帧集合。阈值在所有数据集上共用,只有正则权重 按平台调整。
代码:静止检测阈值与静止速度惩罚(官方 Interface/stationary.py、Loss/regularization.py,原文节选)
def detect_stationary(
    acc          : torch.Tensor,   # (B, N, 3) RAW specific force (retains gravity)
    gyro         : torch.Tensor,   # (B, N, 3) RAW angular rate
    dt           : float,          # seconds between consecutive samples
    *,
    a_std_max    : float = 0.20,   # rolling std of ||acc|| (m/s^2)
    gyro_mean_max: float = 0.10,   # rolling mean of ||gyro|| (rad/s)
    gyro_std_max : float = 0.05,   # rolling std  of ||gyro|| (rad/s)
    grav_dev_max : float = 0.40,   # |rolling mean ||acc|| - g| (m/s^2)
    gravity      : float = 9.81007,
    win_s        : float = 1.0,
) -> torch.Tensor:
    """Detect stationary frames from raw main-body IMU statistics."""
    win = round(win_s / dt)
    assert win >= 4

    a_norm   = acc.norm(dim=-1)                            # (B, N)
    w_norm   = gyro.norm(dim=-1)
    a_mean   = _rolling_mean(a_norm, win)
    a_std    = (_rolling_mean(a_norm.pow(2), win) - a_mean.pow(2)).clamp(min=0).sqrt()
    w_mean   = _rolling_mean(w_norm, win)
    # Mean rejects steady rotation; standard deviation rejects zero-mean oscillation.
    w_std    = (_rolling_mean(w_norm.pow(2), win) - w_mean.pow(2)).clamp(min=0).sqrt()
    grav_dev = (a_mean - gravity).abs()
    return ((a_std  < a_std_max)     & (w_mean   < gyro_mean_max) &
            (w_std  < gyro_std_max)  & (grav_dev < grav_dev_max))
mean_sq_speed = (
(pred_v.pow(2).sum(dim=-1) * static).sum()
/ static.sum().clamp(min=1)
)
loss = weight * mean_sq_speed
return loss, {
"train/regularization_loss": loss.detach().item(),
"train/regularization_frac": float(static.to(pred_v.dtype).mean().item()),
}单窗口监督还有两个天生的弱点:老师在一个窗口内的噪声没有被平均掉;不同窗口之间的预测彼此独立,拼成轨迹时可能不一致。PGD(pose graph distillation)用一整条训练轨迹来解决这件事。它把轨迹上的锚点当节点,构造一个位姿图:
- IMU 因子:相邻锚点之间的预积分 、,用附录 A 传播的协方差做加权,让积分可信的地方权重高;
- 网络因子:每个锚点上学生预测的速度,用一个固定的各向同性标准差 加权——注意速度协方差头在自监督里没有训练,不能拿它当权重;
- 锚点先验:整条图的第一个关键帧固定到参考轨迹的旋转和速度上。
图优化解出后验速度 ,它就是蒸馏目标:
PGD 有一个反直觉的设计选择:只做一轮。原因在论文里写得很清楚——图里没有独立的测量,重复用当前网络的预测去重新解图,等于把学生自己的漂移一遍遍抄进标签。表 V 在 GrandTour 上验证了这一点:从自监督网络出发,1 轮迭代的 AVE 是 0.095 m/s,10 轮涨到 0.149,80 轮涨到 0.202;从零开始则需要 150 轮才到 0.216,IMU-only 的版本在约 300 轮后直接发散。所以 PGD 是「一次性的、从好初始化出发」的细化,不是 EM 式的反复自训练。
图优化本身有一个工程细节:Hessian 是块三对角的,因为 IMU 因子只耦合相邻关键帧。SSIO 提供两个后端:稠密 Cholesky(CPU/GPU 都能跑,但 )和块三对角稀疏求解(Linux + CUDA,cuDSS,)。在 RTX 5090、batch 128 的设置下,128 个关键帧时稠密后端 63.4 ms、稀疏后端 35.3 ms(1.8 倍);512 个关键帧时稠密后端的内存就超过了 32 GB,直接 OOM,稀疏后端 167.9 ms;1024 个关键帧稀疏后端也只要 438.7 ms。
代码:单条轨迹的位姿图构造与求解(官方 train_pgd.py,原文节选)
    obs_cov = (obs_sigma ** 2) * torch.eye(3, dtype=net_cov.dtype, device=net_cov.device).expand_as(net_cov)
    graph = instantiate(
        I_IMUFactorGraph, graph_cfg,
        net_vel_b     = net_vel[None],
        net_vel_cov_b = obs_cov[None],
        imu_dv_b      = preint.dv,
        imu_dr_b      = preint.dr,
        imu_dt_ms     = preint.dt,
        imu_dvr_cov   = preint.dvr_cov,
        rot_wb        = pp.so3(rot_so3[None, 0:1]),
        vel_prior     = gt_vel_b[None, 0:1],
    )
    info = graph.solve()
    vel  = graph.get_state[0]

    # A failed or non-finite solve falls back to the teacher for the whole
    # trajectory, so it reads as zero residual rather than reaching the optimizer
    # as NaN. An unconverged but finite solve is kept and reported.
    bad = (not bool(torch.isfinite(vel).all())) or bool(info["failed"].any())
    if info.get("rejected"):
        print(f"[PGO:{raw_seq.seq_name}] chi2 gate rejected {info['rejected']}/{M} velocity observations", flush=True)
    if bad:
        print(f"[PGO:{raw_seq.seq_name}] solve non-finite/failed — falling back to the teacher prediction", flush=True)
        vel = net_vel.clone()
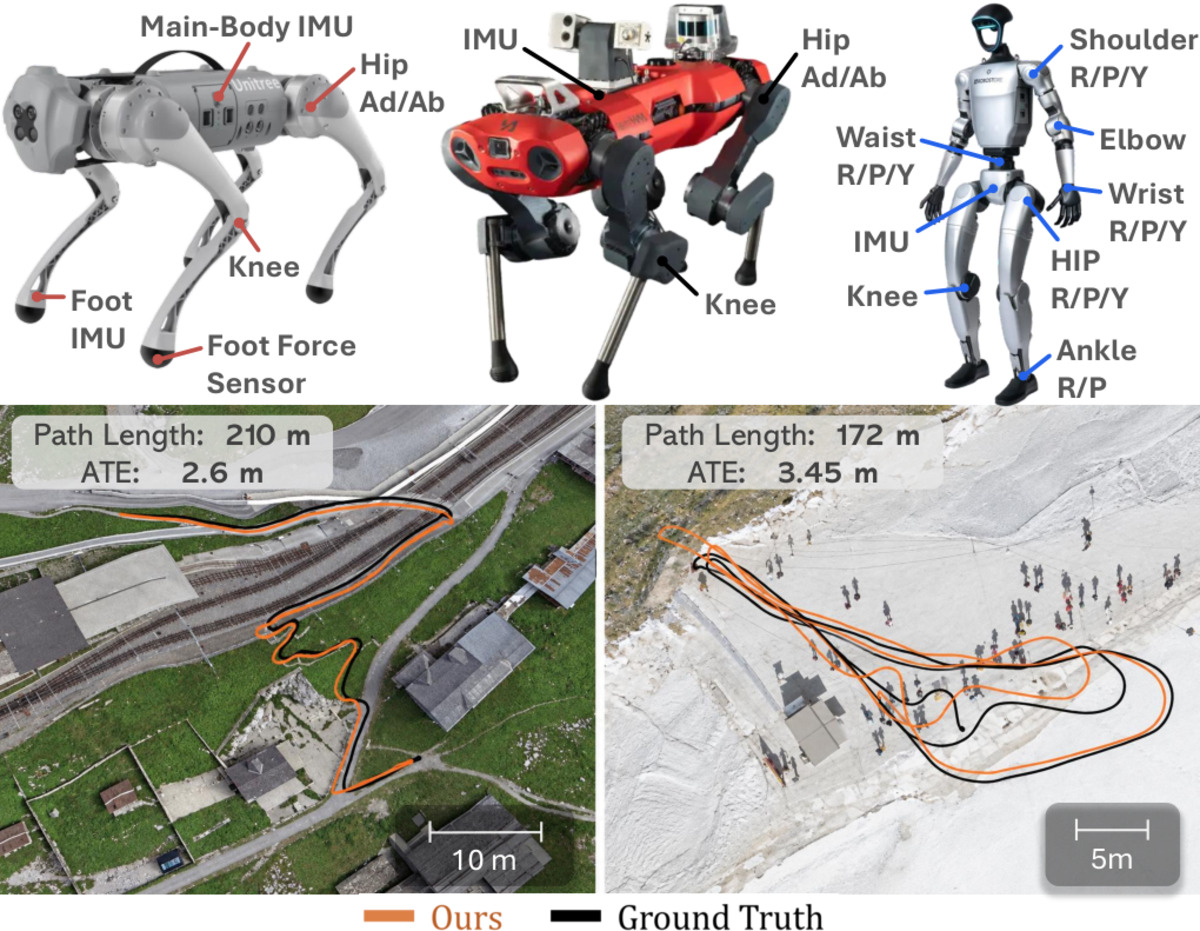
腿式机器人额外有腿部 IMU、关节编码器、足端力传感器。SSIO 不改变损失,只让学生多读这些流:主 IMU 和辅助 IMU 在卷积通道维拼接,关节的位置、速度、力矩经过一个关节编码器,再和 IMU 特征做三层 MLP 融合。老师仍然是主 IMU 的积分器,所以自监督的目标没有被改变,增加的信息只作用于学生。
2.4 实验:六个平台,学生反超老师
论文在六个公开或自采数据集上训练和测试,覆盖行人、无人机、四足和人形:
| 数据集 | 平台 | 时长 | 轨迹长度 | 最大速度 |
|---|---|---|---|---|
| TLIO | 头戴式行人 | 31.6 h | 42.3 km | 6.0 m/s |
| EuRoC | 微型无人机 | 22.5 min | 892 m | 2.9 m/s |
| Blackbird | 竞速无人机 | 5.0 h | 28.4 km | 8.7 m/s |
| MIPO | Unitree Go1 四足,5 IMU | 58.6 min | 1.4 km | 6.6 m/s |
| GrandTour | ANYmal 四足,室外 | 5.65 h | 10.3 km | 1.5 m/s |
| Humanoid | Unitree G1 人形 | 1.31 h | 1.9 km | 3.9 m/s |
训练配置按数据集单独设置:batch 从 64 到 512,监督窗口从 0.41 s 到 5.12 s,学习率 到 ,训练 40 到 240 个 epoch。所有模型都从随机初始化开始,不使用任何预训练权重。
主结果在表 II。这里只摘出同架构的 AirIO† 监督基线、SSIO 和 SSIO + PGD 三行,数字是 AVE(m/s)/ ATE(m):
| 方法 | TLIO | EuRoC | Blackbird | MIPO | GrandTour | Humanoid |
|---|---|---|---|---|---|---|
| AirIO†(监督) | 0.084 / 2.08 | 0.344 / 3.72 | 0.362 / 6.39 | 0.121 / 0.31 | 0.070 / 3.38 | 0.096 / 1.40 |
| SSIO | 0.104 / 3.04 | 0.423 / 9.03 | 0.475 / 18.39 | 0.182 / 1.63 | 0.096 / 4.37 | 0.167 / 4.36 |
| SSIO + PGD | 0.100 / 3.01 | 0.401 / 10.23 | 0.430 / 17.93 | 0.166 / 1.64 | 0.095 / 4.34 | 0.148 / 4.27 |
六个数据集上,未加 PGD 的 SSIO 与监督基线的 AVE 差距平均约 0.06 m/s;加上 PGD 后,每个数据集的 AVE 差距都在 0.07 m/s 以内,这就是摘要里「within 0.07 m/s」的来源。差距并不均匀:TLIO 只差 0.016,GrandTour 差 0.025;EuRoC 差 0.057,Blackbird 差 0.068。Blackbird 这种 8.7 m/s 的竞速飞行是自监督最吃力的一档,ATE 从 6.39 涨到 17.93 m。PGD 的收益也因平台而异:TLIO 只降 0.004,Blackbird 降 0.045,Humanoid 降 0.019。它更像是在「单窗口预测已经不错、但轨迹一致性差」的平台上有用;如果老师本身在长窗口上就不准,PGD 也救不回来。
更有意思的是「学生什么时候超过老师」。训练目标只要求学生在窗口内匹配老师,但评估时学生要预测任意长时段的误差。图 5 的横轴是评估窗口,纵轴是速度变化误差,每一行是一个监督窗口长度,最上面一行是纯积分老师。
图 5 的数据重画:每个按钮对应一个监督窗口长度,虚线是积分老师,实线是学生。默认 3.65 s 是这个消融里最长的监督窗口;表 VI 中 TLIO 的正式配置是 5.12 s。
读法很直接:在比监督窗口更短的评估区间上,学生的误差比老师大——它毕竟只被要求匹配窗口内的变化量;但老师的误差随积分时间近似线性增长,学生的增长却慢得多。到 20 s,老师是 0.885 m/s,学生是 0.141 m/s,差了六倍多。论文的解释是:学生看到的是比最短积分间隔长得多的输入窗口,并在成千上万个窗口上训练,因此能在多个窗口上平均掉老师的噪声,并学到平台特有的重复运动模式(步态周期、旋翼的推力周期);老师则是「短视」的,每个窗口独立积分,误差只会累积。
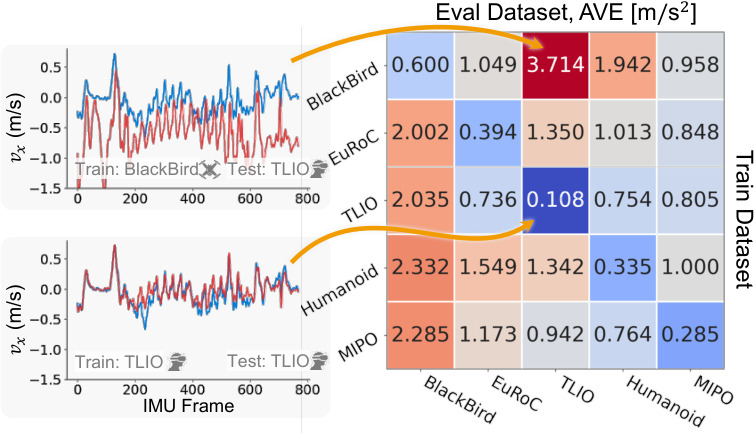
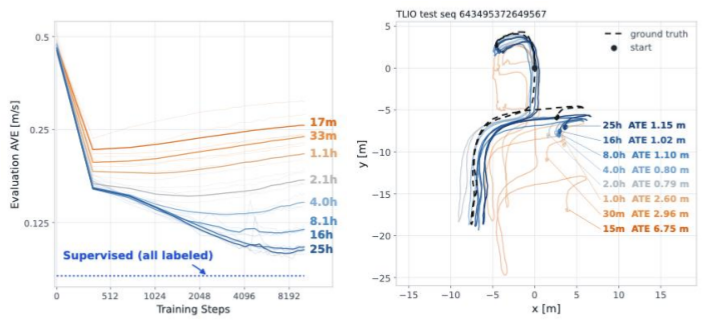
这个解释也得到另外两个实验的支持。第一,跨数据集迁移(图 6)全是负收益:每个模型都在自己的训练集上最好,换到别的平台后误差至少是目标域训练模型的 1.9 倍,最多 34 倍。如果学生学到的是通用的积分修正,迁移应该更容易;但事实是它学的是平台相关的运动模型。第二,数据规模实验(图 7)里,留出集 AVE 随无标注数据量单调下降,从 15 min 到 25 h 一路逼近监督基线,说明学生确实在利用更多数据学习运动模式,而不是在拟合噪声。
论文还做了三组压力测试,结论对部署很有参考价值。噪声不是主要矛盾:给训练用的 IMU 注入零均值高斯噪声,标准差加到 0.5 m/s²(远超真实传感器噪声)时,AVE 只涨了最多 9%;零均值噪声在窗口内和跨窗口都会相互抵消。零偏才是:注入一个常值零偏,0.1 m/s² 就让 AVE 涨 39%,0.5 m/s² 时误差涨到四倍以上;零偏是系统性误差,在每个窗口内都同号累积,不会平均掉。姿态误差会漏进每一个目标:老师用窗口起点的姿态把重力减掉,如果姿态有倾角误差,重力就会漏进速度变化量;把老师的参考姿态换成纯 IMU 估计后,TLIO 上 AVE 从 0.109 涨到 0.133(+22%),MIPO 上用机载 AHRS(平均倾角误差 0.9°)让 AVE 从 0.182 涨到 0.235(+29%)。
2.5 SSIO 的局限
论文自己承认两条:训练数据里必须包含多样的运动,否则自监督信号会退化成零;零偏必须被校正,0.1 m/s² 的常值零偏就足以让 AVE 涨 39%。作者还把姿态误差的影响列为未来工作,建议更好的陀螺仪零偏标定或重力辅助姿态滤波。
我自己再补几条:
- 「无标签」指的是训练目标,不是整条流水线。老师的重力补偿用参考姿态,PGD 的第一个关键帧用参考旋转和速度,验证集上的模型选择用参考速度。官方文档
Doc/training.md把这些「Use of Reference Data」列得很清楚。部署时确实只需要 IMU,但训练时仍然要有某种参考轨迹来提供姿态和初始速度。 - 每个平台单独训练。跨数据集迁移实验是全面负收益,SSIO 没有训练一个跨形态的统一模型;「新平台只需要采 IMU」成立,但每个新平台仍要单独训练一份权重。
- 监督差距不均匀。Blackbird 上 AVE 差 0.113 m/s、ATE 从 6.39 涨到 18.39 m,说明在高动态竞速飞行上,短窗口积分老师的噪声仍然太大,论文没有给出这个平台的失败模式分析。
- PGD 的稀疏后端有平台限制。
graph=sparse_imupgo依赖 cuDSS,只在 Linux + CUDA 上可用;CPU 或 macOS 只能用稠密后端,而稠密后端在 512 个关键帧就 OOM,长轨迹跑不动。 - 发布的 PGD 检查点与论文表格有细微出入。README 明确说明 released “Ours (w/ PGD)” checkpoints 不完全等于论文的 PGD 行;例如 Humanoid 论文是 0.148/4.27,发布检查点是 0.1549/4.38。
三、IMUDINO:让自蒸馏当老师
3.1 问题:惯性感知缺一个「通用骨干」
惯性传感的任务谱系很宽。同一个三轴加速度计加三轴陀螺仪,可以判断人在走路还是跑步,可以估计步态与跌倒风险,可以驱动 16 个关节的人体姿态,也可以让机器人、无人机、汽车估计自己的速度。但过去的工作大多各做各的:HAR 模型只关心离散动作分类,动作捕捉模型内嵌人体骨骼和物理先验,机器人里程计模型绑定平台动力学。一个模型换到另一个任务上,往往要从头再来。
基础模型的意义就在于打破这种绑定。惯性感知也具备视觉和语言那样的条件——IMU 数据便宜、连续、无时无刻不在产生,且不需要人工标注。但论文指出,现有的惯性基础模型还差两口气:一是任务覆盖面窄,多数工作只针对 HAR 一个子领域,有些甚至在 HAR 上还不如任务特定的监督模型;二是输入假设太硬,真实场景的采样率从 25 Hz 到 200 Hz 不等,窗口长度从一秒到十几秒,传感器可能戴在手腕、腰、大腿、脚踝或手机上,要求固定长度、固定采样率的模型,部署时就要为每个场景重采样、切窗、重训。
IMUDINO 的出发点就是这两条:用一个自监督目标学出既通用又可迁移的全局特征和稠密特征,并且让架构原生支持变长输入和变采样率。论文的三个贡献也对应这三件事:把 DINO 自蒸馏适配到惯性数据;提出一套语义保持的运动变换;用一个极简的 IMUFormer 证明「效果来自训练目标,而不是复杂架构」。
3.2 三个损失:全局、局部、分布
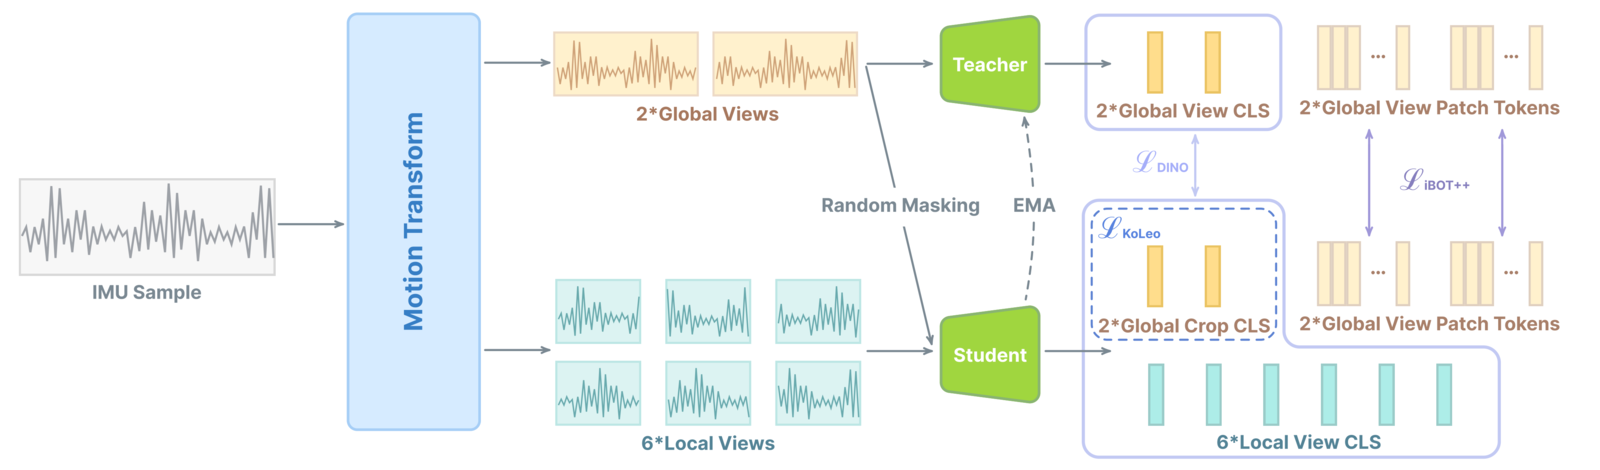
IMUDINO 直接沿用 DINOv2 的自蒸馏结构[6, 7, 8]:学生网络和 EMA 教师网络结构相同,教师不接收梯度,参数由学生的指数滑动平均更新。每个样本生成 8 个视图,教师只看其中 2 个全局视图,学生看全部 8 个。三个损失各管一件事。
全局目标(DINO)。学生和教师的 CLS token 分别经过一个 DINO head(MLP),输出原型分数。学生分数做 softmax 得到 ;教师分数先做锐化(sharpening),再做 Sinkhorn-Knopp 居中,得到 。损失是交叉熵:
教师端的居中和锐化是防坍缩的关键:如果所有样本都映射到同一个原型,居中会把这一维压下去,锐化则让少数原型变得更尖。两者配合 EMA,让学生追一个不断移动、但不会塌缩的目标。
局部目标(iBOT++)。只对齐 CLS 不够,动作捕捉和里程计需要每个时间片的稠密特征。iBOT 的做法是:把学生输入的一部分 patch 遮住,教师看完整输入;学生用 iBOT head 预测被遮住位置的原型分布,教师给出对应位置的目标:
其中 是被遮住的 patch 索引。iBOT++ 把这个求和扩展到所有 token,不只被遮住的位置;可见 token 也要和教师对齐,相当于给学生一个更密的锚。论文的实现里,每个 batch 随机选 50% 的全局视图,把其中 10% 到 50% 的 patch 替换成可学习的 mask token。
KoLeo 正则。它不涉及教师,只作用在学生 batch 内的全局特征上,让特征在空间里铺得更均匀:
其中 是 归一化后的 CLS 特征。直观上,它防的是「所有样本挤在一团」的坍缩,同时让特征空间保留更多可用于最近邻检索和聚类的结构。
总损失是三项加权和:
论文取 、。这里没有训练代码可以对照——官方仓库只放了推理。上面的公式和超参来自论文第 3.1 节与附录 A.1。
3.3 语义保持的运动变换与 IMUFormer
DINO 的核心假设是:同一个样本的不同视图应该共享全局语义。所以视图变换必须改变外观、保留语义。视觉里这是裁剪、颜色抖动、翻转;惯性数据里,论文选了五种:
- 裁剪:全局视图覆盖原样本长度的 0.5 到 0.8,局部视图覆盖 0.05 到 0.4。依据是人体运动的时间连续性——相邻时间段的动作通常相关,应该共享特征。局部视图还逼着模型建立「局部片段 ↔ 全局动作」的对应。
- 缩放:沿两个轴随机缩放,幅值轴控制动作强度,时间轴控制动作快慢,倍率都从 采样,以 0.5 的概率施加。同一个人快走和慢走、轻拿和重放,语义是同一类动作;模型不该因为强度或节奏变了就换一个表示。
- 旋转:以 0.5 的概率施加一个随机 SO(3) 旋转,覆盖三个轴上的 到 。传感器戴在左手还是右手、朝前还是朝后,不该改变「人在走路」这个语义。
- 重采样:以 0.5 的概率把序列重采样到 Hz。50 Hz 和 200 Hz 记录的是同一个动作,只是采样密度不同。
- 通道掩码:每个通道独立地以 0.2 的概率置零。这样模型不会过度依赖某一个轴,也能适应只有三轴加速度、没有陀螺仪的下游数据。
这组变换里,旋转和重采样是最「惯性特有」的两个:它们直接对应部署时最常见的两个分布偏移——传感器朝向变了、采样率变了。论文第 3.5 节的实验也证明,去掉旋转后 HAR 平均掉 1.07 个点,是五个变换里影响最大的;去掉重采样则主要影响变采样率场景。
变换只作用在视图上,但两个损失的「分工」决定了全局和稠密特征会走向不同的不变性:DINO 损失要求不同视图的 CLS 尽量一致,于是 CLS 学会忽略旋转和采样率;iBOT++ 损失要求每个位置的 patch token 对齐教师对应位置的内容,旋转后的 patch 内容确实变了,所以稠密特征仍然保留朝向和局部细节。第 3.5 节会用余弦相似度曲线把这个分工画出来。
架构上,论文刻意不堆料。IMUFormer 从标准 ViT 出发,只做两个改动。第一,一维 patchify:把 2D 图像的卷积 patch 层换成一维、不重叠的 Conv1d,kernel 和 stride 都是 16,把 6 通道 IMU 序列切成 patch token。第二,频率感知的正弦位置编码:不用可学习的绝对位置编码,而是把位置 按采样率 缩放成「物理时间」:
其中 、 Hz。这样一来,50 Hz 序列里的第 100 个 token 和 200 Hz 序列里的第 200 个 token 表示的是同一段物理时间,位置编码相同。位置编码因此变成参数无关的,模型学到的是「经过了多少秒」,而不是「第几个 token」。再配合训练时的重采样增强,同一个模型可以吃任意合理采样率的输入。
除此之外,IMUFormer 就是标准 ViT:CLS token + 4 个 register token + patch token,12 层、768 维、24 个注意力头(85M 版本,约等于把 ViT-B 的头数从 12 提到 24)。6M 版本则是 8 层、256 维、8 个头。register token 的作用是给模型一些「不参与下游任务」的额外槽位,吸收全局信息,避免 CLS 被迫承载所有细节。
代码:频率感知位置编码与 IMUFormer 前向(官方 imudino.py,原文节选)
        positions = torch.arange(
            L,
            device=x.device,
            dtype=x.dtype,
        )

        div_term = self.div_term.to(
            device=x.device,
            dtype=x.dtype,
        )

        # [B, L, ceil(D / 2)]
        angles = (
            positions[None, :, None]
            * (100.0 / freqs[:, None, None])
            * div_term[None, None, :]
        )

        # Interleave sin and cos without in-place slice assignments:
        # [sin(a0), cos(a0), sin(a1), cos(a1), ...]
        pe = torch.stack(
            (angles.sin(), angles.cos()),
            dim=-1,
        ).flatten(start_dim=-2)

        # Handles odd d_model values as well.
        pe = pe[..., :D]

        return x + pe
x = x.transpose(1, 2)
patch_tokens = self.patchify(x).transpose(1, 2)
if masks is not None:
patch_masks = make_patch_mask(masks, self.patch_size)
else:
patch_masks = None
patch_tokens = self.positional_encoding(patch_tokens, freqs)
cls_token = self.cls_token.expand(B, -1, -1)
if self.n_reg_tokens > 0:
reg_tokens = self.reg_tokens.expand(B, -1, -1)
all_tokens = torch.cat([cls_token, reg_tokens, patch_tokens], dim=1)
else:
all_tokens = torch.cat([cls_token, patch_tokens], dim=1)
if masks is not None:
all_token_masks = torch.cat(
[self.special_token_masks.expand(B, -1), patch_masks], dim=1
)
attn_masks = all_token_masks[:, None, None, :].bool()
else:
attn_masks = None
for layer in self.transformer:
all_tokens = layer(all_tokens, attn_mask=attn_masks)
all_tokens = self.final_norm(all_tokens)注意 make_patch_mask 的语义:一个 patch 只有在 16 个采样点全部有效时才算有效;无效 patch 仍保留在输出里,但会作为注意力 mask 被排除。这保证了变长输入时 padding 不会污染有效 token,也解释了为什么推理时 L 必须是 16 的正整数倍。
3.4 数据与训练:1.16 万小时,两个数量级的差距
预训练数据全部来自人体可穿戴 IMU,由三个公开数据集筛选而来:
| 来源 | 原始规模 | 筛选后 | 传感器位置 | 备注 |
|---|---|---|---|---|
| Capture24 | 3883 h,151 人 | 2410 h | 手腕 | 只有三轴加速度,陀螺仪通道补零 |
| SHL | SHL 2026 训练 + 验证 | 1138 h | 手机:髋、躯干、手、包 | 6 轴,未额外过滤 |
| PAAWS-Lab | 252 人 × 4 h,20 个 IMU | 8069 h | 腰、手腕、大腿、脚踝 | 滤掉静态段与标注不一致的样本 |
| 合计 | — | 11.6k h | — | 6 轴(部分通道补零) |
11.6k 小时大约是 484 天;论文强调这比 RelCon、Yuan et al. 等工作用的 70 万到 80 万人·天少两个数量级。数据筛选的细节在附录 B:Capture24 去掉采样率不是 100 Hz 的记录和无效标注;PAAWS 去掉 352 个传感器朝向有问题的文件、3 个采样率异常的文件,以及线加速度低于 0.30 m/s²、角速度低于 0.08 rad/s 的静态段。
训练时,每条序列切成不重叠的 1024 帧窗口,每个窗口生成 2 个全局视图和 6 个局部视图;全局视图最多 1024 帧,局部视图最多 512 帧,重采样上采样后超出的帧直接丢弃。优化器是 AdamW,1000 步线性 warmup,峰值学习率 ,余弦退火,weight decay 0.05,梯度裁剪 3.0,训练 60 个 epoch。batch size 1536,在 6 张 H100 上跑 11 小时(85M)或 6 小时(6M)。
3.5 实验:冻结骨干,四类任务
论文的评估有一个共同点:绝大多数结果用的是冻结骨干 + 轻量探测头。HAR 用 2 层 MLP,MoCap 用 MLP 或 2 层 Transformer,机器人里程计用 3 层 MLP(0.66M)或 2 层 Transformer(6.96M),骨干都不更新。只有 MoCap 的最后一行的 MLP† 是微调了骨干。这让数字更能说明「特征本身有多好」,而不是「微调能救多少」。
HAR:七个数据集平均 89.73。 论文在 MotionSense、HAPT、HHAR、DSADS、WEAR、OPPORTUNITY、Shoaib 七个数据集上做 leave-one-subject-out 交叉验证,报告 macro F1。多传感器数据集先对每个传感器单独提特征,再拼接后进 MLP。
| 方法 | MoSense | HAPT | HHAR | DSADS | WEAR | OPPO. | Shoaib | 平均 |
|---|---|---|---|---|---|---|---|---|
| DeepConvLSTM(监督) | 93.39 | 82.00 | 91.90 | 83.25 | 75.43 | 40.88 | 97.13 | 80.57 |
| TSF(监督 SOTA) | 97.34 | 85.89 | 95.81 | 89.70 | N/A | 52.44 | 99.35 | 86.76 |
| SimCLR*(自监督) | 96.08 | 80.56 | 87.56 | 91.56 | 88.48 | 43.50 | 99.29 | 83.86 |
| RelCon(惯性 FM) | 81.93 | 55.75 | 70.57 | 81.04 | 81.55 | 19.80 | 97.32 | 69.64 |
| TimesFM 3.0(通用时序 FM) | 85.64 | 63.30 | 82.97 | 75.09 | 78.92 | 33.50 | 93.61 | 73.29 |
| IMUDINO-6M | 97.91 | 87.56 | 95.33 | 93.24 | 91.28 | 53.54 | 99.58 | 88.35 |
| IMUDINO-85M | 98.54 | 89.02 | 96.00 | 94.13 | 92.34 | 58.40 | 99.68 | 89.73 |
两个观察。第一,6M 版本已经在平均分上超过所有监督基线(88.35 vs 86.76),85M 再把差距拉到 2.97 个点;在 OPPORTUNITY 这种类别不平衡、传感器多的数据集上,提升最明显(52.44 → 58.40)。第二,通用时序基础模型在 HAR 上明显水土不服:TimesFM 3.0 只有 73.29,Chronos-2 只有 66.36——时序预测的预训练目标和「动作语义」并不是一回事,这也反过来说明 IMU 需要自己的预训练目标。
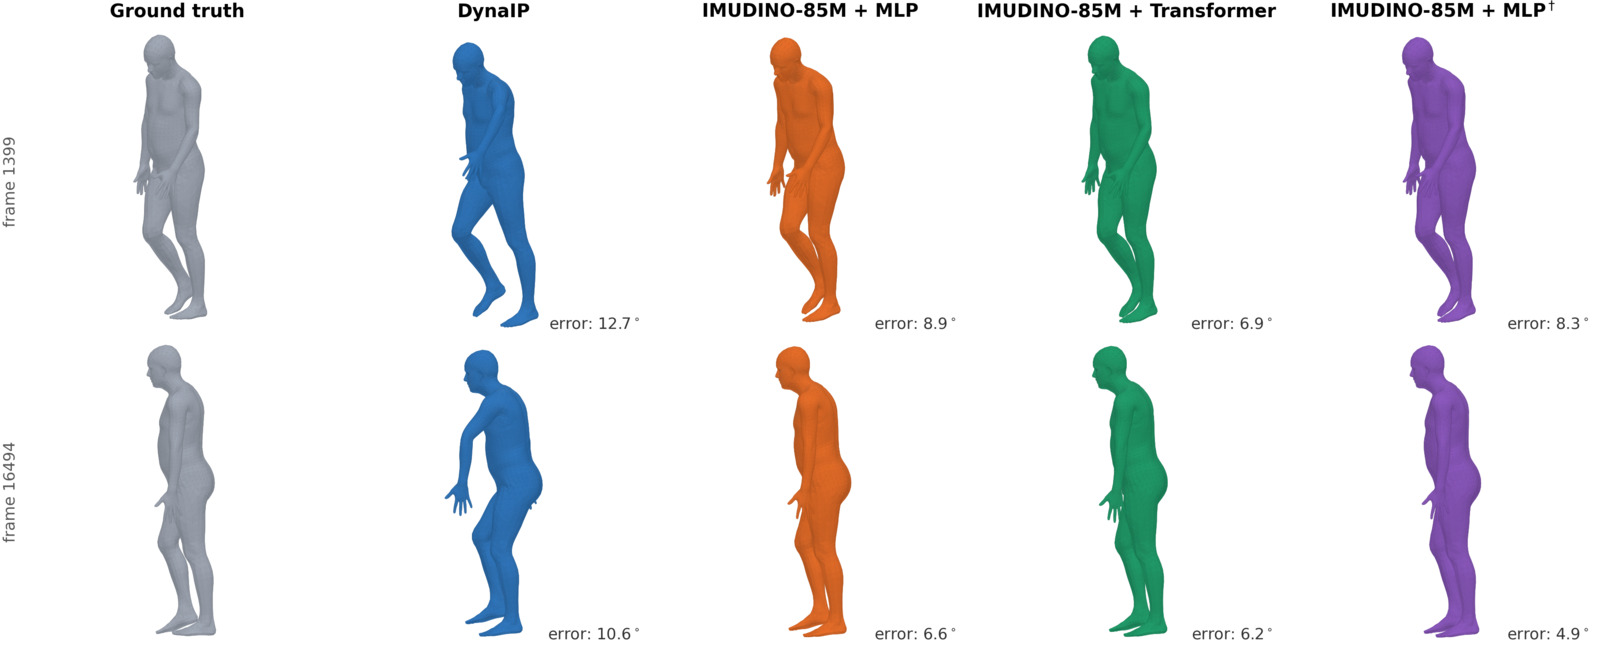
动作捕捉:冻结特征到 TIP 水平,微调后仍不及 DynaIP[9]。 实验用 AnDy、UNIPD、CIP、Virginia Natural Motion 四个数据集,遵循 DynaIP 的 Xsens-only 协议;输入包含一个头戴 IMU——这个位置在预训练数据里没见过。由于 MoCap 数据集通常没有原始陀螺仪,论文用 SO(3) 序列的有限差分合成陀螺仪通道。每个传感器的 patch token 直接按通道拼接,不做人体骨骼先验,然后用 MLP 或 Transformer 解码 16 个关节的 root-relative 6D 姿态,损失是普通 MSE。
| 方法 | 平均 SIP↓ | 平均角度↓ | 平均位置↓ |
|---|---|---|---|
| DIP(监督) | 18.99 | 7.93 | 7.19 |
| TransPose(监督) | 19.49 | 8.09 | 7.15 |
| TIP(监督) | 13.77 | 5.55 | 4.64 |
| PIP(监督) | 12.67 | 5.17 | 4.25 |
| DynaIP(监督 SOTA) | 10.86 | 4.49 | 3.79 |
| IMUDINO-85M + MLP(冻结) | 14.65 | 5.34 | 4.71 |
| IMUDINO-85M + Transformer(冻结) | 13.81 | 5.02 | 4.36 |
| IMUDINO-85M + MLP†(微调骨干) | 12.28 | 4.63 | 3.95 |
结论要分两层看。冻结骨干 + MLP 的 14.65° SIP 大致是 TIP 水平(13.77°),但还不如 PIP;换成 Transformer 探测头后到 13.81°,接近 TIP。微调骨干后到 12.28°,超过 PIP,但仍落后 DynaIP 1.4°。论文自己也承认这一点:IMUDINO 没有物理先验,也没有原始陀螺仪,能到这一步说明稠密特征里有丰富的人体运动信息,但要成为 HPE 的 SOTA,还需要任务特定的解码器和物理约束。
机器人里程计:冻结骨干,跨形态。 这是全文最能说明「通用性」的实验。IMUDINO 的预训练数据全是人体可穿戴 IMU,没有见过任何机器人;任务却是 2026 TartanIMU Challenge 的机器人里程计[10],覆盖汽车、四足狗、无人机和人形四个平台。骨干完全冻结,只训练 MLP 或 Transformer 探测头回归三维机体系速度;训练用 1 秒窗口、0.2 秒步长(5 倍重叠),评估用官方 1 秒不重叠窗口。
| 方法 | Car AVE | Dog AVE | Drone AVE | Human AVE | 平均 AVE↓ | 平均 ATE20↓ | Score↓ |
|---|---|---|---|---|---|---|---|
| TartanIMU*(平台无关) | 0.852 | 0.425 | 1.374 | 0.235 | 0.721 | 2.206 | 0.872 |
| TartanIMU†(平台专家) | 0.199 | 0.129 | 0.966 | 0.107 | 0.350 | 1.116 | 0.429 |
| IMUDINO-85M + MLP* | 0.200 | 0.123 | 0.543 | 0.132 | 0.249 | 1.012 | 0.333 |
| IMUDINO-85M + Transformer* | 0.141 | 0.092 | 0.499 | 0.105 | 0.209 | 0.854 | 0.280 |
平台无关的单一 IMUDINO + Transformer 在四个平台上的 AVE 都优于 TartanIMU 的平台专家,平均 AVE 低 40%(0.209 vs 0.350)。唯一的例外是人形平台的 ATE20:IMUDINO 是 0.872 m,TartanIMU 专家是 0.814 m,专家略胜。这个例外就摆在表 3 里,论文没有解释为什么人形平台的位置误差反而更高。
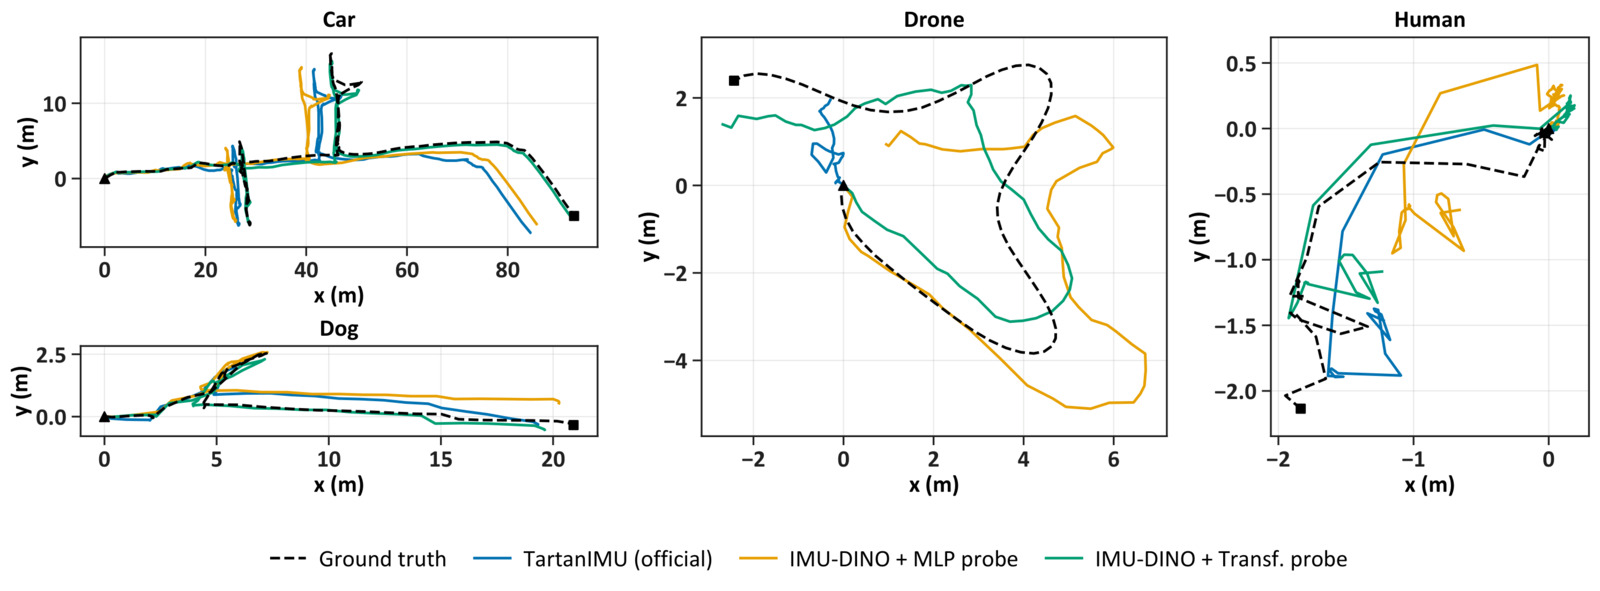
健康、步态与个性化 HAR。 论文在四个健康/步态数据集上做了线性探测:GOTOV 的 activity intensity 回归、UniMiB-SHAR 的跌倒检测、Daphnet 的帕金森冻结步态检测、whuGAIT 的步态识别。数字如下:
| 任务 | 指标 | 官方基线 | IMUDINO-6M | IMUDINO-85M |
|---|---|---|---|---|
| GOTOV | RMSE↓ / R²↑ | 1.35 / 0.45 | 0.96 / 0.58 | 0.94 / 0.59 |
| UniMiB-SHAR | HAR Acc↑ | 56.58 | 83.96 | 84.78 |
| UniMiB-SHAR | Fall Acc↑ | 97.05 | 99.59 | 99.81 |
| Daphnet FOG | Specificity↑ | 0.869 | 0.908 | 0.936 |
| Daphnet FOG | Sensitivity↑ | 0.781 | 0.671 | 0.551 |
| whuGAIT | Acc↑ / EER↓ | 93.75 / — | 96.55 / 3.24 | 97.41 / 2.92 |
大多数指标是提升的,但 Daphnet 的灵敏度从 0.781 掉到 0.551,这是表中唯一明显退化的指标。论文只写了「competitive」,没有讨论这个 trade-off:特异性提高、灵敏度下降,意味着模型更倾向于把冻结步态判成正常,漏检变多。对临床筛查来说,这未必是可以接受的交换。
ActivitySeeker 是一个在线个性化 HAR 系统:先用特征聚类发现动作模式,再让用户给簇打标签,最后训练轻量分类器。论文把它的 ResNet 特征提取器换成 IMUDINO-6M(参数量相近),在 13 个用户上平均:数据利用率 76.5%(ResNet 67.4%)、协同标注准确率 98.7%(98.8%)、HAR mF1 95.3(ResNet 89.5)。85M 版本再把 mF1 提到 96.8、数据利用率提到 77.3%。这说明更好的全局特征能让「用户标注」这件事更省力。
变长与变采样率。 这是 IMUFormer 的频率感知位置编码最直接的检验。论文在 MotionSense 上把输入窗口设为 {1.28, 2.56, 5.12, 10.24} 秒,把采样率重采样到 {25, 50, 100, 200} Hz,用 85M 冻结骨干 + 2 层 MLP 探测,得到 16 个 mF1:
表 10 的数据重画:横轴是采样率,纵轴是窗口长度。默认停在 2.56 s / 50 Hz,这是 TSF 报告监督 SOTA 的设定。
论文的结论是:采样率变化对 mF1 影响很小,尤其是 5.12 s 和 10.24 s 的长窗口;窗口越长,mF1 略好,符合预期。整张表里最差的是 1.28 s / 25 Hz 的 97.40,仍高于 TSF 的 97.34。这个结果同时验证了频率感知位置编码和训练时的重采样增强——如果位置编码还是「第几个 token」,25 Hz 和 200 Hz 的同一段动作会落在完全不同的位置编码上,模型不可能这么稳。另外一个工程上的选择是窗口策略:TartanIMU 训练时用 1 秒不重叠窗口,AVE 是 0.283(MLP)/ 0.262(Transformer);改成 0.2 秒步长的 5 倍重叠后,降到 0.249 / 0.209。评估协议不变,所以这 12% 到 20% 的提升完全来自训练时看到了更多窗口起点。
消融:每个设计值多少。 所有消融都用 85M 骨干,报告三个任务的汇总指标:HAR 平均 mF1、MoCap 平均 SIP、机器人里程计平均 AVE。
| 设置 | HAR mF1↑ | MoCap SIP↓ | Robot AVE↓ |
|---|---|---|---|
| 去掉 patch 级目标 | 89.41 | 15.21 | 0.293 |
| 去掉 KoLeo | 89.40 | 14.50 | 0.252 |
| 去掉 scaling | 89.63 | 14.87 | 0.257 |
| 去掉 rotation | 88.66 | 15.67 | 0.253 |
| 去掉 resampling | 88.86 | 14.64 | 0.255 |
| 去掉 channel masking | 89.04 | 14.02 | 0.258 |
| 去掉频率感知 PE | 89.60 | 14.51 | 0.260 |
| 随机初始化,冻结骨干 | 65.32 | 17.34 | 0.854 |
| 随机初始化,可训练骨干 | 83.70 | 14.89 | 0.534 |
| 完整 IMUDINO-85M | 89.73 | 14.65 | 0.249 |
几条值得注意的:
- 预训练本身贡献最大。随机初始化 + 冻结骨干只有 65.32 mF1,机器人 AVE 0.854;完整模型是 89.73 / 0.249。随机初始化 + 可训练骨干能到 83.70 / 0.534,说明监督微调能补一部分,但补不回自监督特征的质量。
- patch 级目标主要提升稠密特征。去掉后 MoCap SIP 从 14.65 涨到 15.21(变差 0.56°),机器人 AVE 从 0.249 涨到 0.293(变差 18%),HAR 只掉 0.32。这符合预期:iBOT++ 本来就是为稠密任务设计的。
- 旋转增强是 HAR 的关键。去掉后 HAR 掉 1.07 个点,是所有增强里最大的;MoCap 也掉 1.02°。说明「传感器朝向不变性」对全局动作识别非常重要。
- 有些设计是 trade-off。去掉 KoLeo 后 MoCap 反而好 0.15°,去掉通道掩码后 MoCap 好 0.63°,但 HAR 分别掉 0.33 和 0.69;论文选择保留它们,理由是 HAR 更好、训练更稳定。频率感知 PE 也是类似:HAR 和机器人里程计受益,MoCap 反而好 0.14°。
- 重采样主要保 HAR。去掉后 HAR 掉 0.87,MoCap 和机器人里程计几乎不变;但它是变采样率能力的来源,所以保留。
全局与稠密:一套变换,两种不变性。 第 3.3 节留下一个问题:既然旋转增强让 CLS 对朝向不变,为什么稠密特征还能做动作捕捉?论文用余弦相似度曲线回答(图 11):把输入绕 x 轴旋转 0° 到 180°,分别看 CLS token 和 patch token 与未旋转输入的相似度。
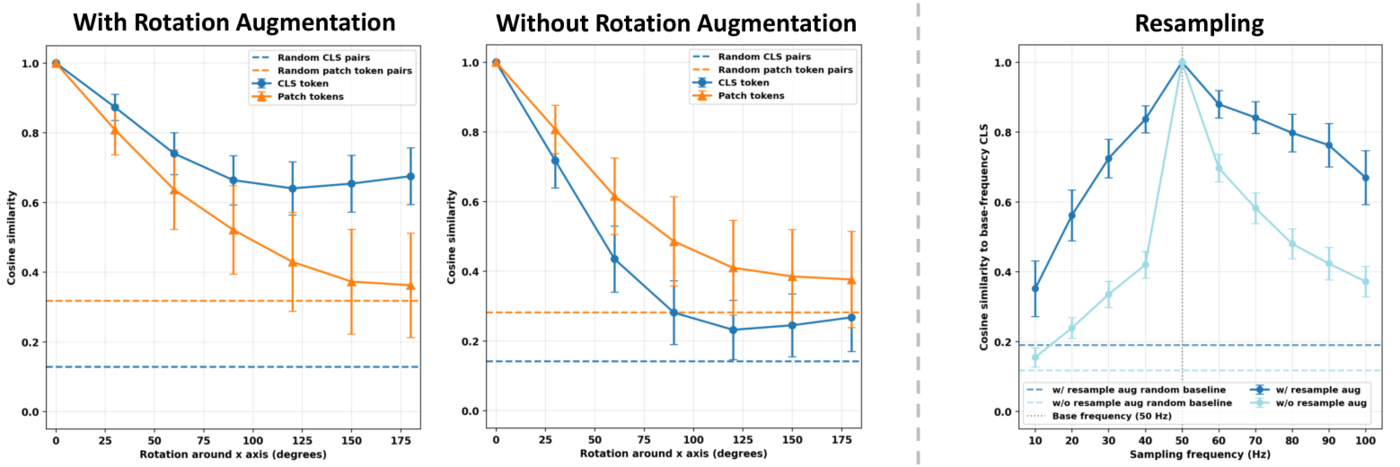
读法很清楚:旋转增强把不变性写进了 CLS,但没有写进 patch token。patch token 在 180° 旋转后相似度掉到接近随机,说明它仍然编码「哪边朝上」——这正是动作捕捉需要的局部信息。重采样图同理:带增强的模型在 10 到 100 Hz 上都能保持较高的 CLS 相似度,不带增强的模型只在训练采样率(50 Hz)附近表现好。这解释了 IMUDINO 为什么能同时做 HAR 和 MoCap:它不是让所有特征都变得不变,而是让全局特征不变、稠密特征敏感。
规模:HAR 和里程计继续涨,MoCap 在 25M 饱和。 论文比较了 2.7M、6M、25M、85M 四个规模。HAR mF1 从 87.6 单调涨到 89.7;机器人里程计 Score 从 0.397 降到 0.333;MoCap SIP 则在 25M 达到最好(13.8°),85M 反而回到 14.65°。
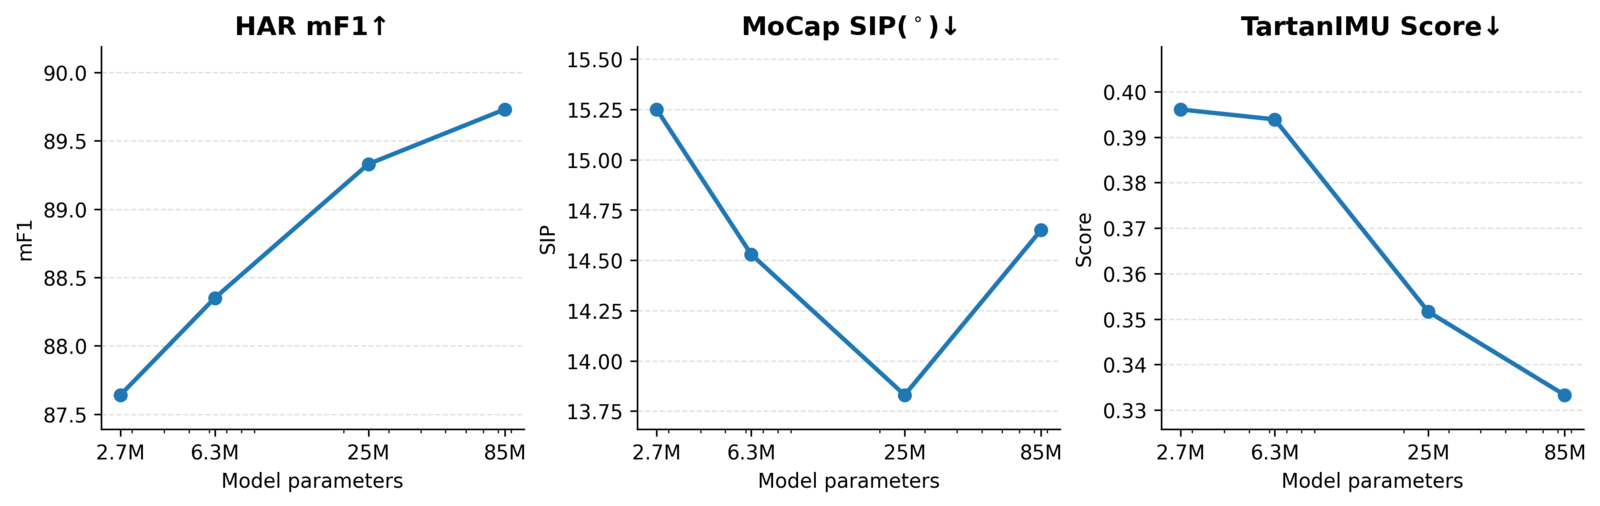
这个结果对实践者有直接含义:如果你做 HAR 或里程计,85M 值得;如果你做动作捕捉,25M 可能是更好的性价比点,至少在这个探测协议下是这样。
3.6 IMUDINO 的局限
论文没有单独的局限性一节,下面几条一部分来自正文的自我限定,一部分是我自己补的。
论文自己提到的:动作捕捉不是 SOTA,微调骨干后的 12.28° SIP 仍落后 DynaIP 的 10.86°,论文明确说需要任务特定的解码器和物理先验才可能追平;规模收益不均匀,MoCap 在 25M 饱和、85M 反而变差,论文把它列为开放问题;预训练数据只有人体可穿戴 IMU,机器人里程计是完全 OOD 的迁移,论文把它当作优点展示,但也意味着模型没有见过轮式、足式、飞行器的真实动力学。
我自己补的:
- 没有训练代码。官方仓库只有
imudino.py、model_factory.py、example_forward.py和一个检查点;DINO/iBOT++/KoLeo 的具体实现、五种变换的代码、数据筛选脚本都没有。论文附录 A.1 给了变换的采样分布,但重现已有的预训练仍然要从头写一遍。这对「基础模型」的生态是明显的短板。 - 绝大多数结果是冻结探测。HAR 用 2 层 MLP,里程计用 0.66M/6.96M 的探测头,只有 MoCap 试了微调骨干。论文没有回答「全量微调能不能把 HAR 或里程计再推高」,也没有给出微调的计算成本。
- Daphnet 的灵敏度下降没有被讨论。特异性 0.869 → 0.936 的代价是灵敏度 0.781 → 0.551;对跌倒/冻结步态检测,漏检的代价通常比误报高。论文只写了「competitive」,这是我认为需要补做的分析。
- TartanIMU 只用了验证集。官方测试集标签在写作时还没发布,所以表 3 是验证集排名;等测试集放出后,名次可能变化。论文对此有说明,但读者容易忽略。
- 数据与隐私。预训练数据来自 151 + 252 名受试者的人体运动记录,论文没有讨论数据许可、隐私或人口统计学偏差;这些数据训练出的基础模型如果直接用于健康监测,偏差会被继承。
- 85M 的部署成本。检查点约 340 MB,推理要跑 12 层 ViT;6M 版本在 HAR 上只低 1.38 分,在里程计上 AVE 高 0.040 m/s。边缘设备上 6M 可能更现实,但论文没有给出延迟/功耗对比。
四、对照:两种老师,各自教会了什么
把两篇放在一起,最值得对照的不是网络结构,而是「老师」的性质。
| 维度 | SSIO | IMUDINO |
|---|---|---|
| 监督 | 预积分速度变化量 | 视图间的 CLS/patch 一致性 |
| 老师 | 物理积分器(有单位、有误差模型) | EMA 学生(无物理意义,只防坍缩) |
| 标签 | 每窗口 3 维 | 每样本 1 个全局分布 + 每 patch 一个分布 |
| 所学 | 平台相关的运动模式与积分残差 | 跨平台、跨任务的语义表示 |
| 数据 | 六平台分别训练 | 三数据集混合预训练 |
| 迁移 | 跨平台负迁移(1.9–34×) | 人体 → 机器人正迁移 |
| 失败 | 高动态、零偏、姿态误差 | 稠密精度、临床灵敏度、OOD 动力学 |
| 开源 | 训练 + 评测 + 检查点 | 仅推理 + 检查点 |
第一,监督信号的「结构」决定了它能被分析到什么程度。 SSIO 的 有明确的物理单位,所以论文能推导它的协方差、分析零偏和姿态误差如何漏进目标、解释为什么学生能在长时评估中反超老师。IMUDINO 的自蒸馏信号没有单位,它只保证「不同视图的表示一致」;论文能分析旋转/重采样如何改变 CLS 相似度,但没法像 SSIO 那样给出误差传播公式。这不是方法优劣,而是两类监督信号的可解释性上限不同。
第二,老师的「短视」与「不变」带来相反的迁移行为。 SSIO 的老师是短窗口积分器,它编码的是平台在这一小段运动里的动力学;学生学得越好,越绑定这个平台,所以跨数据集迁移全面负收益(1.9 到 34 倍)。IMUDINO 的老师是 EMA 学生,视图变换刻意抹掉朝向、采样率、幅值、时间尺度这些平台相关因素;学生学的是「什么在变、什么不变」,所以人体数据预训练出来的特征能迁到机器人,甚至超过平台专家。一个把平台信息学进去,一个把平台信息赶出去——这是两篇论文最根本的分歧。
第三,评估哲学不同。 SSIO 只关心轨迹误差(AVE/ATE),它的成功标准是「逼近同架构监督基线」;IMUDINO 关心多任务冻结探测,它的成功标准是「一个骨干在四类任务上都不掉队」。前者的数字更硬,后者的覆盖面更广。两者都诚实报告了失败:SSIO 在 Blackbird 上 ATE 从 6.39 涨到 18.39 m;IMUDINO 在 Daphnet 上灵敏度从 0.781 掉到 0.551,MoCap 也没超过 DynaIP。
第四,工程成熟度差距明显。 SSIO 放出了完整训练、评测、六个平台的 recipe 和检查点,读者可以真的复现;IMUDINO 只放推理,训练代码、数据管线、变换实现都没有。对想跟进的读者,SSIO 是「可复现的研究」,IMUDINO 是「可使用的模型」——后者仍然有价值,但没法在新数据上继续预训练。
如果要在两者之间做选择,我的建议很直接:
- 新平台、只有 IMU、要一条轨迹:选 SSIO。它的 Stage-1 不需要任何速度/位姿标签,只要一段正常运行的 IMU 记录;有腿式本体感知就接上,轨迹一致性不够再加一轮 PGD。
- 多任务、边缘部署、标注预算低:选 IMUDINO。一次预训练,冻结骨干接线性/MLP probe;HAR、步态、动作捕捉、里程计都能试,6M 版本适合边缘,85M 版本适合精度优先。
- 两者组合:一个自然的想法是先用 IMUDINO 的通用特征初始化,再用 SSIO 的 损失在目标平台上做自监督微调——前者提供跨平台的先验,后者补上平台动力学。两篇论文都没有做这个实验,所以这只是方向,不是结论。
五、结论与展望
两篇论文的共同结论是:无标注 IMU 足够训练出有用的模型,前提是监督信号本身是良定义的。 SSIO 把「速度变化量」这个物理上可观测、且对常值偏置不变的量当作目标;IMUDINO 把「同一段运动的不同视图应该一致」这个统计假设当作目标。前者窄而深,后者宽而浅;一个在六个平台上把里程计做到接近监督,一个用 1.16 万小时数据把四类任务收进一个骨干。
对做惯性相关工作的读者,我觉得有三点可以直接拿走:
- 先问「老师是谁」,再问「网络多大」。 SSIO 的老师是积分器,误差随窗口线性增长,所以学生必须学会平均噪声和记忆平台运动模式;IMUDINO 的老师是 EMA 学生,监督信号是视图不变性,所以学生学到的是语义而不是动力学。老师的性质决定了学生能学什么,换网络结构通常救不了错误的监督信号。
- 数据多样性比数据规模更值得投资。 SSIO 的六个平台覆盖行人、无人机、四足、人形,才让「跨平台差距」这个分析成立;IMUDINO 的 11.6k 小时比 RelCon 少两个数量级,但传感器位置、采样率、动作类型足够多样,效果反而更好。
- 开源程度决定后续生态。 SSIO 的完整训练代码让读者能复现、能改、能在新平台上重训;IMUDINO 只放推理,用起来方便,但没法继续预训练。对基础模型来说,后者是明显的遗憾。
未来方向也清楚:SSIO 想把参考姿态从训练里去掉、在线估计零偏、训练跨形态的统一模型;IMUDINO 想继续扩大模型和数据、把「全局不变、稠密敏感」的分工做成可调的旋钮。把两者接起来——用通用表示做先验、用物理自监督做平台适配——是我最想看到的下一步。
六、上手
6.1 SSIO:完整训练与评测
官方仓库提供了完整的训练、评测和六个数据集的 recipe。环境要求 Python ≥ 3.10、PyTorch < 2.14(2.14 会破坏 PyPose 的预积分,实测 2.5.1 可用)。
安装命令(官方 README,conda + pip)
conda create -n ssio python=3.10
conda activate ssio
pip install -r requirements.txt
数据从 $DATA_ROOT 读取,输出写到 $EXP_DIR(默认 ./experiments)。TLIO、EuRoC、Blackbird、GrandTour 需要按 README 的链接自行下载;MIPO 和 Humanoid 由作者发布在 Hugging Face:
下载作者发布的数据集(官方 README)
export DATA_ROOT=/path/to/datasets

hf download Open-IO/humanoid-g1-odometry --repo-type dataset \
    --local-dir $DATA_ROOT/humanoid_g1
hf download Open-IO/mipo-go1-odometry --repo-type dataset \
    --local-dir $DATA_ROOT/mipo_hdf5
仓库自带一个 10 s 的 EuRoC MH_02_easy 切片,可以在 CPU 上把三个阶段各跑一步,用来确认环境:
Quick Start:积分自监督 → 位姿图蒸馏 → 评测(官方 README)
python train_ssio.py network=airio_imu_only \
    'hydra.searchpath=[file://tests/fixtures/config]' \
    dataset@train_dataset=EuRoC_Smoke_Train dataset@eval_dataset=EuRoC_Smoke_Valid \
    train.epoch=1 train.batch=4 train.max_train_steps=2 train.dv_imu_input=raw \
    'meta.device=${as_device:cpu}' wandb.mode=disabled \
    hydra.run.dir=./experiments/quickstart/ssio

python train_pgd.py network=airio_imu_only graph=dense_imupgo \
    'hydra.searchpath=[file://tests/fixtures/config]' \
    dataset@train_dataset=EuRoC_Smoke_Train dataset@eval_dataset=EuRoC_Smoke_Valid \
    train.epoch=1 train.batch=4 train.max_train_steps=2 train.dv_imu_input=raw \
    train.network_factor_sigma=1.0 \
    train.resume_from=file:./experiments/quickstart/ssio/checkpoint_00002.pt \
    'meta.device=${as_device:cpu}' wandb.mode=disabled \
    hydra.run.dir=./experiments/quickstart/pgd

python evaluate.py ./experiments/quickstart/pgd
复现论文的某一行,用 Config/experiment/<dataset>/ 里的 recipe;每个 recipe 的头部都标了对应的 Hugging Face run 和论文/检查点分数:
复现一个完整实验(以 EuRoC 为例,官方 README)
python train_ssio.py +experiment=euroc/ssio
python train_pgd.py +experiment=euroc/ssio_pgd train.resume_from=file:<SSIO_RUN>/best_model.pt
python evaluate.py <RUN_DIR> --checkpoint best_model.pt --data Config/dataset/EuRoC_Test.yaml
也可以直接下载作者发布的检查点做评测:
下载并评测 Hugging Face 检查点(官方 README)
hf download Open-IO/SSIO --include "stage1/189uubgg/*" --local-dir ckpts
python evaluate.py ckpts/stage1/189uubgg --checkpoint best_model.pt --data Config/dataset/EuRoC_Test.yaml参数和论文概念的对应关系:train.dv_imu_input 选老师积分的 IMU 流(corrected / raw),loss=ssio_variance 或 loss=ssio_dv_1_3_9_27 选积分损失的稠密/固定间隔形式,train.regularization_gate=imu 打开静止正则,graph=sparse_imupgo / dense_imupgo 选 PGD 的求解后端。注意 train.network_factor_sigma 是 PGD 必填项,论文的 recipe 在 0.2 到 2.0 之间。
6.2 IMUDINO:推理与检查点
官方仓库提供了推理代码和 85M 检查点,没有训练代码。环境要求 Python 3.10+、PyTorch 和 timm 1.0.30(README 测试于 Python 3.12、PyTorch 2.15.0、timm 1.0.30)。
安装与下载检查点(官方 README)
pip install -r requirements.txt

# 方式一:huggingface-cli(pip install "huggingface_hub[cli]")
huggingface-cli download Octopus1/IMUDINO imudino.pt --local-dir .

# 方式二:直接下载
wget https://huggingface.co/Octopus1/IMUDINO/resolve/main/imudino.pt
仓库自带一个合成数据的示例,可以直接确认环境和输出形状:
运行示例(官方 example_forward.py)
python example_forward.py --device cpu
# 输出:
# cls_token: (2, 768)
# reg_tokens: (2, 4, 768)
# patch_tokens: (2, 64, 768)
在自己的代码里调用,输入是 [B, L, 6],通道顺序是加速度计 XYZ 在前、陀螺仪 XYZ 在后;L 必须是 16 的正整数倍;freqs 是每个样本的采样率(Hz),必须是正数;masks 可选,True 表示有效、False 表示 padding:
最小推理代码(官方 README)
import torch
from model_factory import imuformer_huge_patch16

model = imuformer_huge_patch16()
model.load_state_dict(
    torch.load("imudino.pt", map_location="cpu", weights_only=True), strict=True
)
model.eval()

with torch.inference_mode():
    features = model({
        "imu_data": torch.randn(2, 1024, 6),
        "freqs": torch.tensor([100.0, 200.0]),
        "masks": None,
    })
几个使用上的注意点:
masks的粒度是采样点,但注意力 mask 的粒度是 patch:一个 patch 只有在 16 个采样点全部有效时才算有效。padding 的 patch 仍会出现在patch_tokens里,池化或做下游头时要自己排除。- 输出只有最后一层、经过 LayerNorm 的 token:
cls_token是序列表示,reg_tokens是 4 个寄存器,patch_tokens是每个 16 采样片段的稠密表示。做 HAR 一般用 CLS,做动作捕捉/里程计一般用 patch token 的均值或全部 token。 - 仓库的工厂函数叫
imuformer_huge_patch16(),但 README 明确说这是历史命名,实际是 85M 的 base 规模(768 维、12 层、24 头);不要被「huge」误导。 - 训练代码没有开源。如果你想在自己的数据上继续预训练,需要按论文第 3.1 节和附录 A.1 重新实现 DINO/iBOT++/KoLeo 与五种变换;仓库只保证推理与检查点加载。
参考
- Qiu, Chen, Cort, Huang, Zhao, Abbeel, Duan, Sreenath, Liu, Sferrazza, Geng, Scherer, Shi. SSIO: Self-Supervised Inertial Odometry. arXiv 2610.25988, 2026. arXiv · 代码
- Ye, Zhang, Wang, Jian, He, Wan, Wang, Liu, Sun, Mei, Yu, Shi. IMUDINO: Self-distilled Foundation Model for Inertial Sensing. arXiv 2611.07437, 2026. arXiv · 代码
- Yan, Herath, Furukawa. RoNIN: Robust Neural Inertial Navigation in the Wild: Benchmark, Evaluations, and New Methods. ICRA 2020. arXiv · 代码
- Liu, Caruso, Ilg, Dong, Mourikis, Daniilidis, Kumar, Engel. TLIO: Tight Learned Inertial Odometry. IEEE RA-L 2020. arXiv · 代码
- Qiu, Xu, Chen, Zhao, Geng, Scherer. AirIO: Learning Inertial Odometry with Enhanced IMU Feature Observability. arXiv 2501.15659, 2025. arXiv · 代码
- Caron, Touvron, Misra, Jégou, Mairal, Bojanowski, Joulin. Emerging Properties in Self-Supervised Vision Transformers. ICCV 2021. arXiv · 代码
- Zhou, Wei, Wang, Shen, Xie, Yuille, Kong. iBOT: Image BERT Pre-Training with Online Tokenizer. ICLR 2022. arXiv · 代码
- Oquab, Darcet, Moutakanni, Vo, Szafraniec, Khalidov, Fernandez 等. DINOv2: Learning Robust Visual Features without Supervision. TMLR 2024. arXiv · 代码
- Zhang, Xia, Chu, Yang, Wu, Pei. Dynamic Inertial Poser (DynaIP): Part-Based Motion Dynamics Learning for Enhanced Human Pose Estimation with Sparse Inertial Sensors. CVPR 2024. arXiv · 代码
- Zhao, Zhou, Blanchard, Qiu, Wang, Scherer. Tartan IMU: A Light Foundation Model for Inertial Positioning in Robotics. CVPR 2025. CVF · 代码